Ein Freigabeklick belegt nicht, dass eine prüfende Person eine falsche KI-Empfehlung erkannt hat. Bevor Sie einen KI-gestützten Ablauf ausweiten, prüfen Sie, ob seine Oberfläche richtige Hinweise von plausiblen Fehlern unterscheidbar macht. Vergleichen Sie Darstellungsvarianten anhand vergleichbarer Fälle, behalten Sie menschliche Entscheidungen ohne KI und reine Modellentscheidungen als Referenzen bei und messen Sie die Übernahme bekanntermaßen falscher Empfehlungen mit einem eigenen Nenner. Eine höhere Freigabequote kann bessere Unterstützung, stärkere Vorprägung durch die Empfehlung oder schlicht leichtere Fälle bedeuten.
Dieser Beitrag schlägt eine technische Untersuchung vor. Er berichtet weder gemessene Kundenergebnisse noch einen gesetzlich vorgeschriebenen Konformitätstest. Die Entscheidung betrifft die Freigabe einer konkreten Prüfoberfläche für definierte Aufgaben und Nutzergruppen — nicht die allgemeine Überlegenheit von Menschen oder KI.
Die Kontrollgrenze: Befugnis ist nicht Entscheidungsqualität
Ein funktionierendes Freigabeverfahren beantwortet, wer eine Aktion autorisieren darf und ob die Ausführung wartet. Es zeigt nicht, ob die Person die Belege verstanden hat. Behalten Sie die serverseitigen Kontrollen der Human-in-the-Loop-Freigabearchitektur bei. Ergänzen Sie die Bewertung der Interaktion vor der Autorisierung; ersetzen Sie die Ausführungssperre nicht durch eine Usability-Kennzahl.
Für Hochrisiko-KI-Systeme im jeweils einschlägigen Anwendungsbereich behandelt Artikel 14 des konsolidierten AI Act unter anderem das Bewusstsein für Automatisierungsbias, die Interpretation von Ausgaben sowie deren Nichtbeachtung oder Übersteuerung. Das begründet eine Untersuchung der Oberfläche, beweist aber nicht, dass eine bestimmte Bildschirmreihenfolge die Anforderungen erfüllt. Lassen Sie Einstufung, Rollen, aktuelle Änderungen, Anwendungszeitpunkte und sektorale Pflichten juristisch prüfen. Die Konsolidierung ist eine Dokumentationshilfe, nicht die authentische Amtsblattfassung. Dies ist keine Rechtsberatung.
Die Microsoft-Research-Leitlinien zur Mensch-KI-Interaktion unterstützen kontextrelevante Informationen, effizientes Verwerfen und effiziente Korrektur. Die Autoren betonen Zielkonflikte; sie belegen keinen universellen Vorteil einer Darstellung, die zuerst Belege zeigt. Das freiwillige NIST AI RMF, insbesondere Anhang C, betrachtet Mensch-KI-Konfigurationen kontextbezogen und beschreibt die Schwierigkeit, Ausgaben und Erklärungen sinnvoll zu vermitteln. Es ist keine EU-Rechtsgrundlage.
Fixieren Sie die Aufgabe vor der Oberfläche
Wählen Sie eine begrenzte Entscheidung, etwa die Zuordnung eines synthetischen Servicefalls zur richtigen Supportwarteschlange. Definieren Sie verfügbare Fakten, zulässige Aktionen, angemessene Eskalation und Folgen einer Fehlentscheidung. Fassen Sie Triage, Diagnose und Ausführung zunächst nicht in einem Erfolgslabel zusammen: Eine richtige Diagnose kann dennoch eine unzulässige Aktion auslösen.
Erstellen Sie unabhängig bewertete Referenzfälle. Fachliche Prüfer sollten die Referenzentscheidung ohne Kenntnis der getesteten Modellantwort festlegen. Bewahren Sie Meinungsverschiedenheiten und Begründungen auf. Fälle ohne belastbare Referenz gehören in eine eigene Gruppe mit einer Bewertungsregel für Mehrdeutigkeit und Eskalation, nicht stillschweigend in die Kategorie richtig oder falsch. Ein Modell darf seine eigene Empfehlung nicht zur Referenzwahrheit erklären.
Verwenden Sie richtige und gezielt falsche Empfehlungen. Wählen Sie realistische Fehler: eine plausible Zuordnung, die einem Quelldetail widerspricht, eine übersehene Ausnahme oder eine Empfehlung auf Basis eines veralteten Datensatzes. Kennzeichnen Sie eingebrachte Fehler im Studienmanifest. Sie zeigen Anfälligkeit unter kontrollierter Exposition, nicht die Fehlerhäufigkeit des Produktivmodells. Für betriebliche Schätzungen benötigen Sie zusätzlich einen repräsentativen Fallsatz; berichten Sie beide Verteilungen getrennt.
Gleichen Sie Fallsätze nach Aufgabentyp, Belegumfang, Mehrdeutigkeit und Konsequenz ab. Fixieren Sie Belege, Modellausgaben und Modellrevision vor dem Oberflächenvergleich. Erhält eine Variante kürzere Antworten oder genauere Empfehlungen, isoliert der Versuch die Darstellung nicht mehr. Dokumentieren Sie Oberflächenversion, Regelwerksrevision, Anzeigesprache und Barrierefreiheitseinstellungen als Teil der Versuchsbedingung.
Vier Vergleiche ohne Lerneffekt durch wiederholte Antworten
Die reine Modellreferenz bewertet die fixierte Empfehlung anhand der Referenzregeln ohne menschliche Korrektur. Im Versuchsarm ohne KI erhalten Menschen dieselben Aufgabenbelege, aber keine Empfehlung. Zwei unterstützte Arme vergleichen „Empfehlung zuerst“ mit „Belege zuerst“. Beide benötigen identische Informationen, Aktionen und Korrekturbefugnisse; nur die beabsichtigte Darstellungsänderung sollte abweichen.
Ordnen Sie Prüfende nach Möglichkeit innerhalb relevanter Erfahrungsgruppen zufällig den Varianten zu. Bei einem Vergleich innerhalb derselben Person müssen Sie die Reihenfolge ausbalancieren und disjunkte, vergleichbare Fallsätze verwenden: Niemand sollte denselben Fall zuerst ohne Unterstützung lösen und danach nochmals mit Empfehlung sehen. Rotieren Sie Fallsätze über andere Teilnehmende, damit Schwierigkeit und Oberfläche nicht dauerhaft gekoppelt sind. Berücksichtigen Sie wiederholte Entscheidungen derselben Person und gemeinsam verwendete Fälle in der Analyse; viele Klicks sind keine entsprechend vielen unabhängigen Prüfpersonen.
Definieren Sie, ob „Belege zuerst“ lediglich Bereiche umordnet oder eine vorläufige Entscheidung verlangt, bevor die Empfehlung sichtbar wird. Das sind unterschiedliche Eingriffe. Kennzeichnen Sie eine verpflichtende Vorentscheidung ausdrücklich und berücksichtigen Sie deren Zeitbedarf. Führen Sie diesen Zusatzschritt nicht nur in einem Arm ein, um anschließend den gesamten Effekt der visuellen Reihenfolge zuzuschreiben.
Nutzen Sie einen Pilotversuch, um unbrauchbare Aufgaben zu erkennen und die Streuung abzuschätzen. Planen Sie den Umfang anschließend anhand des kleinsten entscheidungsrelevanten Unterschieds und der akzeptablen Unsicherheit. Eine allgemeingültige Mindestzahl an Prüfenden gibt es nicht. Kleine Piloten können offensichtliche Mängel aufdecken, aber das Fehlen seltener schädlicher Übernahmen nicht nachweisen.
Oberflächenskizzen: Zugang statt Dekoration vergleichen
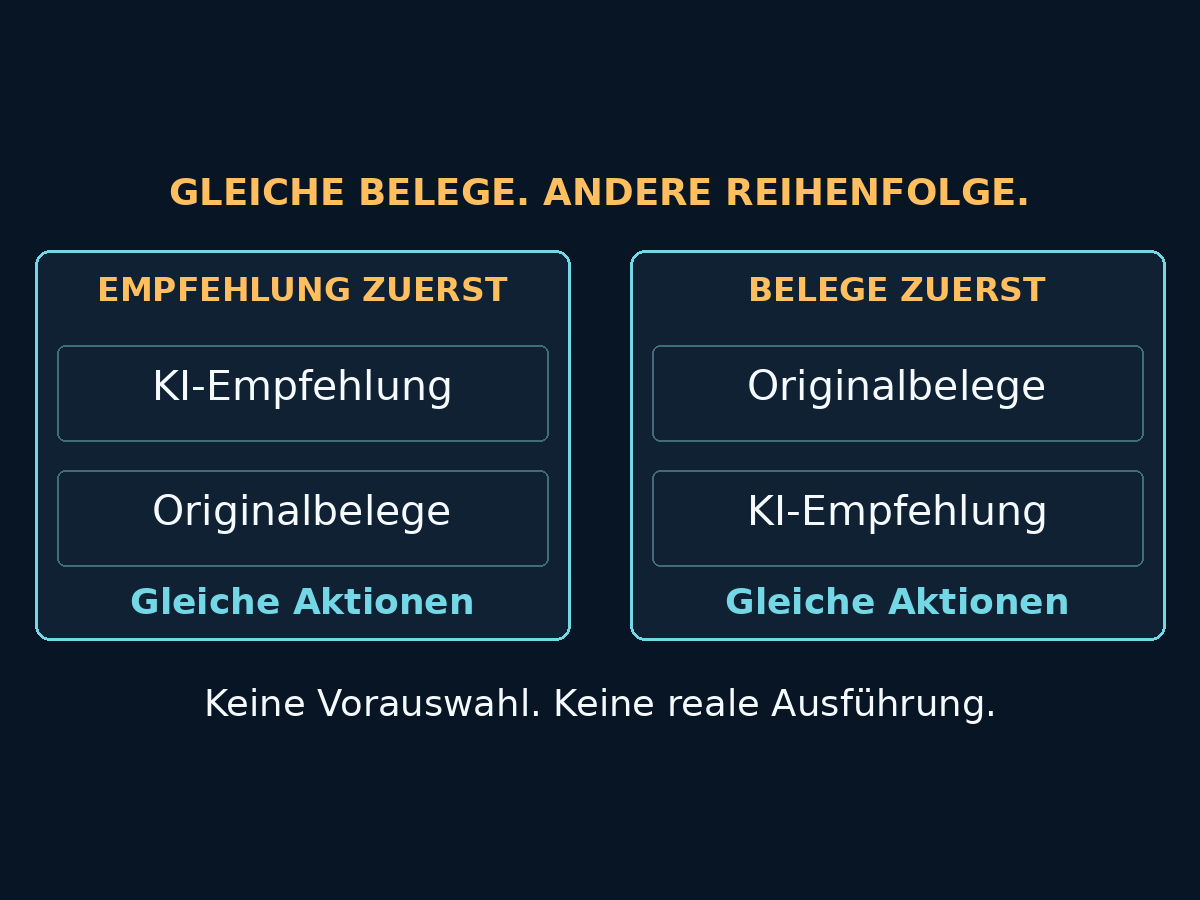
Die Skizzen isolieren die Reihenfolge der Bereiche. Die Variante „Belege zuerst“ erzwingt keine versteckte zusätzliche Bestätigung. Beide Varianten zeigen Originalbelege, widersprechende Fakten und dieselben Aktionen für Freigabe, Korrektur und Eskalation. Keine Aktion ist vorausgewählt. Halten Sie die Ausführung in einer Testumgebung, damit absichtlich falsche Empfehlungen weder Kunden noch Betriebssysteme erreichen.
Eine sichtbare Erklärung ist nicht automatisch ein brauchbarer Beleg. Flüssig formulierter generierter Text kann den Fehler lediglich wiederholen. Trennen Sie Quellfakten von generierter Begründung, ermöglichen Sie den Zugriff auf die Originalquelle und machen Sie fehlende Belege sichtbar. Wenn Sie einen Konfidenzwert anzeigen, dokumentieren Sie Bedeutung und Validierung für diese Aufgabe; überzeugende Modellsprache ist keine kalibrierte Wahrscheinlichkeit.
Entscheidungstabelle: den zu behebenden Fehler messen
| Fehlermodus | Messgröße und Nenner | Hypothese für die Überarbeitung | Aufwand oder Grenze |
|---|---|---|---|
| Falschen Rat übernehmen | Übernommene falsche Empfehlungen / gezeigte bekannte Falschempfehlungen | Widersprechende Belege direkt im Entscheidungsbereich zeigen | Kann die Prüfung verlangsamen; Nutzen erneut testen |
| Fehler erkennen, aber nicht beheben | Richtige Endentscheidungen / gezeigte bekannte Falschempfehlungen | Korrektur und nachgelagerte Wirkung verdeutlichen | Ablehnung allein ist keine richtige Lösung |
| Nützlichen Rat verwerfen | Verworfene richtige Empfehlungen / gezeigte richtige Empfehlungen | Leistungsgrenzen und Quellenstützung erklären | Ablehnung kann durch Fakten außerhalb der Referenz begründet sein |
| Unterstützung verschlechtert Entscheidungen | Richtige Endentscheidungen / zugewiesene bewertbare Fälle je Arm | Mit Mensch-ohne-KI- und Modellreferenz vergleichen | Aufgabenmix abgleichen und Unsicherheit zeigen |
| Schnelle Klicks verdecken offene Fälle | Zeitverteilung sowie ungelöste / zugewiesene Fälle | Belegzugriff und Eskalation verbessern | Schneller ist nicht sicherer; Zeitüberschreitungen nicht ausblenden |
Definieren Sie Übernahme als tatsächliche Auswahl der vorgeschlagenen falschen Aktion, nicht als Öffnen der Empfehlung oder Betätigen einer allgemeinen Schaltfläche. Bewerten Sie Korrekturgenauigkeit anhand des endgültigen Referenzergebnisses. Berichten Sie ungelöste Fälle und Zeitüberschreitungen separat und legen Sie vorher fest, wie diese in den primären Nenner eingehen. Wer schwierige unvollständige Fälle nachträglich ausschließt, lässt die Qualität besser erscheinen.
Übernahme falscher Ratschläge und Korrekturgenauigkeit sind nicht notwendigerweise komplementär: Eine Person kann eine falsche Antwort verwerfen und eine andere falsche wählen oder ohne Auflösung eskalieren. Ebenso ist das Verwerfen richtiger Empfehlungen zunächst ein Aufwandssignal, nicht automatisch ein Schaden. Die Referenzregeln müssen festlegen, wann Eskalation angemessen ist.
Zeigen Sie absolute Anzahlen neben Quoten, aufgeteilt nach vorher definierten Fallgruppen. Berichten Sie Entscheidungszeiten sowohl für richtige Ergebnisse als auch für alle zugewiesenen Fälle; der Median abgeschlossener Freigaben allein blendet langsame Fehlschläge aus. Nutzen Sie ein Unsicherheitsverfahren, das Abhängigkeiten zwischen Prüfpersonen und Fällen berücksichtigt, bei Bedarf mit statistischer Unterstützung. Kleine Punktschätzungsunterschiede bei großer Unsicherheit rechtfertigen keine belastbare Rangfolge.
Minimales Protokoll und Ergebnisformat
Schreiben Sie vor der Erhebung Aufgabengrenze, Zielrollen, Fallsatzrevision, Referenzbewertung, Variantenzuteilung, primäres Ergebnis, Ausschlussregeln, Behandlung von Zeitüberschreitungen und Abbruchbedingungen auf. Benennen Sie eine Person mit Abbruchbefugnis. Legen Sie Freigabekriterien vor der Ergebnisansicht fest: akzeptables Risiko schädlicher Übernahmen, zulässiger Verlust richtiger Entscheidungen, verfügbare Prüfkapazität und besonders kritische Fallgruppen. Die Grenzwerte müssen aus Ihren Risiken und Betriebsbedingungen stammen, nicht aus diesem Artikel.
Ein zugriffsbeschränkter Studiendatensatz kann folgende Felder verwenden: study_revision; interface_revision; model_revision; case_set_revision; case_id; task_stratum; recommendation_correct; arm; reviewer_pseudonym; assigned_order; final_action; final_correct; unresolved_reason; elapsed_ms; evidence_access_available. Lassen Sie Korrektheit bei mehrdeutigen Fällen unbestimmt und speichern Sie den Bewertungsstatus explizit. Eine nicht geöffnete Quelle beweist nicht, dass jemand sie ignoriert hat; Telemetrie zeigt Interaktion, nicht Verständnis.
Das Berichtsformat sollte aggregiert sein: study_revision; arm; task_stratum; reviewers_count; assigned_cases; wrong_advice_exposures; wrong_advice_accepted; correct_advice_exposures; correct_advice_rejected; correct_final_decisions; unresolved_cases; elapsed_time_summary; uncertainty_method. Halten Sie Nenner getrennt und unterdrücken Sie kleine oder identifizierende Gruppen. Dies ist ein vorgeschlagenes Schema, kein erfundenes Versuchsergebnis.
Pseudonymisierte Prüfdaten sind nicht anonym. Beschränken Sie den Zugriff, definieren Sie Aufbewahrung und trennen Sie einen möglichen Zuordnungsschlüssel. Klären Sie Datenschutz, Arbeitsrecht und Beteiligung des Betriebsrats vor Arbeitsplatzstudien oder Verhaltensbeobachtung. Machen Sie aus der Untersuchung keine verdeckte Rangliste von Beschäftigten. Verwenden Sie standardmäßig synthetische oder freigegebene de-identifizierte Fälle und aggregierte Berichte; auch Aggregate können ein sehr kleines Team identifizierbar machen.
Freigabecheckliste und Umgang mit Fehlern
Prüfung 1 — Referenzfälle sind unabhängig bewertet; Mehrdeutigkeit hat eine ausdrückliche Behandlung. Eingebrachte Fehler bleiben von repräsentativen produktionsnahen Fällen unterscheidbar.
Prüfung 2 — Variantenzuteilung, Rotation der Fallsätze und Ergebnisregeln stehen fest. Niemand sieht denselben antworttragenden Fall in mehreren Armen. Für die Einweisung werden separate Beispiele verwendet.
Prüfung 3 — Die Betriebsrolle kann ohne Administratorrechte Belege öffnen, Aktionen korrigieren und eskalieren. Der Abnahmetest für Lieferantenanweisungen prüft ausführbare Verfahren; dieses Experiment untersucht anschließend die Entscheidungsqualität bei konkurrierenden Darstellungen.
Prüfung 4 — Die Ergebnisse enthalten Mensch-ohne-KI-, reine Modell- und unterstützte Entscheidungen, fehlende Entscheidungen, Unsicherheit und kritische Fallgruppen. Der Versuch wählt nicht stillschweigend nur schnelle oder angepasste Prüfende aus.
Prüfung 5 — Die Freigabeentscheidung nennt Oberflächenversion, unterstützte Aufgaben und Restrisiken. Öffnen Sie die Bewertung nach wesentlichen Änderungen an Modellverhalten, Belegzugriff, Aktionsbedeutung, Personaleinsatz oder Betriebsdruck erneut.
Schulung bleibt eine eigenständige Voraussetzung. Rollenbasierte KI-Kompetenz und Zugriffskontrolle können Vorbereitung und Befugnis abbilden. Sie ersetzen keine fehlenden Belege und beweisen nicht, dass qualifizierte Personen irreführenden Empfehlungen widerstehen.
Was der Versuch nicht belegen kann
Ein Versuch mit erhöhtem Fehleranteil kann Prüfende ungewöhnlich misstrauisch machen. Kurze Sitzungen erfassen möglicherweise weder Ermüdung noch Warteschlangendruck oder Gewöhnung an ein überwiegend zuverlässiges Modell. „Belege zuerst“ kann einfache Fälle verlangsamen oder Aufmerksamkeit vom entscheidenden Detail weglenken. „Empfehlung zuerst“ kann bei klar begrenzten Aufgaben effizient sein. Keine Variante ist pauschal sicherer.
Wenn beide unterstützten Varianten bei folgenreichen Fallgruppen schlechter als die menschliche Referenz ohne KI abschneiden, wählen Sie nicht einfach die weniger schlechte Oberfläche und erweitern trotzdem die Automatisierung. Untersuchen Sie Empfehlungen, Aufgabenbeschreibung und verfügbare Belege; halten Sie den betroffenen Umfang nach freigegebener Betriebsregel manuell oder eingeschränkt. Bleiben Ergebnisse uneindeutig, dokumentieren Sie diese Unsicherheit, statt aus einem Pilotversuch ein Freigabezertifikat zu machen.
Beginnen Sie mit einer tatsächlich verantworteten Entscheidung
Wählen Sie eine folgenreiche Prüfaufgabe und eine Oberflächenänderung. Erstellen Sie einen fixierten Fallsatz, zwei vergleichbare Ansichten und ein Ergebnisformat, bevor Sie den Ablauf instrumentieren. Das Ergebnis ist eine belegte Freigabeentscheidung, einschließlich Gründen für das Beibehalten der bestehenden Gestaltung oder die Begrenzung des Umfangs.
Bringen Sie für eine technische Prüfung Ihre Freigabeansicht, das Aktionsschema und einen kleinen freigegebenen synthetischen Fallsatz mit. Ich unterstütze Plattform- und Betriebsteams dabei, Versuchsprotokoll, Belegzugriff und Freigabekriterien zu strukturieren. Rechtliche Anwendbarkeit und die Zulässigkeit von Arbeitsplatzstudien bleiben bei qualifizierter Rechtsberatung und den zuständigen betrieblichen Stellen.