BLUF — Teilen Sie ein Basismodell erst, wenn Sie Adapterwechsel begrenzt und geprüft haben, nicht schon nach dem Zählen der Adapterdateien. Multi-LoRA-Serving kann die mehrfache Ablage der Basisgewichte für aufgabenspezifische Varianten vermeiden. Die Kapazitätsentscheidung hängt jedoch davon ab, welche Adapter gleichzeitig angefragt werden, welche Gewichte resident sind und ob jede Anfrage die freigegebene Revision ausführt. Ein warmer, häufig genutzter Adapter kann Kaltladefehler seltener Varianten verdecken. Prüfen Sie Identitätskorrektheit und Latenz je Adapter vor der Zusammenlegung produktiver Pools.
Dies ist ein Implementierungs- und Versuchsdesign, kein GPU-Benchmark. Der Beitrag behauptet weder einen Durchsatzgewinn noch eine prozentuale Speicherersparnis oder gemessene Produktionskapazität. Die Entscheidung ist enger als bei den vorhandenen Quality Gates für Quantisierung und Adapter: Jede Variante hat ihre Qualitätsprüfung bestanden; nun prüfen Sie, ob diese Varianten betrieblich zusammenpassen.
Drei Einstellungen mit unterschiedlichen Grenzen
Die stabile LoRA-Dokumentation von vLLM beschreibt die Adapterauswahl über das model-Feld einer Anfrage und die parallele Verarbeitung im Rahmen der Serverkonfiguration. Multi-LoRA bedeutet, dass verschiedene Anfragen unterschiedliche Adapter verwenden können. Es bedeutet nicht, dass beliebige Adapter innerhalb einer Anfrage kombiniert werden. Prüfen Sie die Unterstützung Ihrer konkreten Basisarchitektur und Adapterstruktur in der eingesetzten Engine.
Die LoRAConfig-Referenz definiert max_loras als maximale Anzahl von LoRAs in einem Batch. Das ist weder eine Mandantenquote noch ein Parallelitätslimit für Anfragen oder eine Zusage, alle registrierten Adapter warm zu halten. max_cpu_loras begrenzt die im CPU-Speicher gehaltenen Adapter und muss mindestens max_loras entsprechen. max_lora_rank begrenzt den unterstützten Rang; unnötig hohe Werte können die Speicherreservierung erhöhen. Behandeln Sie diese Einstellungen nicht als austauschbare Cachegrößen.
Fixieren Sie den Digest des Runtime-Images und speichern Sie dessen serve --help-Ausgabe mit dem Manifest. Die ursprüngliche Themenrecherche nutzte Entwicklervorschau-Dokumentation; dieser Beitrag prüft zusätzlich die stabile Dokumentation. Auch eine stabile URL ist jedoch veränderlich und kein Nachweis für Ihr installiertes Binary. Validieren Sie erlaubte Werte und Ladeverhalten gegen genau dieses Binary.
Adapteridentität von Kundeneingaben trennen
Das Serving-Gateway sollte eine authentifizierte Arbeitslast und ein freigegebenes Release auf einen unveränderlichen Adapteralias abbilden. Leiten Sie keine beliebigen model-Namen, Dateipfade oder Repository-IDs aus Kundeneingaben weiter. Verwenden Sie eine Allowlist je Arbeitslastidentität mit Basisrevision, Tokenizer- und Template-Revision, Adapterdigest, Rang, Zielmodulen, Runtime-Digest und Freigabe. Verknüpfen Sie diese Angaben mit dem LLM-Release-Bundle.
Ein konzeptioneller Pfad lautet Arbeitslast extraction-de → Release extract-r7 → Basisdigest plus Adapterdigest → Serving-Alias extract-r7. Lösen Sie die Route einmal bei der Zulassung auf und halten Sie die Revision bis zum Abschluss fest. Ein unbekannter Alias, ein fehlendes Artefakt oder eine nicht autorisierte Arbeitslast muss ausdrücklich abgewiesen werden. Fallen Sie niemals still auf das Basismodell zurück. Eine formal erfolgreiche Antwort des falschen Adapters bleibt eine fehlgeschlagene Anfrage.
Deaktivieren Sie dynamisches Laden für den Produktionsversuch: Lassen Sie VLLM_ALLOW_RUNTIME_LORA_UPDATING ungesetzt, prüfen Sie geerbte Umgebungsvariablen und aktivieren Sie keinen dynamischen Resolver. vLLM warnt vor produktivem Runtime-Laden außerhalb einer isolierten, vollständig vertrauenswürdigen Umgebung. Stellen Sie geprüfte Artefakte über die Deployment-Pipeline bereit. Isolieren Sie den Inferenzserver im Netzwerk, damit Aufrufer weder das Gateway umgehen noch Management-Endpunkte erreichen können.
Residenz-Lebenszyklus: Registrierung bedeutet nicht Betriebsbereitschaft
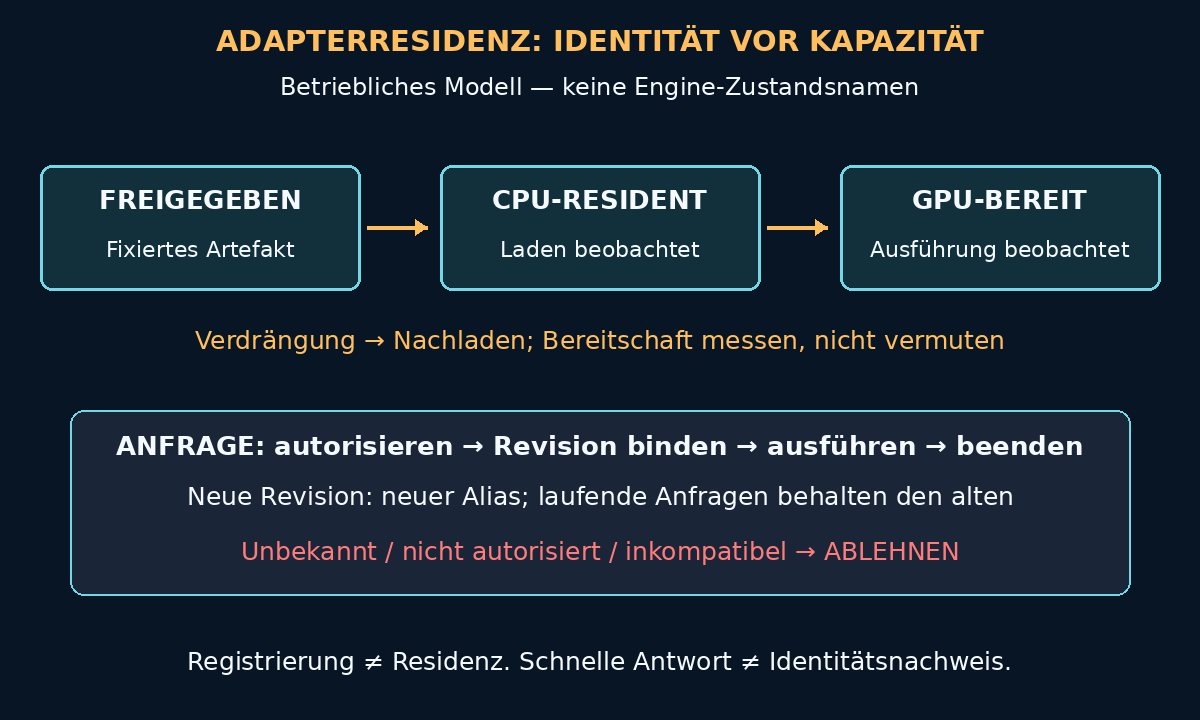
Die Grafik ist ein betriebliches Modell und behauptet nicht, dass vLLM genau diese Zustandsnamen exportiert. Unterscheiden Sie ein freigegebenes Artefakt im Speicher, einen CPU-residenten Adapter und einen für die nächste GPU-Ausführung bereiten Adapter. Ein registrierter Modellname belegt Auffindbarkeit, nicht Residenz. Instrumentieren Sie nach Möglichkeit die fixierte Runtime oder den Loader. Andernfalls kennzeichnen Sie den Zustand als unbekannt, statt aus einer schnellen Antwort auf einen warmen Adapter zu schließen.
Erfassen Sie Artefaktabruf, CPU-Laden, Gerätetransfer und Wartezeit getrennt, soweit die Instrumentierung das erlaubt. Auch ein CPU-residenter Adapter kann vor der Ausführung weitere Arbeit benötigen. Umgekehrt beweist eine langsame Anfrage keinen Cache-Miss: Langer Prefill, Scheduling und KV-Cache-Druck können dasselbe Symptom erzeugen. Behalten Sie das SLO-Modell für Self-Hosted-Inferenz mit seinen phasenbezogenen Messungen bei.
Reproduzierbares Last- und Konfigurationsmanifest
Verwenden Sie die folgende Vorlage als Manifest, nicht als direkt ausführbare Konfiguration oder Kapazitätsempfehlung. Ersetzen Sie jedes REQUIRED-Feld vor dem Versuch durch einen dokumentierten Wert. Die beispielhaften Testwerte sind Versuchsentscheidungen, keine gemessenen sicheren Einstellungen. Feldnamen bleiben für die technische Wiederverwendung unverändert.
experiment_id: adapter-churn-fixture
runtime_image_digest: REQUIRED; gpu_model_and_count: REQUIRED; driver_and_cuda: REQUIRED
base_revision_and_digest: REQUIRED; tokenizer_and_template_digest: REQUIRED
adapter_registry: REQUIRED Zuordnung von unveränderlichem Alias zu Digest, Basisrevision, Rang, Zielmodulen und Freigabe
prompt_corpus_digest: REQUIRED; language_mix: REQUIRED; input_token_buckets: REQUIRED; output_cap: REQUIRED
random_seed: 17; request_count_per_cell: 10000; repetitions: 3
arrival_policy: feste Ankunftsrate ohne Antwortabhängigkeit; offered_rates: REQUIRED; generator_concurrency_limit: REQUIRED
traffic_profiles: Einzeladapter-Baseline, gleichverteilte Adapter, schiefe Verteilung, Popularitätswechsel
max_loras_sweep: [1, 2, 4]; max_cpu_loras_sweep: [4, 8, 16]; max_lora_rank_sweep: unterstützte Obergrenzen ab dem Registry-Maximum
runtime_dynamic_loading: deaktiviert; cold_start_reset_procedure: REQUIRED
acceptance: TTFT- und Fehlerbudgets je Arbeitslast REQUIRED; erlaubte Identitätsabweichungen: 0
Wählen Sie genügend freigegebene Adapter, um eine Arbeitsmenge unterhalb und oberhalb jeder vorgesehenen CPU-Kapazität zu prüfen. Kann die fixierte Runtime die gewählte Registry mit einer Konfiguration nicht zulassen, dokumentieren Sie eine Konfigurationsablehnung statt eines Latenzergebnisses. Halten Sie die Adaptermenge beim Variieren der Rangobergrenze konstant: Gleichzeitig geänderte Gewichte würden den Vergleich verfälschen. Halten Sie im ersten Durchlauf die CPU-Kapazität oberhalb aller max_loras-Werte; fixieren Sie anschließend max_loras und variieren Sie die CPU-Kapazität.
Erzeugen Sie identische Prompt- und Ausgabelängenverteilungen für alle Profile. Prüfen Sie eine Einzeladapter-Baseline bei gleicher angebotener Last, eine Gleichverteilung über die freigegebene Menge und eine bewusst schiefe Verteilung, etwa 80 % der Ankünfte für einen Adapter. Wechseln Sie danach den populären Adapter ohne Änderung der Ankunftsrate. Speichern Sie die tatsächlich erzeugte Anfragesequenz, nicht nur den Seed. Antwortunabhängige Ankünfte machen Warteschlangenwachstum sichtbar. Berichten Sie verworfene oder verspätete Generatoranfragen, damit der Lastgenerator Überlast nicht verdeckt.
Führen Sie warme und zurückgesetzte Durchläufe aus. Definieren Sie den Reset präzise: Ein Engine-Neustart ist nicht mit dem Leeren des Betriebssystem-Page-Caches oder entfernter Artefakt-Caches gleichzusetzen. Speichern Sie je Testzelle Startresultate, zugelassene Anfragen, Abschlüsse, Abbrüche, Timeouts, Ladefehler und Identitätsabweichungen. Berichten Sie je Adapter p50/p95/p99 der TTFT mit Stichprobenzahlen, Gesamtlatenz, beobachtbare Ladedauern, Host-/GPU-Speicher und Warteschlangentiefe. Für seltene Adapter kann die Datenbasis für ein aussagekräftiges p99 fehlen, obwohl der gesamte Lauf viele Anfragen enthält.
Entscheidungstabelle: gemeinsam betreiben oder isolieren
| Bedingung | Erforderlicher Nachweis | Entscheidung | Kosten oder Grenze |
|---|---|---|---|
| Kleine stabile Arbeitsmenge | Alle Arbeitslasten bestehen warme und Reset-Tests | Kandidat für gemeinsamen Pool | Gemeinsame Ausfalldomäne bleibt |
| Seltene Varianten übersteigen Residenzkapazität | Nachladen und Popularitätswechsel erfüllen SLOs je Adapter | Nur mit gemessenen Zulassungsgrenzen teilen | Mehr CPU-Speicher löst Gerätewechsel nicht zwingend |
| Seltener Adapter verletzt TTFT-Budget | Fehler korrelieren mit beobachtetem Laden oder Warten | Dedizierten Pool vorwärmen oder Klasse isolieren | Doppelte Basisgewichte und Leerkapazität |
| Adapteridentität stimmt nicht | Erwartetes und ausgeführtes Release weichen ab | Rollout stoppen; Routing vor Kapazität korrigieren | Latenzgewinne rechtfertigen keine falsche Identität |
| Andere Vertrauens- oder Kompatibilitätsgrenze | Sicherheits- und Basis-Adapter-Prüfung verlangt Trennung | Freigegebene Varianten isolieren | Höhere Infrastruktur- und Betriebskosten |
Machen Sie aus der Tabelle keine automatische Freigabe allein anhand von Perzentilen. Fordern Sie alle harten Prüfkriterien ein, dokumentieren Sie das Lastfenster und wiederholen Sie die Prüfung nach Änderungen an Runtime, Registry oder Verkehrspolitik. Ein heute geeigneter Pool kann ungeeignet werden, sobald ein neuer Mandant die Arbeitsmenge verändert.
Abnahmecheckliste für Routing und Kaltladen
1. Unbekannter und nicht autorisierter Adapter: Das Gateway lehnt vor der Inferenz ab. Prüfen Sie, dass die Anfrage das Backend nicht erreicht und kein Basismodell-Fallback stattfindet.
2. Inkompatibler Rang oder falsche Basisrevision: Die Deployment-Prüfung lehnt die Variante vor dem Verkehr ab. Lösen Sie den tatsächlichen Engine-Ladefehler im isolierten Test aus und speichern Sie ihn, nicht nur eine simulierte Gateway-Antwort.
3. Verdrängen und Nachladen: Steuern Sie mehr freigegebene Adapter an, als die getestete residente Arbeitsmenge umfasst, und kehren Sie zum ursprünglichen Adapter zurück. Belegen Sie die ausgeführte Revision und dokumentieren Sie, ob Laden tatsächlich beobachtet wurde. Leiten Sie Verdrängung nicht allein aus verstrichener Zeit ab.
4. Revisionswechsel während des Streamings: Starten Sie eine lange Anfrage auf extract-r7, leiten Sie neue Anfragen auf einen eigenen extract-r8-Alias oder Ersatzpool und lassen Sie r7 auslaufen. Die laufende Anfrage muss auf r7 enden; überschreiben Sie darunter keine veränderlichen Gewichte. Prüfen Sie das ausgeführte Artefakt in serverseitiger Instrumentierung, nicht nur im model-Feld der Antwort.
5. Prozessneustart und fehlendes Artefakt: Verwenden Sie das dokumentierte Reset-Verfahren und entfernen Sie gezielt ein benötigtes Artefakt in einer Testumgebung. Die Zulassung muss sicher ablehnen oder auf ein unabhängig freigegebenes gleichwertiges Deployment ausweichen. Keine stille Ersetzung.
6. Abbruch und Sättigung: Brechen Sie Streams während eines Popularitätswechsels ab. Prüfen Sie, dass die Anfrageverwaltung ausstehende Arbeit abbaut, nachfolgende Anfragen ihre Identität behalten und Speicher über wiederholte Versuche nicht unbegrenzt wächst.
Semantische Kontrollanfragen mit unterscheidbarem Sollverhalten helfen beim Erkennen von Routingfehlern. Antworttext allein beweist jedoch keine Adapteridentität. Nutzen Sie vertrauenswürdige Registry-Loader-Korrelation und Request-Traces. Halten Sie sensible Prompts aus allgemeinen Metriken heraus und vermeiden Sie unbegrenzte Request-ID-Labels. Ein Gateway-Test prüft Autorisierung und Aliasauflösung, nicht GPU-Ausführung oder Kapazität.
Warum Transformers-Hotswapping ein anderer Vertrag ist
Die PEFT-Anleitung von Hugging Face Transformers beschreibt den Austausch von LoRA-Gewichten in einem vorhandenen Adapterslot. Für kompilierte Modelle nennt sie enable_peft_hotswap vor Laden und Kompilierung, eine target_rank-Obergrenze sowie mögliche Neukompilierung, wenn ein Ersatzadapter mehr Schichten adressiert. Das ist für einen ausdrücklich koordinierten Prozess nützlich. Es belegt aber nicht, dass die Mutation eines Modellobjekts eine Isolation pro Anfrage wie beim Multi-Adapter-Serving von vLLM bietet.
Serialisieren Sie bei In-Place-Hotswapping den Zugriff oder schaffen Sie eine verifizierte Synchronisationsgrenze um die Mutation und jede Generierung mit diesem Slot. Übertragen Sie keine Parallelitätsannahmen des anfragebezogenen Multi-Adapter-Servings auf dieses Design. Versprechen Sie ebenso wenig, dass ein vLLM-Reload sämtliche Semantik laufender Anfragen erhält, ohne die fixierte Implementierung zu testen. Unveränderliche Aliase sowie auslaufende und ersetzte Deployments machen die Release-Grenze besser prüfbar, benötigen aber vorübergehend Reservekapazität.
Mit einer Konsolidierungsprüfung beginnen, nicht mit einem Sparversprechen
Wählen Sie ein Basismodell und eine freigegebene Adapterregistry, vereinbaren Sie Latenz- und Fehlerbudgets je Arbeitslast und führen Sie Baseline, Gleichverteilung, schiefe Verteilung sowie Popularitätswechsel aus. Halten Sie einen dedizierten Rückfallpool bereit. Geben Sie die Konsolidierung erst frei, wenn Identitätsprüfungen, Kaltpfade und sämtliche Serviceziele bestehen. Berechnen Sie Betriebskosten anhand dieser bestandenen Konfiguration einschließlich Reservekapazität und Betriebsaufwand.
Ein Architekturreview für Adapter-Serving kann den Registry-Vertrag, das Versuchsmanifest, Routingtests und die Entscheidung zwischen gemeinsamem Betrieb und Isolation für Ihr Deployment liefern. Das nützliche Ergebnis ist kein versprochener Geschwindigkeitsgewinn, sondern eine gemessene Grenze für gemeinsam nutzbare Kapazität und eine klare Isolationsregel für ungeeignete Varianten.