Ein mehrsprachiges Embedding-Modell beweist nicht, dass deutsche Servicefragen das richtige englische Handbuch finden. Vergleichen Sie direkte sprachübergreifende Suche und Abfrageübersetzung anhand fachlich geprüfter, gepaarter Fälle. Halten Sie Dokumentrevisionen, Berechtigungen und Belegurteile konstant. Bewerten Sie zuerst die gefundenen Belege, dann die sprachliche Qualität der Antwort. Entscheidend sind Qualitätsgrenzen je Sprachpaar und Ihr Latenzbudget.
Betrachten Sie die illustrative Frage „Wie entlüfte ich die Kühlmittelpumpe nach dem Dichtungswechsel?“ Der passende englische Abschnitt könnte „bleeding the coolant circuit after seal replacement“ heißen; ein anderer beschreibt lediglich den normalen Pumpenbetrieb. Beide wirken thematisch passend. Nur einer beantwortet die Wartungsfrage. Dieses konstruierte Beispiel ist weder eine Kundenbeobachtung noch eine freigegebene Arbeitsanweisung.
Die technische Frage lautet nicht pauschal: „Unterstützt das Modell Deutsch?“ Sie lautet: Gehen bei der sprachlichen Transformation genau jene Belege verloren, die für ein zulässiges Verfahren erforderlich sind? Das klären Sie mit einem kontrollierten Vergleich, nicht mit einer übersetzten Demo oder einem gemittelten mehrsprachigen Benchmarkwert.
Definieren Sie die Belegidentität vor dem Sprachvergleich
Fixieren Sie einen Korpusstand. Identifizieren Sie jede Quelle über Dokument-ID, Revision, Abschnitt und Belegspanne. Führen Sie Quellsprache und Sprache der Benutzeroberfläche getrennt. Beschreiben eine deutsche und eine englische Anleitung tatsächlich dasselbe Verfahren derselben Revision, vergeben Sie nach fachlicher Prüfung eine Äquivalenz-ID für die Belege. Gleiche Dateinamen oder übersetzte Überschriften reichen nicht: Lokale Ausgaben können andere Grenzwerte, Warnungen oder Bauteilvarianten enthalten.
Speichern Sie je Testfall eine Intent-ID, die natürlich formulierte deutsche Frage, eine fachlich geprüfte englische Entsprechung, zulässige Beleg-IDs, Anwendbarkeitsbedingungen, ein Berechtigungsfixture und die erwartete Beantwortbarkeit. Bei folgenreichen Fällen können zwei Prüfende strittige Zuordnungen klären. Fehlt in einer Sprachfassung die relevante Warnung, ist das eine Lücke in der Korpusabdeckung und nicht automatisch ein Embedding-Fehler. Führen Sie solche ungepaarten Fälle separat weiter, statt sie aus der Auswertung zu entfernen.
Beginnen Sie mit einem begrenzten Satz, den Fachverantwortliche zuverlässig annotieren können. Decken Sie Verfahrensfragen, Symptome, deutsche Komposita, Abkürzungen, gemischtsprachige Werkstattformulierungen und Fragen mit Kennungen ab. Ergänzen Sie schwierige Negativbeispiele: richtige Baugruppe, falsches Verfahren; veraltete Revision; ähnliches Bauteil; eine Passage mit entscheidender Verneinung. Kleine Testsätze helfen beim Debugging, belegen aber keine allgemeine Überlegenheit.
Sprachpaar-Matrix: Was hat sich tatsächlich geändert?
Verwenden Sie für die Diagnose gepaarte Intents. DE → EN bezeichnet eine deutsche Frage gegen englische Dokumente, nicht die Erzeugung einer deutschen Antwort. Die deutsche Kontrollbedingung benötigt gleichwertige deutsche Belege. Fehlen diese, markieren Sie die Kontrolle als nicht verfügbar. Testen Sie zusätzlich den tatsächlich eingesetzten gemischtsprachigen Korpus, damit sprachlich eingeschränkte Testindizes keine störenden Treffer anderer Sprachen verbergen.
| Testschnitt | Frage und Korpus | Konstant halten | Mögliche Fehlerursache |
|---|---|---|---|
| EN → EN | Englische Frage; englisches Handbuch | Dieselbe englische Quelle und derselbe Intent | Extraktion, Relevanzurteil oder Basissuche |
| DE → EN | Deutsche Frage; dasselbe englische Handbuch | Dieselben zulässigen Belege wie bei EN → EN | Sprachübergreifende Repräsentation oder Formulierung |
| DE → DE | Deutsche Frage; gleichwertiges deutsches Handbuch | Geprüfte Verfahrens- und Revisionsäquivalenz | Deutsche Terminologie oder lokalisierter Korpus |
| Übersetztes DE → EN | Maschinell übersetzte Frage; englisches Handbuch | Übersetzerversion und geschützte Kennungen | Übersetzung hilft oder verändert die Aufgabe |
| Gemischtsprachig | Originalfrage; produktiver Sprachenmix | Berechtigungen, Revisionen und Kandidatenbudget | Duplikate verdrängen Belege oder Sprachrouting verzerrt |
Wenn Sie sämtliche englischen Benchmarkfragen maschinell übersetzen, entsteht noch kein repräsentativer deutscher Testsatz. Englische Syntax und Wortwahl können erhalten bleiben, während die Kurzformen des Servicealltags fehlen. Sammeln Sie natürlich formulierte deutsche Fragen und nutzen Sie geprüfte Entsprechungen zur Diagnose. Behalten Sie nahe Paraphrasen jeweils in derselben Entwicklungs- oder Holdout-Gruppe; andernfalls belohnt der Test wiedererkanntes Wording.
Der technische Bericht zu multilingual E5 untersucht mehrsprachiges Retrieval und sprachübergreifendes Zuordnen von Satzpaaren. Das begründet einen Modelltest, ersetzt aber keine Messung deutscher Servicefragen gegen Ihre englischen Handbücher. Die veröffentlichte MIRACL-Sprachtabelle enthält keinen deutschen Industriehandbuch-Testschnitt. Satzpaare zuzuordnen ist außerdem nicht dasselbe wie sämtliche notwendigen Klauseln einer Wartungsanweisung zu finden.
Zwei Suchwege und ein geschützter Identitätspfad
Vergleichen Sie die folgenden Wege auf denselben zugelassenen Belegen. Das Diagramm zeigt eine vorgeschlagene Evaluationsarchitektur, keinen gemessenen Produktivbetrieb. Pfad A verwendet die ursprüngliche deutsche Frage im gemeinsamen mehrsprachigen Embedding-Raum. Pfad B übersetzt die Frage ins Englische und durchsucht den englischen Korpus. Beide erhalten einen unabhängigen Pfad für Originalkennungen. Weder Übersetzung noch semantische Ähnlichkeit darf die Identität eines Betriebsmittels neu festlegen.
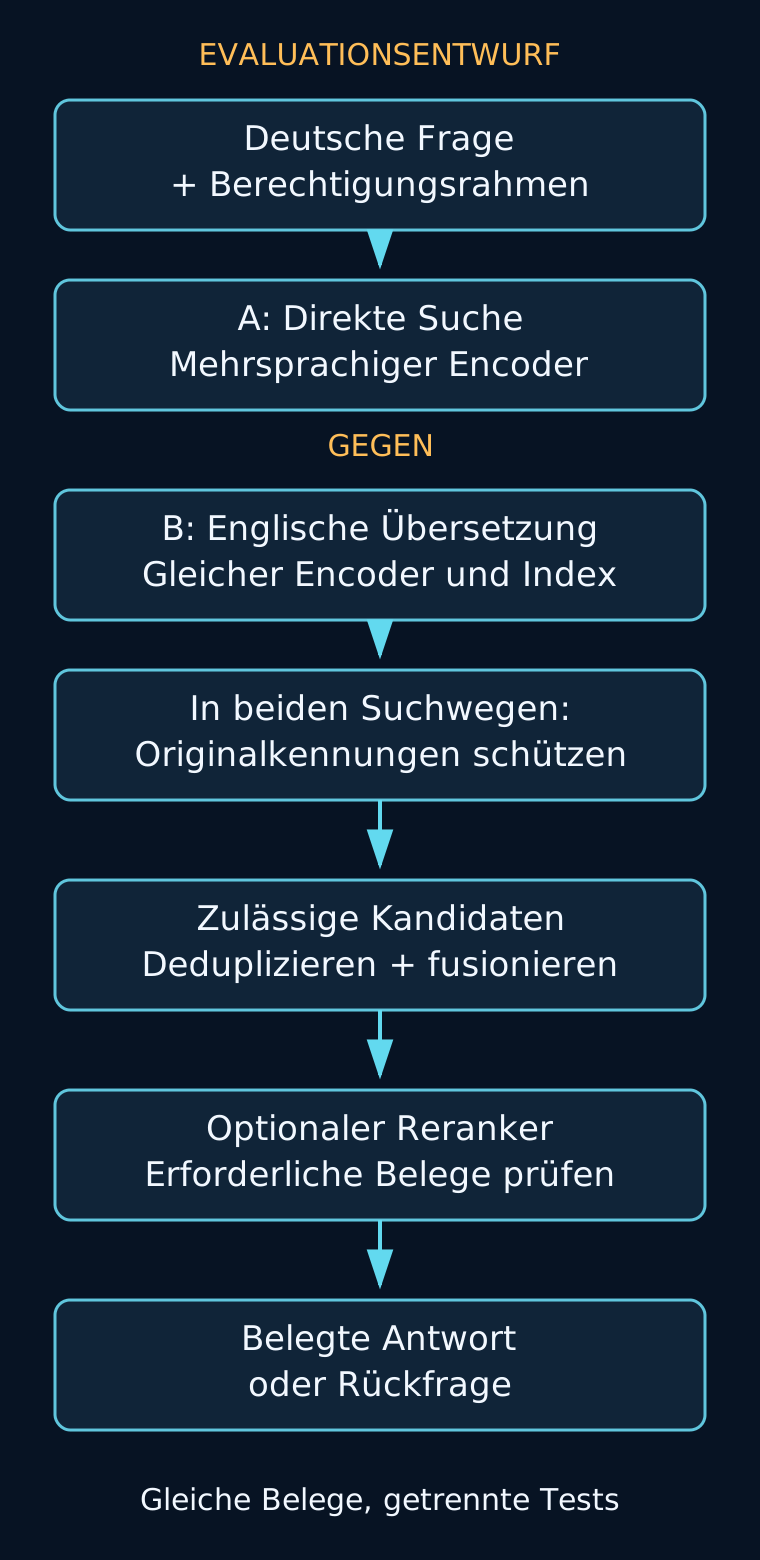
Isolieren Sie zunächst den Übersetzungseffekt: Verwenden Sie in beiden Pfaden denselben mehrsprachigen Encoder, englischen Index, dieselben Kandidatenbudgets und dieselbe Reranker-Konfiguration. Prüfen Sie anschließend bei Bedarf eine separat versionierte englischspezifische Suchkonfiguration. Dieser zweite Vergleich misst eine komplette Alternative und nicht mehr allein die Übersetzung. Kennzeichnen Sie das entsprechend.
Die Modellkarte von intfloat/multilingual-e5-large verlangt für asymmetrisches Retrieval die unveränderten Präfixe query: und passage: auch bei nicht englischen Texten. Kodieren Sie beispielsweise „query: Wie entlüfte ich …“ und „passage: Bleeding the coolant circuit …“. Übersetzen Sie die Präfixe nicht. Das Beispiel der Modellkarte verwendet Mean-Pooling unter Berücksichtigung der Attention-Maske und normalisierte Embeddings. Versionieren Sie Tokenizer, Modellrevision, Pooling und Normalisierung gemeinsam. Die Instruct-Variante hat einen anderen Eingabevertrag; ihre Formate dürfen Sie nicht beliebig mischen.
Dieselbe Modellkarte nennt eine Grenze von 512 Tokens für lange Eingaben und warnt vor schwächerer Leistung bei ressourcenarmen Sprachen. Daraus folgt weder, dass Deutsch ressourcenarm ist, noch dass dieser konkrete deutsche Anwendungsfall scheitert. Messen Sie die tatsächliche tokenisierte Eingabe einschließlich Präfix, ergänzter Überschriften und Spezialtokens. Ein Chunk unterhalb einer Zeichengrenze kann trotzdem abgeschnitten werden. Deutsche Komposita und englische Entsprechungen müssen nicht gleich viele Tokens benötigen. Erfassen Sie die Länge vor dem Abschneiden und prüfen Sie, ob annotierte Belege erhalten bleiben. Teilen Sie überlange Eingaben auf oder weisen Sie sie zurück, statt die abschließende Warnung unbemerkt zu verlieren. Die grundlegende Evaluation von Chunking-Strategien erklärt das gemeinsame Testen von Chunkgröße und Embedder. Übernehmen Sie keine Chunkgröße eines Modells mit größerem Kontextfenster ungeprüft für E5.
Abfrageübersetzung braucht einen Erhaltungsvertrag
Behandeln Sie Übersetzung als versionierte Suchtransformation. Bewahren Sie die Originalfrage auf, extrahieren Sie verifizierte Kennungen in geschützte Felder und verlangen Sie ein Ausgabeschema mit übersetzter Frage und unveränderten Schutzwerten. Vergleichen Sie diese Werte vor dem Retrieval deterministisch. Auch eine schemakonforme Übersetzung kann eine Verneinung umkehren oder einen Fachbegriff ersetzen. Prüfen Sie semantische Fehler deshalb separat. Die Anweisung „Teilenummern niemals ändern“ ersetzt keine Prüfung.
Verwenden Sie ein freigegebenes Glossar für Fachkomposita und Abkürzungen, ohne Mehrdeutigkeit zu verbergen. „Dichtung“ kann je nach Baugruppe etwa seal oder gasket bedeuten. Verändern mehrere Interpretationen die Anwendbarkeit, stellen Sie eine Rückfrage statt stillschweigend den häufigsten englischen Begriff zu wählen. Maskieren Sie nicht unterschiedslos sämtliche Zahlen: Druckwerte, Abmessungen und Fehlercodes brauchen unterschiedliche Regeln. Entfernen Sie alle Mengenangaben, kann die Bedeutung der Frage verloren gehen.
Ein externer Übersetzer verändert zudem die Datengrenze. Prüfen Sie, ob Fragen die Umgebung verlassen dürfen, welche Logs gespeichert werden und wie Mandantenberechtigungen in Cache-Schlüssel eingehen. Halten Sie Übersetzermodell, Prompt und Glossarrevision im Laufmanifest fest. Messen Sie Übersetzungslatenz und Timeouts getrennt von Embedding und Suche. Bei Übersetzungsausfall kann ein validierter direkter Pfad einen gekennzeichneten eingeschränkten Betrieb ermöglichen; andernfalls ist eine Rückfrage erforderlich. Fehlende Autorisierung ist niemals ein Anlass für einen Übersetzungs-Fallback.
Nutzen Sie Originalkennungsabgleich und lexikalische Suche als Kontrollpfade, nicht als Behauptung, Fusion löse das Sprachproblem. Microsofts Dokumentation zur hybriden Rangfolge beschreibt RRF als Zusammenführung sortierter Trefferlisten und ordnet semantisches Reranking danach ein. Die Rangkonstante ist nicht die Anzahl der Vektorkandidaten. Ein zusätzlicher Übersetzungspfad verändert die Menge der Listen und kann Score-Größenordnungen verschieben. Eine alte absolute Score-Schwelle ist damit nicht übertragbar. Entfernen Sie wiederholte Belege und prüfen Sie sowohl die Kandidatenabdeckung vor der Fusion als auch die Belegabdeckung im endgültigen Kontext.
Messen Sie Belegverlust an jeder Stufe
Definieren Sie Recall@10 je beantwortbarer Frage als Zahl der annotierten relevanten Belegeinheiten unter den ersten zehn eindeutigen Treffern, geteilt durch alle annotierten relevanten Einheiten. Mitteln Sie innerhalb jedes Testschnitts und veröffentlichen Sie dessen Fallzahl. Sind mehrere Spannen austauschbare Alternativen, bilden sie eine gemeinsame erforderliche Einheit. Benötigt ein Verfahren dagegen eine Voraussetzung und eine Warnung, bewerten Sie diese als getrennte Anforderungen. Berichten Sie zusätzlich vollständige Belegabdeckung: Erreichen sämtliche erforderlichen Einheiten den Kontext? Ein nützlicher Absatz genügt für eine mehrteilige Anweisung nicht.
Verwenden Sie MRR für den ersten nützlichen Treffer und nDCG nur bei abgestuften Relevanzurteilen. Fragen ohne Antwortquelle gehören nicht mit einem Nullnenner in Recall. Bewerten Sie dort korrekte Antwortverweigerung und die Auswahl falscher Belege separat. Speichern Sie bei beiden Suchwegen die Beleg-IDs nach Erstsuche, Fusion, Reranking und Kontextzusammenstellung. Gelangt der richtige englische Abschnitt in die Kandidatenvereinigung und verschwindet erst nach dem Reranker, wäre ein Austausch des Embedding-Modells die falsche Maßnahme.
Berichten Sie die Differenz DE → EN minus EN → EN für gepaarte Intents als diagnostische Sprachlücke, nicht als allgemeingültigen Mehrsprachigkeitsnachteil. Ziehen Sie bei Unsicherheitsabschätzungen unabhängige Intents oder Handbuchfamilien als Resampling-Einheiten heran. Übersetzte Varianten derselben Frage sind keine unabhängigen Aufgaben. Halten Sie Fallzahlen und ungeklärte Relevanzurteile pro Testschnitt sichtbar. Ein großer englischer Anteil darf Regressionen bei deutschen Verfahrensfragen nicht verdecken.
Messen Sie Retrieval-Gesamtdauer und vollständige Antwortlatenz getrennt, einschließlich Übersetzung, Cache-Misses und Fehlern. Dokumentieren Sie Korpusgröße, Hardware oder Dienstklasse, Parallelität, Kandidatenfenster sowie Warm- und Kaltcache-Bedingungen. Erfassen Sie Kosten je versuchter Anfrage und nicht nur je erfolgreicher Übersetzung. Dieser Beitrag nennt keinen gemessenen Latenz- oder Genauigkeitssieger: Ein repräsentativer Kundenkorpus und ein Retrieval-Lasttest lagen nicht vor.
Entscheidungstabelle: Welche Grenze wird verletzt?
| Beobachteter Befund | Zu prüfende Entscheidung | Notwendige Freigabebedingung |
|---|---|---|
| Direkter Pfad erfüllt alle Testschnitt-Grenzen | Gemeinsamen mehrsprachigen Encoder beibehalten | Deutschen Holdout und Tokenlängenprüfung erhalten |
| Übersetzung behebt geprüfte Terminologiefehler | Übersetzung für diese Frageklasse aktivieren | Kennungserhalt, semantische Prüfung und Latenzbudget |
| Beide Pfade scheitern an derselben Quellspanne | Zuerst Extraktion oder Belegeinheiten reparieren | Erforderliche Klausel ist indexiert und bleibt erhalten |
| Relevante Belege gehen nach der Erstsuche verloren | Fusion, Reranking oder Kontextauswahl prüfen | Beleg-IDs je Stufe bei festen Budgets vergleichen |
| Übersetzung verändert Identität, Verneinung oder Anwendbarkeit | Pfad für betroffene Fälle sperren | Rückfrage oder validierter direkter Fallback |
| Deutsche Kontrolle besitzt keine gleichwertige Quellrevision | Vergleich als ungepaart kennzeichnen | Korpusabdeckung separat ausweisen; Äquivalenz nicht erfinden |
Legen Sie Qualitätsuntergrenzen und tolerierbare gepaarte Regressionen vor dem Tuning gemeinsam mit der Serviceverantwortung fest. Bei folgenreichen Fehlanweisungen sind strengere Grenzen sinnvoll. Retrieval-Evaluation ist jedoch keine sicherheitstechnische Freigabe zur Wartungsausführung. Es bleibt der jeweils geltende betriebliche Freigabeprozess erforderlich. Der RAG-Evaluationsharness beschreibt die übergreifende Release-Kontrolle. Dieses Experiment ergänzt sie um Sprachpaar-Fixtures und ein Übersetzungsmanifest.
Freigabecheckliste und Zielkonflikte
Belegprüfung: Quell-ID, Revision, Sprache und Anwendbarkeit sind explizit. Sprachübergreifende Äquivalenz ist geprüft. Unzugängliche oder fehlende Quellen zählen nicht als erfolgreicher Treffer.
Encoding-Prüfung: Präfixvertrag, Modellrevision, Tokenizer, Pooling und Normalisierung sind fixiert. Tokenzahlen enthalten hinzugefügte Metadaten. Erforderliche Belegspannen überstehen die Längenbegrenzung.
Übersetzungsprüfung: Die Originalfrage bleibt erhalten. Geschützte Kennungen stimmen exakt überein. Für Terminologie, Verneinungen und Mengen existieren geprüfte Testfälle. Timeouts und Cache-Berechtigungsgrenzen sind definiert.
Ranking-Prüfung: Kandidaten und endgültiger Kontext unterliegen denselben Berechtigungen. Gleichwertige Übersetzungen verdrängen keine ergänzenden Belege. Die Eignung des Rerankers für das geprüfte Sprachpaar wird getestet, nicht vorausgesetzt.
Release-Prüfung: Führen Sie gepaarte Holdout-Vergleiche durch. Prüfen Sie jede folgenreiche Regression. Rollen Sie die gewählte Routingregel zunächst begrenzt aus und behalten Sie den Rückweg zum bisherigen Index, Encoder und Übersetzungsstand. Überwachen Sie Leertreffer, Rückfragen und falsche Belegauswahl je Sprachpaar, ohne unnötig sensible Rohfragen in der Telemetrie aufzubewahren.
Ein gemeinsamer Encoder vermeidet eine Übersetzungsabhängigkeit zur Anfragezeit, kann aber Fachformulierungen verfehlen. Übersetzung kann die lexikalische Übereinstimmung verbessern, schafft jedoch eine zusätzliche semantische Fehlerquelle, Latenz und Glossarpflege. Beide Wege parallel zu betreiben erhöht Kandidatenaufwand und Duplikatdruck. Keiner behebt automatisch schlechte Extraktion, veraltete Handbücher oder fehlende Annotationen. Wählen Sie die kleinste Architektur, die die Beleg- und Betriebsgrenzen erfüllt.
Womit Sie beginnen sollten
Bringen Sie eine Handbuchfamilie, natürlich formulierte deutsche Fragen, die relevanten englischen Abschnitte und Ihre Berechtigungs- und Latenzvorgaben zusammen. Erstellen Sie die gepaarte Belegmatrix, bevor Sie einen Übersetzer ergänzen. Ich unterstütze Ihr Team dabei, Fixtures zu prüfen, Belegverluste nachzuvollziehen und eine Freigabeentscheidung zu definieren, die Retrieval-Qualität von flüssiger deutscher Ausgabe trennt. Das Ergebnis sollte ein reproduzierbarer Vergleich mit klaren Fehlergrenzen sein – kein Versprechen, dass Mehrsprachigkeit automatisch das richtige Verfahren liefert.