Alarmieren Sie die Rufbereitschaft, wenn Ihr KI-Dienst sein vereinbartes Fehlerbudget so schnell verbraucht, dass ein Eingriff erforderlich ist – nicht bei jedem fehlgeschlagenen Modellaufruf. Definieren Sie erfolgreiche Ereignisse an der Nutzergrenze, kombinieren Sie lange und kurze Burn-Rate-Fenster und testen Sie Auslösung sowie Rücksetzung. Behandeln Sie geringe Last und fehlende Telemetrie ausdrücklich: Eine fehlende Fehlerquote bedeutet keinen gesunden Dienst.
Diese Implementierungsanleitung trennt drei Entscheidungen: Ist das Nutzerergebnis fehlgeschlagen? Rechtfertigt die Fehlerrate eine Unterbrechung der Rufbereitschaft? Welches Team erhält die Benachrichtigung? Die Zahlen sind ein Beispiel. Sechs synthetische Prometheus-Regeltests wurden mit promtool 3.14.0 ausgeführt; sie sind keine Produktionsmessungen und kein Nachweis reduzierter Bereitschaftsbelastung.
Beginnen Sie an der Nutzergrenze, nicht am Modell-SDK
Definieren Sie für einen interaktiven Assistenten genau ein berechtigtes Ereignis je logischem Nutzervorgang an einer festgelegten Dienstgrenze. Ein betrieblich erfolgreiches Ereignis kann eine vollständig übermittelte Antwort innerhalb der vereinbarten Frist sein, die synchrone Schema- oder Richtlinienprüfungen besteht. Zählen Sie den Vorgang einmal, auch wenn er Wiederholungen oder mehrere Modellaufrufe auslöst. Ein Anbieterfehler mit rechtzeitiger erfolgreicher Wiederherstellung muss kein fehlgeschlagener Nutzervorgang sein; ein HTTP 200 mit unbrauchbarem Teilstream kann dagegen einer sein.
Legen Sie die Behandlung abgewiesener Anfragen, Client-Abbrüche, Richtlinienablehnungen und unvollständiger Streams vor der Instrumentierung fest. Wenn Sie Überlastabweisungen ausschließen, verbergen Sie möglicherweise genau den Ausfall, den das SLO erkennen soll. Eine berechtigte Sicherheitsablehnung ist nicht automatisch ein Fehler. Für nie abgeschlossene Vorgänge benötigen Sie einen Timeout- oder Ablaufpfad; andernfalls werden hängende Anfragen in Abschlussmetriken systematisch unsichtbar.
Verwenden Sie begrenzte Labels wie Dienst und Lastklasse. Prompts, Nutzer-IDs und Request-IDs gehören nicht in Prometheus-Labels. Exportieren Sie Zähler für berechtigte und fehlerhafte Ereignisse kontinuierlich, einschließlich initialisierter Fehlerzähler mit Wert null. Prüfen Sie in Instrumentierungstests, dass fehlerhafte Ereignisse die berechtigten nicht übersteigen. Fehler einzelner Modellversuche bleiben Diagnosesignale, nicht der Nenner für die Zuverlässigkeit logischer Nutzervorgänge.
Diese Ebene ergänzt den Inferenzbetrieb mit nutzerbezogenen SLOs: Der Grundlagenbeitrag definiert Dienstversprechen und Anfragephasen; hier geht es um Alarmzustand und Benachrichtigungsregeln. Semantische Korrektheit aus späterer menschlicher Prüfung benötigt einen separaten Qualitätsindikator. Unterstellen Sie nicht für jede Antwort ein sofort verfügbares, verlässliches Korrektheitslabel.
Leiten Sie die Burn-Rate-Schwelle aus der Reaktionsentscheidung ab
Die Burn Rate ist der beobachtete Anteil fehlerhafter Ereignisse geteilt durch den zulässigen Fehleranteil. Bei einem beispielhaften Ziel von 99,9 % beträgt die Toleranz 0,001. Eine Fehlerquote von 1,44 % entspricht damit einer Burn Rate von 14,4. Für einen Berichtszeitraum von 30 Tagen gilt die übliche Beziehung: Burn-Rate-Schwelle = gewählter Budgetanteil × 720 Stunden ÷ Stunden des langen Fensters.
Bei anfragebasierten SLOs setzt die Übersetzung von Zeit in einen Anteil des monatlichen Anfragebudgets eine repräsentative Anfragerate voraus. Eine ruhige Stunde und eine Spitzenlaststunde enthalten nicht zwangsläufig denselben Anteil berechtigter Ereignisse. Erfassen Sie deshalb zusätzlich die tatsächlichen fehlerhaften und berechtigten Ereignisse im Berichtszeitraum. Die zeitbasierte Berechnung ist eine Näherung für die Alarmgestaltung, keine exakte Budgetbuchhaltung bei beliebigem Lastverlauf.
Das Google SRE Workbook empfiehlt mehrere Fenster und Burn Rates, weil ein einzelnes kurzes Fenster unruhig reagiert und ein einzelnes langes Fenster langsam zurücksetzt. Beide Fenster eines Paares müssen dieselbe Burn-Rate-Schwelle überschreiten. Verknüpfen Sie unterschiedliche Dringlichkeitspaare mit OR. Das kurze Fenster prüft, ob das Problem noch aktiv ist.
| Regelklasse | Langes / kurzes Fenster | Burn-Rate-Schwelle | Beabsichtigte Reaktion und Grenze |
|---|---|---|---|
| Schneller Bereitschaftsalarm | 1 Stunde / 5 Minuten | 14,4 | Beispielhaft 2 % Budgetanteil; nur bei sinnvoller sofortiger Reaktion unterbrechen |
| Langsamer Bereitschaftsalarm | 6 Stunden / 30 Minuten | 6 | Beispielhaft 5 % Budgetanteil; anhaltende Verschlechterung mit mehr Reaktionszeit |
| Ticket | 72 Stunden / 6 Stunden | 1 | Beispielhaft 10 % Budgetanteil; Untersuchung mit Verantwortung statt unbeachteter Warteschlange |
| Geringe oder keine Last | Explizite Mengen- und Gesundheitsprüfungen | Keine universelle Quotenschwelle | Probes oder Geschäftsfristen prüfen; eine Mengenschwelle kann vollständige Ausfälle bei geringer Last verdecken |
Dies sind mögliche Regelklassen, keine universellen Schwellen. Die ausgeführte Testimplementierung umfasst nur den schnellen Bereitschaftsalarm und ein unabhängiges Signal für fehlende Zeitreihen. Ergänzen Sie weitere Klassen erst mit benannten Verantwortlichen und eigenen Tests. Lange Bereichsabfragen kosten außerdem Speicher und Auswertungszeit; überwachen Sie Regelauswertungen und wählen Sie eine passende Recording-Strategie für Ihr Prometheus-Deployment.
Recording Rules: Erst Ereignisse aggregieren, dann dividieren
Legen Sie für jedes Fenster W aus 5m und 1h die Recording Rule service:sli_error_ratio:W an. Verwenden Sie folgenden Ausdruck und ersetzen Sie beide W durch das jeweilige Fenster:
sum by (service) (rate(ai_service_bad_total[W])) / sum by (service) (rate(ai_service_eligible_total[W]))
Berechnen Sie Raten pro Zähler vor der Aggregation, damit Resets je Zeitreihe behandelt werden. Dividieren Sie Summen, nicht den Mittelwert einzelner Instanzquoten; andernfalls kann eine fast ungenutzte Instanz dasselbe Gewicht wie die meistbelastete Replik erhalten. Behalten Sie auf beiden Seiten dasselbe service-Label. Das Beispiel enthält bewusst eine Lastklasse. Wenn Ihr Vertrag getrennte Klassen verlangt, ergänzen Sie dasselbe begrenzte Klassenlabel durchgängig in Recordings, Vergleichen und Vektormatching.
Der getestete Ausdruck für den schnellen Bereitschaftsalarm lautet:
(service:sli_error_ratio:1h > 14.4 * 0.001) and on (service) (service:sli_error_ratio:5m > 14.4 * 0.001) and on (service) (sum by (service) (increase(ai_service_eligible_total[1h])) >= 100) and on (service) (sum by (service) (increase(ai_service_eligible_total[5m])) >= 20)
Die Mindestmengen von 100 und 20 Ereignissen sind ausdrücklich beispielhafte technische Entscheidungen, keine statistischen Konfidenzgarantien. increase extrapoliert an Fenstergrenzen und ist kein exakter Audit-Zähler. Diese Grenzen unterdrücken unruhige Quotenalarme, können aber auch einen echten Ausfall bei geringer Last unterdrücken. Ergänzen Sie deshalb eine separat verantwortete synthetische Transaktion, eine Prüfung des Rückstaualters oder einer Geschäftsfrist. Synthetische Transaktionen müssen sicher, repräsentativ und separat gekennzeichnet sein; sie dürfen den Nenner realer Nutzervorgänge nicht unbemerkt vergrößern.
Für den einzelnen erwarteten Testdienst lautet der unabhängige Telemetrieausdruck absent_over_time(ai_service_eligible_total{service="assistant"}[5m]). Benennen Sie den Alarm AISLIMissing und setzen Sie severity=ticket. In einer Flotte benötigen Sie ein Verzeichnis erwarteter Dienste sowie Prüfungen pro Dienst und der Scrape-Gesundheit: Ein globaler absent-Ausdruck erkennt kein fehlendes Mitglied, solange andere weiterhin exportieren. Fehlende Fehlerzähler, teilweise verlorene Targets und eingefrorene, aber vorhandene Zähler benötigen eigene Integritätsprüfungen. Ein Nenner von null bleibt undefiniert und darf nicht durch eine erfundene Fehlerfreiheit ersetzt werden.
Prüfen Sie Auslösung und Rücksetzung, nicht nur Syntax
Prometheus dokumentiert das Format für Regel-Unit-Tests, einschließlich expandierender Eingaben und stale-Samples. Die folgenden Fälle nutzen einminütige Samples und Auswertungen, ein service-Label und die beiden Recording Rules vor AIServiceFastBurn, ohne for und ohne keep_firing_for. Burn-Rate-Alarme tragen severity=page, Alarme für fehlende Zeitreihen severity=ticket. Für diese minimalen Assertions sind keine Annotationen erforderlich.
| Testfall | Werte für berechtigte / fehlerhafte Ereignisse | Auswertung | Erwartete aktive Alarme |
|---|---|---|---|
| Anhaltender Fehler | 0+100x120 / 0+2x120 | 60m | AIServiceFastBurn |
| Kurzer Ausschlag | 0+100x120 / 0+0x59 2+0x60 | 61m und 65m | Kein schneller Burn-Rate-Alarm |
| Wiederherstellung | 0+100x120 / 0+2x60 120+0x59 | 60m, danach 65m | Schneller Alarm aktiv, danach zurückgesetzt |
| Fehlende Telemetrie | 0+100x10 stale _x110 / 0+2x10 stale _x110 | 20m | AISLIMissing; kein schneller Burn-Rate-Alarm |
| Vollständiger Fehler bei geringer Last | 0+0.1x120 / 0+0.1x120 | 60m | Kein schneller Alarm: Mengenschwelle unterdrückt ihn |
| Keine Last | 0+0x120 / 0+0x120 | 60m | Keiner der Alarme; Exporter vorhanden, Dienstzustand unbekannt |
Die gebrochenen Zählerinkremente des Niedriglastfalls sind synthetische Eingaben zum Testen der Mengenschwelle, keine Behauptung über gebrochene Anfragen. Die Kurznotation x120 bezeichnet wiederholte Sample-Inkremente und kein produktives Lastmodell. Übernehmen Sie jeden Fall in input_series für ai_service_eligible_total{service="assistant"} und ai_service_bad_total{service="assistant"}; prüfen Sie die genannten Alarme über alert_rule_test. Für einen aktiven schnellen Alarm enthält exp_labels service=assistant und severity=page; eine leere Liste exp_alerts prüft dessen Abwesenheit. Setzen Sie rule_files auf Ihre Regeldatei und führen Sie promtool test rules tests.yml aus.
Ausgeführtes Ergebnis: Alle sechs Fälle bestanden. Der Test belegt Recording-, Vektormatching-, Schwellen- und Rücksetzverhalten für diese Eingaben. Er prüft weder Alertmanager-Zustellung noch Scrape-Planung, produktive Zählerintegrität, weitere Burn-Rate-Klassen oder die Eignung des SLO für Ihre Kunden. Ergänzen Sie vor dem Rollout Zählerresets, Replikwechsel, eine fehlende Fehlerzeitreihe, abweichende service-Labels, teilweise verlorene Telemetrie und Fehler nahe Auswertungsgrenzen.
Synthetischer Zeitverlauf: Wiederherstellung gehört zum Vertrag
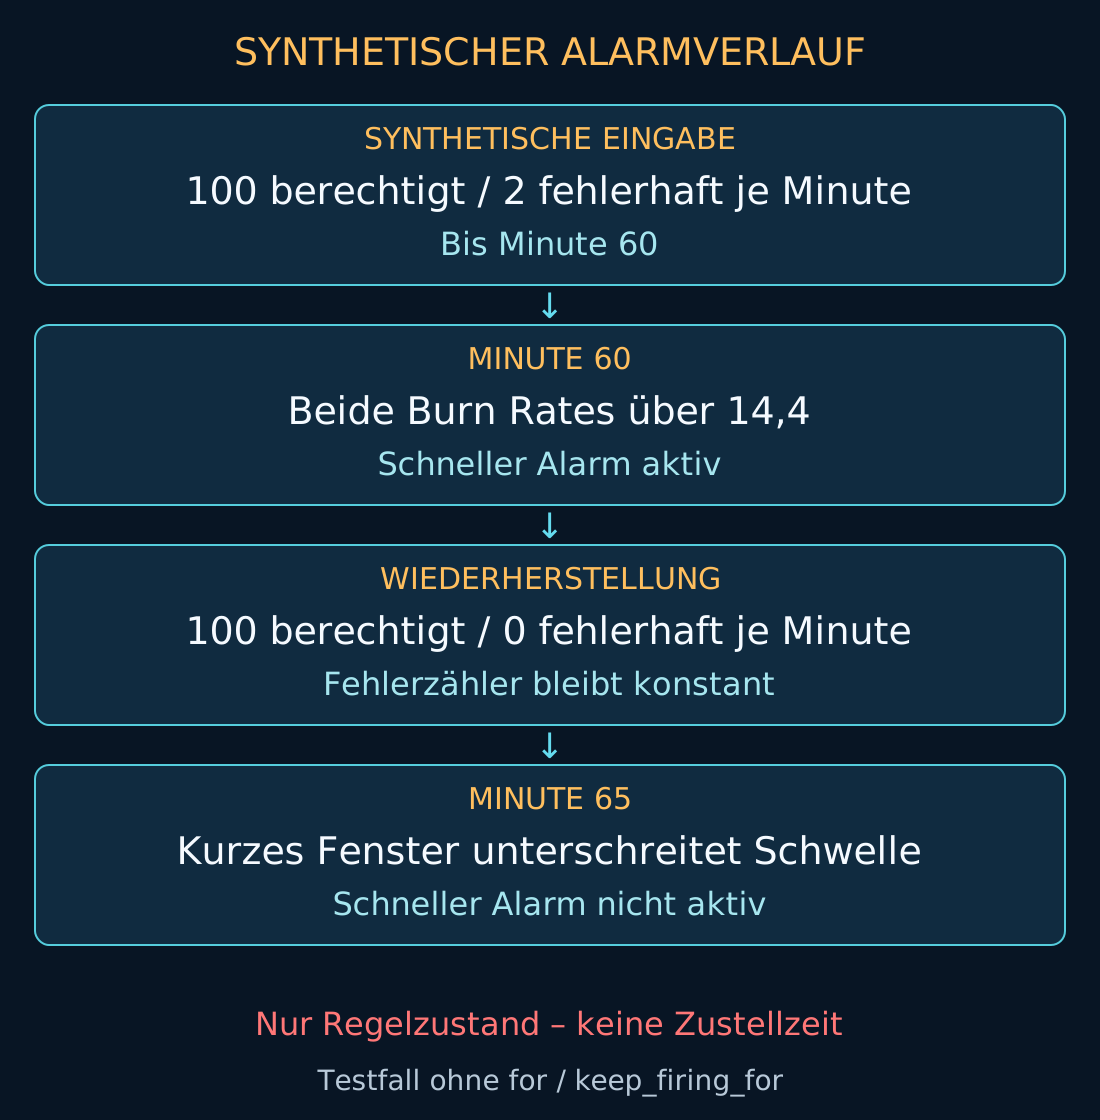
Der Wiederherstellungsfall ist ausdrücklich synthetisch: Bis Minute 60 steigen die Zähler pro Minute um 100 berechtigte und zwei fehlerhafte Ereignisse. In Minute 60 ist der schnelle Burn-Rate-Alarm aktiv. Danach steigen die berechtigten Ereignisse weiter, während der Fehlerzähler konstant bleibt. In Minute 65 ist die Kurzfensterbedingung falsch; der Alarm ist nicht mehr aktiv, obwohl das lange Fenster noch Ausfallhistorie enthält. Das beschreibt den Regelzustand, nicht die exakten Zustell- oder Auflösungszeitpunkte eines Bereitschaftssystems.
Die Prometheus-Dokumentation zu Alarmregeln unterscheidet for von keep_firing_for. Ersteres verlangt kontinuierlich aktive Auswertungen vor der Auslösung und ist kein weiteres Mittelungsfenster. Ein langes for kann einen Totalausfall verzögert melden und bei intermittierenden Fehlern immer wieder zurückgesetzt werden. keep_firing_for hält einen bereits ausgelösten Alarm nach Ende der Bedingung für eine festgelegte Zeit aktiv. Das kann Flattern reduzieren, verzögert aber bewusst die Auflösung. Keines der Felder repariert fehlende Instrumentierung. Wiederholen Sie die Zeitverlaufstests, wenn Sie eines ergänzen.
Ordnen Sie jedem Alarm eine Reaktion zu
Alertmanager gruppiert, dedupliziert und verteilt Alarme; Inhibition unterdrückt Benachrichtigungen, während ein verwandter Alarm aktiv ist. Keine dieser Funktionen verändert den SLI oder repariert eine Abhängigkeit. Wählen Sie einen begrenzten Gruppierungsschlüssel wie Dienst, Umgebung und Alarmfamilie. Fassen Sie nicht unabhängige Dienstverantwortliche in einer unübersichtlichen Benachrichtigung zusammen. Ein veränderlicher Fehlerwert gehört nicht in ein identitätsbildendes Alarm-Label.
Routing-Checkliste: Jeder Bereitschaftsalarm hat einen Verantwortlichen, ein aktuelles Runbook, eine Beschreibung der Nutzerauswirkung und eine sofort mögliche sichere Handlung. Tickets haben Verantwortliche und Reaktionsfristen. Wählen Sie group_wait, group_interval und repeat_interval passend zum Reaktionsziel und prüfen Sie tatsächliche Zustellzeitpunkte. Gruppierungsverzögerung kommt zu Scrape-, Auswertungs- und etwaigen for-Verzögerungen hinzu. Ein bestandener Prometheus-Regeltest beweist nicht, dass ein Empfänger konfiguriert oder erreichbar ist.
Wenn schnelle und langsame Alarmklassen gleichzeitig existieren, unterdrücken Sie redundante weniger dringliche Benachrichtigungen nur mit explizit übereinstimmenden Dienst- und Umgebungslabels. Verlangen Sie diese Labels auf beiden Alarmen; verlassen Sie sich nicht auf Gleichheit fehlender Labels. Nehmen Sie Telemetrieintegritätsalarme von pauschaler Abhängigkeits-Inhibition aus, solange unabhängige Gesundheitsüberwachung nicht nachgewiesen ist. Silences benötigen Umfang, Verantwortlichen, Grund und Ablaufzeit. Eine aufgelöste Benachrichtigung darf bei Telemetrieverlust nicht als nachgewiesene Dienstwiederherstellung gelten.
Automatische Gegenmaßnahmen bleiben eine separate Autorisierungsentscheidung. Die Freigabegrenze für AIOps-Remediation gilt auch bei einem begründeten Alarm. Messen Sie Erkennungs- und Zustellverzögerungen getrennt von Diagnose und Reparatur, wie in der MTTR-Aufschlüsselung. Weniger Alarme allein beweisen keine schnellere Wiederherstellung.
Standardisieren Sie erst nach einem belastbaren Dienstvertrag
Prüfen Sie zunächst Definitionen für berechtigte, erfolgreiche und fehlerhafte Ereignisse mit Produktverantwortlichen und Bereitschaftsleitung. Rollen Sie anschließend Zähler und Integritätsprüfungen ohne Alarmierung aus und untersuchen Sie tatsächliche Lastlücken. Führen Sie dann deterministische Regeltests und Ende-zu-Ende-Zustelltests einschließlich Silences, Inhibition und Wiederherstellung aus. Aktivieren Sie schließlich einen Dienst mit rücksetzbarer Regelrevision und expliziter Absicherung für geringe Last. Bewerten Sie übersehene Vorfälle ebenso wie Fehlalarme, bevor Sie die Regeln übertragen.
Die Abwägung ist bewusst: Mengenschwellen reduzieren Rauschen, aber auch Empfindlichkeit bei geringer Last. Zusätzliche Fenster erhöhen Zustand und Abfragekosten. Verlängerte Aktivität stabilisiert Alarme, verzögert aber deren Rücksetzung. Betriebliche Erfolgsmetriken beweisen weiterhin keine Antwortqualität. Behalten Sie für folgenreiche KI-Entscheidungen separate Qualitäts-, Sicherheits- und Freigabekontrollen bei, statt alles in eine Zuverlässigkeitsquote zu pressen.
Wenn Ihr KI-Dienst bei jedem vorgelagerten Modellfehler alarmiert, bringen Sie einen Nutzerablauf, den zugehörigen Zählervertrag und einen aktuellen Alarmzeitverlauf in eine Architekturprüfung ein. Ich unterstütze Sie dabei, daraus versionierte Recording Rules, ausführbare Auslöse- und Rücksetztests sowie eine verantwortete Bereitschafts- und Ticketregelung zu entwickeln – ohne ein ruhigeres Dashboard mit nachgewiesener Zuverlässigkeit gleichzusetzen.