BLUF — Chunked Prefill ist ein Scheduling-Kompromiss, keine Fairness-Garantie. Die Verarbeitung langer Prompts in Teilstücken kann laufende Ausgaben schützen. Sie sorgt aber nicht automatisch dafür, dass eine neu eintreffende kurze Anfrage zuerst bedient wird. Stimmen Sie das Token-Budget auf getrennte Anforderungen für kurze und lange Anfragen ab. Behalten Sie eine unveränderte Baseline bei und verwerfen Sie Durchsatzgewinne, die lediglich Wartezeit auf eine andere Klasse verschieben.
Die betriebliche Entscheidung lautet: Kann eine gemeinsame vLLM-Engine interaktive und dokumentenlastige Anfragen innerhalb ihrer jeweiligen Latenzgrenzen bedienen, oder benötigen Sie Zugangskontrollen und getrennte Kapazitäten? Dieser Leitfaden liefert eine konkrete Parameter-Sweep-Spezifikation, einen Messvertrag und ein Rollback-Manifest. Er enthält keine gemessenen GPU-Beschleunigungen: In der Veröffentlichungsumgebung sind weder eine vLLM-Laufzeit noch ein Inferenz-Endpunkt konfiguriert. Die folgenden Zahlen sind Versuchsparameter, keine Produktionsempfehlungen.
Was der Scheduler tatsächlich schützt
Der vLLM-Leitfaden zur Optimierung beschreibt, dass V1 Chunked Prefill aktiviert, soweit dies möglich ist. Bei aktivierter Funktion werden anstehende Decode-Schritte vor Prefill-Arbeit eingeplant. Das verbleibende Token-Budget verarbeitet einen Prefill oder einen Teil davon. Prefill erzeugt den Attention-Zustand für Eingabetokens. Decode erweitert eine bereits zugelassene Sequenz. Beide Phasen beanspruchen dieselbe Engine-Iteration, haben aber unterschiedliche Rechen- und Speicherprofile.
Das ist für eine kurze Chat-Anfrage hinter einem langen Dokument entscheidend. Vor ihrem ersten Token benötigt auch die Chat-Anfrage einen Prefill. Der Schutz laufender Decodes bedeutet nicht, dass diese neue Anfrage Vorrang erhält. Ein kleineres Teilstück kann eine Iteration verkürzen, ohne zu ändern, welcher wartende Prefill als Nächstes zum Zug kommt. Bezeichnen Sie Decode-Priorisierung deshalb nicht als Shortest-Job-First-Verfahren.
Die Dokumentation nennt kleinere Werte für max_num_batched_tokens als günstig für die Inter-Token-Latenz und größere Werte als günstig für Prefill-Fortschritt und TTFT. Das sind Tuning-Richtungen, keine Ergebnisgarantien unter beliebiger Last. Ein kleineres Budget kann mehr Iterationen für einen langen Prompt erfordern. Ein größeres Budget kann eine Iteration verlängern und damit das nächste Ausgabetoken verzögern. Warteschlangen, Kernel-Effizienz, Cache-Zustand und Zulassungsgrenzen können eine einfache Einzelanfrage-Beobachtung umkehren.
Die verlinkten Seiten sind die für diesen Artikel geprüfte Entwickler-Vorschaudokumentation. Vergleichen Sie vor jeder Änderung die Dokumentation Ihrer bereitgestellten Version, vllm serve --help und die tatsächlich wirksame Startkonfiguration. Übernehmen Sie weder neuere Optionen noch ältere Partial-Prefill-Flags ungeprüft in Ihr Serving-Image.
Scheduling-Zeitleiste statt Beschleunigungsdiagramm
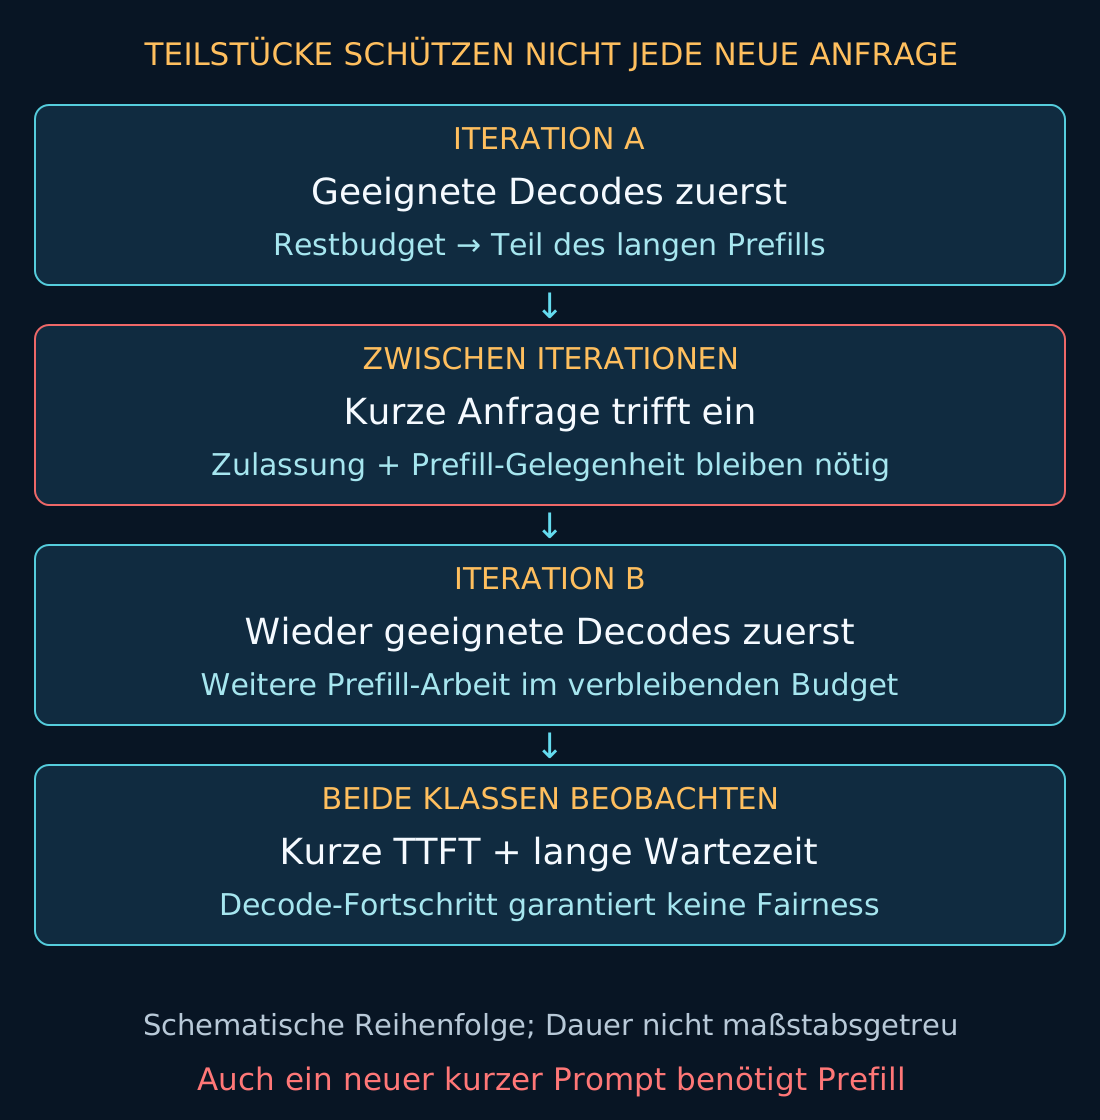
Lesen Sie die Zeitleiste als schematische Budgetzuordnung: Eine Iteration berücksichtigt zuerst geeignete Decode-Arbeit und weist verbleibende Kapazität Prefill-Arbeit zu. Ein unvollständiger langer Prefill benötigt weitere Verarbeitung. Eine neu eingetroffene kurze Anfrage braucht weiterhin eine Zulassung und eine Scheduling-Gelegenheit. Die Pfeile bedeuten weder unabhängige GPUs noch gleich lange Iterationen oder eine gemessene Reihenfolge sämtlicher Anfragen.
Der SLO-Leitfaden für selbst betriebene Inferenz definiert die nutzerseitige Messgrenze. Hier kommt das Scheduler-Experiment hinzu: Sie halten den Servicevertrag konstant und ändern ausschließlich das Batch-Token-Budget sowie die Sequenzgrenze der Engine. Die GPU-Auslastung zu maximieren ist nicht das Ziel.
Eine Lastmischung festlegen, die Benachteiligung sichtbar macht
Verwenden Sie zwei gekennzeichnete Eingabeklassen. Eine konkrete Ausgangsspezifikation sind 512 Eingabetokens für kurze und 8.192 für lange Anfragen, mit jeweils 128 Ausgabetokens. Tokenisieren Sie mit dem festgelegten Modell-Tokenizer; Zeichenanzahl und Tokenanzahl sind nicht gleichzusetzen. Halten Sie Prompt-Korpus, Reihenfolge, Modell- und Tokenizer-Revision, Chat-Template, Präzision, Beschleunigertyp und -anzahl, Parallelisierung, Speicherzuteilung und Generierungskonfiguration konstant. Verwenden Sie einen freigegebenen repräsentativen Korpus, keine Kundengeheimnisse in Benchmark-Protokollen.
Deaktivieren Sie Prefix-Wiederverwendung und spekulatives Decoding für einen isolierten Scheduler-Mikrobenchmark oder halten Sie deren geprüfte Einstellungen konstant. Andernfalls können gecachte lange Prompts oder veränderte Draft-Akzeptanz den Ressourcenkonflikt verdecken. Führen Sie realistische Cache-Tests separat durch. Der Beitrag zur Wirtschaftlichkeit von Prefix-Caching erläutert, warum eingesparte Prefill-Arbeit von schnellerer Einplanung tatsächlich ausgeführter Arbeit zu trennen ist.
Eine feste Obergrenze garantiert keine feste Ausgabelänge. In einem kompatiblen synthetischen Benchmark können unterstützte Generierungsoptionen eine exakte Länge erzwingen; kennzeichnen Sie das ausdrücklich als synthetisch. Bewahren Sie bei einem realistischen Replay tatsächliche Ausgabelängen und Abbruchgründe auf und vergleichen Sie entsprechende Längengruppen. Weniger ausgegebene Tokens sind kein Nachweis für besseres Scheduling.
Verwenden Sie eine Open-Loop-Ankunftsspur, deren Zeitpunkte unabhängig von Antwortabschlüssen sind. Spielen Sie für jeden Kandidaten dieselbe Spur ab. Ein Closed-Loop-Test mit begrenzter Parallelität hilft bei der Sättigungsanalyse, verringert aber das Angebot, sobald Antworten langsamer werden, und kann wachsende Warteschlangen verbergen. Erfassen Sie geplante Ankunft, tatsächlichen Versand und clientseitige Zulassungsverzögerung. Kann der Lastgenerator nicht folgen, erklären Sie den Lauf für ungültig, statt seine Verzögerung dem Server zuzuschreiben.
Parameter-Sweep-Artefakt: explizite Zellen und konstante Kontrollen
Beginnen Sie mit der aktuell freigegebenen Konfiguration als B0, nicht mit einem vermuteten Bibliotheksstandard. Kombinieren Sie anschließend Token-Budgets von 2.048, 4.096 und 8.192 mit Sequenzgrenzen von 16 und 32. Prüfen Sie diese Beispielwerte vorab auf Speicher- und Modellkompatibilität. Die sechs Kandidaten unten sind unterschiedliche Serverkonfigurationen, keine Parallelitätsgrenzen des Clients.
| Versuchszelle | max_num_batched_tokens | max_num_seqs | Erforderlicher Vergleich |
|---|---|---|---|
| B0 | Erfasster Produktionswert | Erfasster Produktionswert | Unveränderte Rollback-Baseline |
| C1 | 2048 | 16 | Kleines Budget; niedrigere Sequenzgrenze |
| C2 | 2048 | 32 | Gleiches Budget; höhere Sequenzgrenze |
| C3 | 4096 | 16 | Mittleres Budget; niedrigere Sequenzgrenze |
| C4 | 4096 | 32 | Gleiches Budget; höhere Sequenzgrenze |
| C5 | 8192 | 16 | Großes Budget; niedrigere Sequenzgrenze |
| C6 | 8192 | 32 | Gleiches Budget; höhere Sequenzgrenze |
Die ausführbare Startvorlage je Kandidat lautet: vllm serve "$MODEL" --revision "$REVISION" --tokenizer-revision "$TOKENIZER_REVISION" --enable-chunked-prefill --max-num-batched-tokens "$B" --max-num-seqs "$S". Ergänzen Sie die exakt festgelegten Baseline-Argumente für Präzision, Parallelisierung, Kontextlänge, Speicher und Generierung. Die Vorlage ist kein vollständiges Deployment-Manifest. Starten Sie auf isolierter Testkapazität neu, prüfen Sie die wirksamen Werte in der Startausgabe und warten Sie Modell- sowie Kernel-Aufwärmung ab. Spielen Sie erst dann die feste Ankunftsspur ab. Starten Sie für diesen Sweep nicht wiederholt einen Produktionsdienst neu.
Testen Sie je Serverzelle ausschließlich kurze Anfragen, eine Mischung aus 80 Prozent kurzen und 20 Prozent langen Anfragen sowie eine 50/50-Mischung, jeweils nach Anfrageanzahl. Bestimmen Sie anhand von B0 eine niedrige und eine kapazitätsnahe Angebotsrate und verwenden Sie diese für sämtliche Kandidaten. Passen Sie die Angebotsrate nicht für jeden Kandidaten so lange an, bis er gesund aussieht. Wiederholen Sie die Spuren in drei Runden mit zufälliger Zellreihenfolge. Trennen Sie Aufwärmung, Messfenster und begrenzte Auslaufphase. Aus sieben Serverzellen, drei Mischungen, zwei Raten und drei Wiederholungen entstehen 126 geplante Läufe. Das sind keine 126 ausgeführten GPU-Messungen.
Ein maschinenlesbarer Sweep-Datensatz sollte run_id, cell_id, repeat, trace_sha256, corpus_sha256, image_digest, model_revision, tokenizer_revision, hardware_id, effective_args, warmup_seconds, observation_seconds und drain_deadline_seconds enthalten. Speichern Sie Messwerte getrennt von Konfigurationen. Lassen Sie TTFT- und Durchsatzfelder weg, bis ein echter Lauf sie liefert. Null ist ein Messergebnis, kein Ersatz für fehlende Evidenz.
Jede Klasse messen, ohne Labels zu erfinden
Die Referenz für Produktionsmetriken nennt TTFT, Inter-Token-Latenz, Anfrage-Wartezeit, wartende Anfragen, KV-Cache-Belegung und Preemption-Metriken. Prüfen Sie zuerst die tatsächliche /metrics-Ausgabe Ihrer Installation. Unterstellen Sie nicht, dass jedes Engine-Histogramm bereits ein Label für kurze oder lange Anfragen enthält. Erfassen Sie die Klasse am Gateway oder Benchmark-Client und korrelieren Sie sie mit freigegebener anfragebezogener Telemetrie, sofern diese unterstützt wird. Prompt-Text, Mandantenidentitäten und unbeschränkt viele Anfrage-IDs gehören nicht in Prometheus-Labels.
Berichten Sie p50/p95/p99 für TTFT und Ende-zu-Ende-Latenz getrennt nach Klassen, dazu Stichprobengröße, Fehler, Timeouts und Abbrüche. Die Server-Wartezeit ist nur eine Komponente. Clientseitige TTFT kann zusätzlich Transport, Gateway-Wartezeit, Tokenisierung und Prefill umfassen. Für das aktuelle Alter der ältesten wartenden Anfrage benötigen Sie Erfassungszeitpunkte beim Einreihen. Ein Histogramm abgeschlossener Wartezeiten zeigt keine Anfrage, die die Warteschlange nie verlässt.
Unterscheiden Sie beim Streaming Engine-Token-Latenz von Ankunftsabständen zwischen Netzwerk-Chunks. Ein Chunk kann mehrere Tokens enthalten oder durch einen Proxy gepuffert sein. Kennzeichnen Sie clientseitige Chunk-Abstände entsprechend. Nutzen Sie echte Token-Zeitpunkte nur, wenn Ihre Instrumentierung sie liefert. Erfassen Sie neben gepoolten Perzentilen auch die längste Unterbrechung je Anfrage, damit lange Antworten nicht die gesamte Auswertung dominieren.
Definieren Sie Klassen-Goodput als Antworten, die Aufgabenvalidierung und sämtliche Klassen-Latenzgrenzen bestehen, geteilt durch die feste Beobachtungsdauer. Ordnen Sie die Kohorte nach Ankunft innerhalb dieses Fensters zu. Abgewiesene Anfragen bleiben im Nenner des angebotenen Verkehrs. Halten Sie unvollständige Anfragen sichtbar und wenden Sie die vorher festgelegte Auslauffrist an. Berichten Sie neben Goodput auch den Anteil akzeptierter an angebotenen Anfragen und verspätete Abschlüsse. Wer Timeouts oder weiterhin wartende Anfragen entfernt, lässt eine überlastete Engine künstlich schnell aussehen.
Erfassen Sie Preemption-Zähler vor und nach dem Lauf und berücksichtigen Sie Neustarts. Ein Zählerdelta gilt für die gesamte Engine, solange eine anfragebezogene Zuordnung nicht geprüft ist. Korrelieren Sie es mit Klassenergebnissen. Schreiben Sie nicht jede Preemption der langen Klasse zu, nur weil lange Prompts vorhanden sind. Zunehmende Neuberechnung kann den scheinbaren Vorteil zusätzlicher gleichzeitiger Sequenzen aufheben.
Entscheidungstabelle: Welcher Fehler rechtfertigt welche Änderung?
| Beobachtung | Zuerst prüfen | Mögliche Maßnahme | Ablehnungsgrund |
|---|---|---|---|
| Streaming stockt; Prefill kommt voran | Token-Zeitpunkte gegenüber Proxy-Pufferung | Kleineres Token-Budget testen | Lange Klasse verletzt TTFT- oder Goodput-Vertrag |
| Neue kurze Anfragen warten; Streams laufen | Zulassungsreihenfolge und älteste Wartezeit | Eingang begrenzen; geprüfte Priorität oder Isolation testen | Kleineres Chunk-Budget wird allein als Fairness verkauft |
| Mehr Preemptions bei höherer Sequenzgrenze | KV-Druck und Zähler-Neustarts | Weniger gleichzeitige Sequenzen testen | Speicher reicht nur durch wiederholte Neuberechnung |
| Gesamtdurchsatz steigt; eine Klasse verliert | Angebot und Fehler je Klasse | B0 behalten oder Kapazitätsgrenze ändern | Eine harte Klassengrenze wird verletzt |
| Lange Anfragen enden unter Stress nie | Unvollständige Wartezeiten und Zulassung | Wartezeit begrenzen; geeignete Kapazität reservieren | Erfolgsperzentile verbergen dauerhafte Verdrängung |
| Beide Klassen bestehen ohne relevanten Gewinn | Laufstreuung und Betriebskosten | Einfachere Baseline behalten | Zusätzliche Regeln ohne gemessenen Nutzen |
Isolation und Priorität haben ebenfalls Kosten
Die Referenz der Engine-Argumente dokumentiert FCFS und Priority Scheduling. Ein niedrigerer numerischer Prioritätswert wird früher berücksichtigt; bei Gleichstand entscheidet die Ankunftszeit. Prüfen Sie die Unterstützung über den tatsächlichen API-Pfad und die genaue Version. Ein vom Gateway verworfenes Prioritätsfeld ist keine wirksame Regel. Lassen Sie ein authentifiziertes Gateway die Priorität aus freigegebenen Serviceklassen ableiten, statt Aufrufern eine freie Dringlichkeitseinstufung zu erlauben.
Priorität allein verspricht weder begrenzte Wartezeit noch Schutz vor dauerhafter Verdrängung. Testen Sie eine anhaltende Flut hoch priorisierter Anfragen und beobachten Sie das Alter der ältesten niedriger priorisierten Anfrage, Fristüberschreitungen und Abweisungen. Explizite Wartezeitgrenzen oder reservierte Kapazität können notwendig sein. Getrennte Deployments liefern eine klarere Kapazitätsgrenze, können aber Kapazität ungenutzt lassen und zusätzliche Replikate, Routing-, Überwachungs- und Rollout-Arbeit verursachen. Zwei Aliase auf derselben überlasteten Engine sind keine Ressourcenisolation.
Erhalten Sie mit einer Entscheidungslogik für Model Routing die freigegebenen Modell- und Datenverarbeitungsgrenzen beim Verschieben von Verkehr. Ein Scheduler-Vorfall erlaubt weder ein qualitativ schwächeres Modell noch eine andere Datenregion. Zulassungsgrenzen benötigen einen absichtlichen Fehlervertrag. Unbegrenzte automatische Wiederholungen verlagern die Überlastung lediglich nach vorn.
Rollback-Manifest und Abnahmecheckliste
Speichern Sie Image-Digest der Baseline, Modell- und Tokenizer-Revisionen, vollständige wirksame Argumente, Deployment-Revision, Routing-Ziel, Health-Probe, Kapazitätszuweisung, Auslauffrist, Abbruchschwellen und Verantwortlichen. Kandidatenwerte sind eine Änderung an diesem unveränderlichen Datensatz, kein aus dem Gedächtnis rekonstruiertes Ersatzmanifest. Legen Sie Cache- und Spekulationseinstellungen ausdrücklich fest. Ein Neustart mit neuen Standardwerten ist kein Rollback.
Prüfung 1 — Gültigkeit: Alle geplanten Zellen verwenden denselben freigegebenen Korpus, dieselben Ankunftsspuren, dieselbe Hardware und dieselben Generierungseinstellungen. Kennzeichnen Sie ausgelassene oder inkompatible Zellen als ungültig, nicht als bestanden. Prüfen Sie, ob Versandverzögerungen des Clients und Messlücken innerhalb der vorab definierten Toleranz bleiben.
Prüfung 2 — Abnahme: Beide Klassen erfüllen bei vereinbarter Angebotslast ihre TTFT-, Streaming-, Abschluss-, Fehler- und Qualitätsanforderungen. Vergleichen Sie die Streuung wiederholter Läufe, nicht nur den schnellsten Lauf. Ein Gewinn in einer Klasse darf nicht stillschweigend eine harte Grenze der anderen Klasse lockern.
Prüfung 3 — Fehler: Testen Sie einen Burst langer Prompts, anhaltenden Decode-Druck, eine Eingabe an der unterstützten Kontextgrenze, Client-Abbruch und KV-Druck. Fordern Sie begrenzte Zulassung und sichtbare unvollständige Arbeit. Eine endliche Stichprobe ohne erfasstes Warteschlangenalter belegt keine Fairness.
Prüfung 4 — Wiederherstellung: Führen Sie einen Canary hinter einem umkehrbaren Routing durch, halten Sie Baseline-Kapazität bereit und proben Sie die Rückleitung neuer Anfragen bei begrenztem Auslaufen bestehender Streams. Definieren Sie, wie verbleibende Streams nach Fristablauf beendet werden. Aufwärmung und Cache-Verlust können eine Prefill-Spitze auslösen. Rollback-Kapazität muss deshalb tatsächlich vorhanden sein.
Bringen Sie für ein Architekturreview eine bereinigte Ankunftsspur, das wirksame Serving-Manifest und getrennte Latenzanforderungen für kurze und lange Anfragen mit. Das Ergebnis ist eine reproduzierbare Entscheidung: beibehalten, nachjustieren oder isolieren. Bis diese Evidenz vorliegt, behalten Sie die Baseline. Feinere Arbeitsteilung beweist noch keinen faireren Dienst.