BLUF: Prüfen Sie vor der Bewertung eines industriellen Inspektionsmodells, ob unabhängige Prüfpersonen die Referenzentscheidung reproduzieren können. Bewahren Sie Erstentscheidungen auf, lassen Sie eine verblindete Teilmenge erneut bewerten und untersuchen Sie Abweichungen vor der fachlichen Klärung. Übereinstimmung misst Konsistenz – weder Richtigkeit noch eine Obergrenze der Modellgenauigkeit oder die Berechtigung zur Teilefreigabe. Ein Modell kann einer fehlerhaften Referenz widersprechen und trotzdem richtig liegen; zwei Prüfpersonen können denselben Defekt übersehen.
Dieses Umsetzungsmuster betrifft eine kategoriale Entscheidung pro Bauteil unter einer benannten Prüfspezifikation. Das Zahlenbeispiel wurde mit synthetischen Häufigkeiten ausgeführt, nicht mit Werksmessungen. Die Qualitätsverantwortlichen müssen Fehlerkritikalität, Stichproben und Freigabekriterien festlegen. Sicherheitsvalidierung und gegebenenfalls erforderliche rechtliche Prüfung bleiben eigenständige Aufgaben.
Definieren Sie die Entscheidung vor der Prüferauswahl
Halten Sie Produktfamilie, Oberflächenbereich, erlaubte Ansichten, Beleuchtungsbedingungen und Konformitätsregel fest. Ein Kratzer oberhalb eines Maßgrenzwerts ist ein anderes Zielmerkmal als jede sichtbare Oberflächenmarkierung. Fixieren Sie die Version der Bewertungsrichtlinie und ergänzen Sie Grenzfälle mit einer Erklärung, welches Messverfahren den Fall entscheidet. Machen Sie aus einer unklaren visuellen Präferenz kein binäres Ziel, nur weil das Annotationstool eine Auswahl verlangt.
Trennen Sie vier Aspekte: kategoriale Entscheidung, Defekttyp und Schweregrad, Prüfbarkeit des Bildes sowie ungeklärte Unsicherheit. Ein unscharfes Bild belegt kein konformes Bauteil. Ein prüfbares, aber mehrdeutiges Merkmal ist nicht automatisch ein Defekt. Bewahren Sie ungeklärte und nicht prüfbare Fälle mit Begründung sowie einem autorisierten Sperr- oder Ersatzprüfverfahren auf. Berechnen Sie die binäre Übereinstimmung nur für die deklarierte auswertbare Teilmenge und nennen Sie daneben die ausgeschlossenen Fälle.
Diese Prüfung liegt vor der Kalibrierung von Defekt-Scores und Ausschussschwellen. Kalibrierung setzt ein sinnvolles Zielmerkmal voraus. Sie repariert keine Referenz, deren Bedeutung zwischen Prüfpersonen wechselt.
Planen Sie eine verblindete Studie mit Wiederholungen
Ziehen Sie eine repräsentative Produktionsstichprobe über relevante Lose, Schichten, Oberflächen und Kamerabedingungen. Ergänzen Sie eine separat gekennzeichnete Belastungsstichprobe für seltene Defekte und Grenzfälle. Leiten Sie aus deren angereicherter Klassenverteilung keine Produktionsprävalenz ab. Eine universell ausreichende Stichprobengröße gibt es nicht: Der Qualitätsverantwortliche muss festlegen, welche folgenreichen Abweichungen die Studie erkennen soll und welche Unsicherheit vertretbar ist.
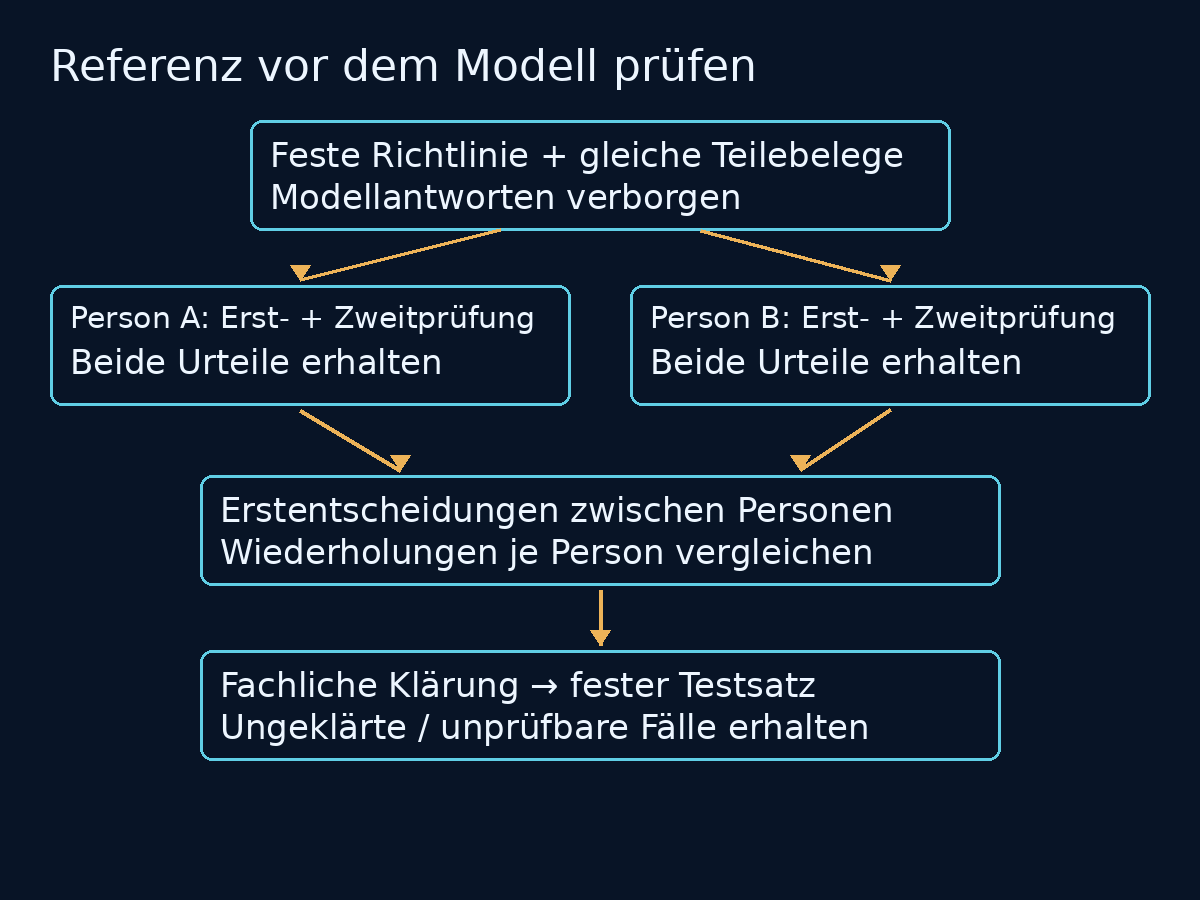
Geben Sie zwei qualifizierten Prüfpersonen unabhängig dieselben freigegebenen Informationen. Verbergen Sie Modellvorhersagen, historische Entscheidungen und die Antwort der jeweils anderen Person. Randomisieren Sie die Reihenfolge. Lassen Sie eine verdeckte Teilmenge nach einem begründeten Abstand erneut bewerten, mit neuen Präsentationskennungen zur Verringerung von Erinnerungs- und Reihenfolgeeffekten. Die stabile Bauteil-ID bleibt im geschützten Studienmanifest. Eine weitere Aufnahme desselben Bauteils darf im Bericht nicht als unabhängiges neues Bauteil erscheinen.
Die Reproduzierbarkeit zwischen Prüfpersonen vergleicht die Erstentscheidung von A mit der Erstentscheidung von B am selben Bauteil. Die Wiederholbarkeit innerhalb einer Person vergleicht deren Erst- und Wiederholungsentscheidung, getrennt für A und B. Gemeinsame Schulung kann Konsistenz verbessern, aber auch gemeinsame Irrtümer erzeugen. Dokumentieren Sie Schulungs- und Richtlinienversionen, statt Übereinstimmung als unabhängige Validierung zu interpretieren.
Speichern Sie Bauteil-ID, Los-ID, Bild-Hash, Ansichtskonfiguration, Richtlinienversion, Prüferpseudonym, Durchgang, kategoriale Entscheidung, Defektschwere, Prüfbarkeit, Unsicherheitsgrund und Zeitstempel. Bewahren Sie die Erstentscheidung unveränderlich auf. Erfassen Sie die fachliche Klärung als neues verknüpftes Ereignis, nicht als Überschreibung. Das Muster für Datenherkunft und Qualitäts-Gates liefert die übergeordnete Grundlage dieser Nachweiskette.
Lesen Sie die Abweichungsmatrix vor dem Kappa-Wert
Das ausgeführte unausgewogene Beispiel enthält 100 gepaarte auswertbare Entscheidungen. Die Zeilen gehören zu Prüfperson A, die Spalten zu Prüfperson B. Keine Achse ist die gesicherte Wahrheit. In jeder Abweichungsrichtung liegen fünf Teile; diese zehn Fälle benötigen Untersuchung, nicht die automatische Übernahme der Antwort der dienstälteren Person.
| Prüfperson A / Prüfperson B | Konform | Defekt | Zeilensumme |
|---|---|---|---|
| Konform | 89 | 5 | 94 |
| Defekt | 5 | 1 | 6 |
| Spaltensumme | 94 | 6 | 100 |
Die Confusion-Matrix-API von scikit-learn liefert die Zählkonvention: Zeilen folgen der ersten Eingabe, Spalten der zweiten, mit expliziter Klassenreihenfolge. Ihre Parameternamen beziehen sich auf Wahrheit und Vorhersagen. Die Übergabe zweier Prüfpersonen macht die erste jedoch nicht zur Wahrheit. Beschriften Sie das Ergebnis als Kontingenztabelle der Prüfpersonen, nicht als falsch-positive oder falsch-negative Modellentscheidungen.
Die beobachtete Übereinstimmung ist die Diagonalsumme geteilt durch die Zahl gepaarter auswertbarer Teile: 90/100 = 90 %. Bewahren Sie die Abweichungszahlen nach Richtung, Defekttyp, Schweregrad und Produktionssegment auf. Dieselbe Gesamtzahl kann eine umstrittene kosmetische Oberfläche oder einen umstrittenen strukturellen Riss betreffen; die betriebliche Reaktion sollte nicht identisch sein. Zeigen Sie bei mehreren Defektklassen sämtliche Klassenpaare, statt die verwechselten Kategorien zu verbergen.
Gleiche Übereinstimmung, sehr unterschiedliches Kappa
Cohens Kappa ist (p_o − p_e)/(1 − p_e). Dabei bezeichnet p_o die beobachtete Übereinstimmung; p_e wird aus den empirischen Randverteilungen beider Prüfpersonen berechnet. Das synthetische Testskript berechnet diese Größen zunächst mit exakten rationalen Zahlen und wandelt sie anschließend zur Anzeige um.
Bei der Matrix [[45, 5], [5, 45]] ordnen beide Personen jeweils die Hälfte der Teile jeder Klasse zu: p_o = 0,90, p_e = 0,50 und Kappa = 0,80. Bei der dargestellten unausgewogenen Matrix [[89, 5], [5, 1]] bleibt p_o bei 0,90, aber p_e = 0,8872 und Kappa beträgt ungefähr 0,1135. Die Abweichungszahl ist unverändert; die Randverteilung der Klassen hat sich verändert. Keines der Ergebnisse begründet einen universellen Grenzwert für „gutes Kappa“ oder eine Aussage zur Modellgenauigkeit.
Der dritte ausgeführte Fall lautet [[100, 0], [0, 0]]. Beide Personen bewerten alles als konform: Die beobachtete Übereinstimmung beträgt 100 %, p_e ist 1 und Kappa ist wegen des Nenners null nicht definiert. Das Testskript gibt null mit ausdrücklicher Kennzeichnung als undefiniert zurück, nicht den Zahlenwert null oder perfektes Kappa. Die abgerufene scikit-learn-Dokumentation beschreibt replace_undefined_by ab Version 1.9; prüfen Sie Ihre installierte Version vor Verwendung dieses Arguments. Eine andere Ersatzwert-Einstellung erzeugt keinen Nachweis für eine nie beobachtete Defektklasse.
Zur Reproduktion lautet der Rechenkern: n = Summe aller Zellen; p_o = Diagonalsumme / n; p_e = Summe von Zeilensumme[Klasse] × Spaltensumme[Klasse] / n²; bei p_e = 1 ist das Ergebnis undefiniert, sonst (p_o − p_e)/(1 − p_e). Assertions prüfen beide Zahlenbeispiele und den undefinierten Fall. Diese Punktschätzungen quantifizieren keine Stichprobenunsicherheit. Berücksichtigen Sie bei der Auswahl eines Unsicherheitsverfahrens wiederholte Teile und Losabhängigkeiten. Jede Ansicht als unabhängig zu behandeln, überschätzt die Evidenz.
Übersetzen Sie Befunde in Freigabeentscheidungen
| Befund | Zuerst untersuchen | Konsequenz für die Freigabe |
|---|---|---|
| Dieselbe Person ändert Antworten | Richtliniengrenze, Sichtbedingungen, Erinnerungseffekte | Wiederholbarkeit vor Modellbewertung klären |
| Uneinigkeit bei kritischen Defekten | Definition und unabhängiger Messnachweis | Betroffene Abnahmeaussage sperren; fachlich klären |
| Übereinstimmung nur bei einer Klasse | Fehlende Klassenabdeckung und Stichprobe | Keine Defektleistungs-Aussage aus diesem Segment |
| Bild ist nicht prüfbar | Aufnahme und alternatives Prüfverfahren | Außerhalb des Binär-Scores; Anzahl erhalten |
| Richtlinie ändert sich nach Klärung | Umfang der Neubewertung und unberührter Testsatz | Referenznachweise vor Vergleich erneuern |
Die fachliche Klärung muss widersprüchliche Nachweise und Spezifikation bewerten, nicht lediglich Stimmen zählen. Binden Sie eine verantwortliche Fachperson und gegebenenfalls eine rückführbare Maßprüfung oder ein anderes unabhängiges Prüfverfahren ein. Bewahren Sie Entscheidung, Begründung, Belege und verbleibende Unsicherheit auf. Eine Mehrheit kann denselben blinden Fleck haben; auch ein Messverfahren hat Kalibrierungs- und Auflösungsgrenzen.
Entfernen Sie schwierige Fälle niemals nur, um die Übereinstimmung zu verbessern. Berichten Sie, wie viele geklärt wurden, ungeklärt blieben oder andere Nachweise benötigten. Wenn die abschließend bewertete Teilmenge mehrdeutige Teile ausschließt, gilt die spätere Modellaussage nur für diese auswertbare Population. Das Betriebssystem benötigt trotzdem einen sicheren Weg für ausgeschlossene Fälle.
Ersetzen Sie Kappa nicht durch einen Plattform-Konsenswert
Die Dokumentation zur Task-Übereinstimmung in Label Studio Enterprise unterscheidet paarweise Übereinstimmung, Konsens, einzelne Annotationsfelder und Gesamtaggregation. Der paarweise Mittelwert kategorialer exakter Treffer entspricht nicht Cohens zufallsbereinigtem Kappa. Ein Gesamtscore kann zudem unterschiedliche Annotationsfelder mit konfigurierbaren Gewichten mischen. Exportieren Sie Metrikdefinition und Konfiguration zusammen mit dem Ergebnis; ein Dashboard-Prozentwert ohne diese Angaben ist kein reproduzierbarer Nachweis.
Bounding Boxes und Segmentierungen benötigen ein explizites Verfahren zur Zuordnung von Regionen und Bewertung geometrischer Ähnlichkeit, beispielsweise anhand ihrer Überlappung. Nicht zugeordnete Objekte und Klassenunterschiede gehören dazu. Wenden Sie kategoriales Kappa auf Teilebene nicht direkt auf Koordinaten an. Übereinstimmung bei „Defekt vorhanden“ belegt keine Übereinstimmung der Defektgrenzen. Ordinale Schweregrade können gewichtetes Kappa rechtfertigen; die Gewichtung enthält jedoch eine Annahme über Konsequenzen und muss vor der Ergebnisbetrachtung begründet werden.
Fixieren Sie die Referenz, bevor Sie das Modell bewerten
Freigabecheckliste – Erstens: Prüfspezifikation, Qualifikation, Stichprobenrahmen und Ausnahmewege genehmigen. Zweitens: Unabhängige Erstentscheidungen und Wiederholbarkeitsergebnisse erhalten. Drittens: Gerichtete Abweichungen und kritische Segmente mit ihren Nennern prüfen, nicht nur die Gesamtübereinstimmung. Viertens: Fachliche Klärungen und offene Fälle ohne Überschreiben der Historie dokumentieren. Fünftens: Referenzmanifest und Richtlinie vor dem Modellabnahmetest einfrieren.
Nutzen Sie Entwicklungsdaten zur Überarbeitung der Richtlinie und Schulung. Sobald das Verfahren stabil ist, wenden Sie es auf eine zurückgehaltene Abnahmekohorte an; Modellantworten bleiben während der Referenzerstellung verborgen. Optimieren Sie Modell oder Schwellen nicht anhand von Abnahmefehlern, um dieselbe Kohorte anschließend erneut als unabhängigen Nachweis zu verwenden. Bei wesentlicher Richtlinienänderung müssen betroffene Abnahmenachweise kontrolliert neu bewertet werden.
Verknüpfen Sie Referenzversion, Modell, Vorverarbeitung und Abnahmebericht im Freigabe- und Rollback-Paket für Fertigungsmodelle. Öffnen Sie die Prüfung erneut, wenn Kameras, Oberflächen, Spezifikationen oder Prüfabläufe wechseln. Das verursacht zusätzlichen Annotations- und Klärungsaufwand, macht aber eine fehlerhafte Referenz sichtbar, bevor daraus eine irreführende Modellleistungs-Aussage wird.
Ein sinnvoller Einstieg ist eine Produktfamilie mit einer strittigen Defektdefinition. Bringen Sie Prüfrichtlinie, verblindete gepaarte Entscheidungen, Loskennungen und das bestehende Sperrverfahren mit. Ich unterstütze Sie dabei, eine Referenzlabel-Prüfung und die Bewertung der Freigabenachweise zu strukturieren. Das nützliche Ergebnis kann eine präzisere Spezifikation oder ein unabhängiger Messweg sein – nicht zwangsläufig ein höherer Modellscore.