BLUF: Ein Score aus der visuellen Qualitätsprüfung ist nicht automatisch eine Defektwahrscheinlichkeit. Und eine kalibrierte Wahrscheinlichkeit ist noch keine Anweisung zum Ausschleusen. Trennen Sie drei Artefakte: das Modell zur Bewertung der Teile, den Kalibrator zur Abbildung der Scores auf Wahrscheinlichkeiten unter definierten Produktionsbedingungen und die Entscheidungspolitik für Freigabe, Nachprüfung oder Ausschleusung. Maßgeblich sind durchgelassene Defekte, unnötiger Ausschuss und verfügbare Prüfkapazität – nicht eine voreingestellte Konfidenzschwelle.
Dieser Beitrag behandelt Qualitätsentscheidungen auf Teilebene, nicht Alarmschwellen für Predictive Maintenance. Das Vorgehen ist ein vorgeschlagenes Engineering-Muster auf Basis der scikit-learn-Dokumentation. Sämtliche Geldbeträge und dargestellten Wahrscheinlichkeiten sind ausdrücklich illustrative Annahmen: keine Werksmessungen, Kundenergebnisse oder empfohlenen Produktionswerte. Sicherheitskritische Prüfungen benötigen eine gesonderte fachliche Validierung und gegebenenfalls Konformitätsprüfung.
Klären Sie zunächst, was der Score bedeutet
Definieren Sie ein binäres Ziel: Ein Teil ist nach einer benannten Prüfspezifikation und einem festgelegten Referenzprüfverfahren nicht konform. Erfassen Sie Fehlerart und Schweregrad zusätzlich. Ein kosmetischer Makel und ein struktureller Riss dürfen nicht in einer undifferenzierten Kostenannahme für durchgelassene Defekte verschwinden. Liefert das Modell Pixel-Anomaliewerte, eine Bounding-Box-Konfidenz oder Bildähnlichkeiten, ist das noch keine „Wahrscheinlichkeit eines defekten Teils“. Legen Sie zuerst fest, wie Bilder, Ansichten und Detektionen zu einem Score pro Teil zusammengeführt werden.
Das Maximum mehrerer Ansichten verändert die Score-Verteilung. Eine andere Kameraanzahl, Zuschnittregel oder Aggregation verändert deshalb die Kalibrierungsaufgabe, selbst bei unveränderten Modellgewichten. Binden Sie den Kalibrator an die vollständige Vorverarbeitungs- und Aggregationspipeline. Halten Sie sämtliche Bilder eines Teils in derselben Evaluierungsgruppe. Andernfalls belohnt der Test möglicherweise das Wiedererkennen einer Oberfläche statt die Übertragbarkeit auf andere Teile.
Die Referenzarchitektur für Predictive Maintenance beschreibt das übergeordnete Muster aus Erfassung, Kontext, Bewertung und Ergebnisrückkopplung. Hier ist die unabhängige Entscheidungseinheit das geprüfte Teil. Das Ziel ist dessen Konformität, nicht ein zukünftiges Wartungsereignis.
Trennen Sie Modelltraining, Kalibrierung und Politikauswahl
Verwenden Sie Trainingsdaten, unabhängige Kalibrierungsdaten, einen Validierungsbestand zur Auswahl der Entscheidungspolitik und einen abschließenden Abnahmebestand. Diese vierfache Trennung ist eine konservative Empfehlung, keine Forderung nach gleich großen Partitionen. Bei knappen Labels kann eine verschachtelte, gruppenbewusste Kreuzvalidierung Entwicklungsdaten mehrfach nutzen. Jede zur Politikauswahl verwendete Wahrscheinlichkeit muss jedoch aus einem korrekt zurückgehaltenen Vorhersagepfad stammen. Bewahren Sie eine unberührte Abnahmeauswertung.
Gruppieren Sie nach der maßgeblichen Abhängigkeit: Teileidentität, Fertigungslos oder Aufnahmesitzung. Soll die Aussage für spätere Produktion gelten, halten Sie zusätzlich einen späteren Zeitraum zurück. Die offizielle GroupKFold-Dokumentation garantiert nicht überlappende Gruppen, aber keine chronologische Trainingsreihenfolge. Eine Loskennung verhindert allein nicht, dass zukünftige Bilder in einen Trainings-Fold gelangen.
Prüfen Sie die Klassenbesetzung jedes Folds. Ein Fold ohne Defekte kann die Leistung bei Defekten nicht belegen. Ein gezielt mit Schlechtteilen angereicherter Bestand eignet sich für anspruchsvolle Detektionstests. Ein auf dieser Mischung trainierter Kalibrator schätzt aber nicht automatisch Wahrscheinlichkeiten bei der tatsächlichen Defekthäufigkeit im Betrieb. Verwenden Sie repräsentative Produktionsstichproben oder ein begründetes Verfahren zur Korrektur der Stichprobenauswahl. Berichten Sie den Challenge-Test getrennt von der repräsentativen Abnahme.
Der Kalibrierungsleitfaden empfiehlt Daten, die unabhängig vom Klassifikatortraining sind. Die Sigmoid-Methode bietet eine stärker beschränkte Abbildung; isotone Regression ist flexibler, kann bei unzureichenden Daten aber überanpassen. Entscheiden Sie anhand zurückgehaltener Evidenz und nicht nach der vermeintlichen Überlegenheit einer flexibleren Kurve. Prüfen Sie die installierte Bibliotheksversion, bevor Sie eine konkrete API oder Methode übernehmen.
Lesen Sie das Zuverlässigkeitsdiagramm statt nur einer Verlustzahl
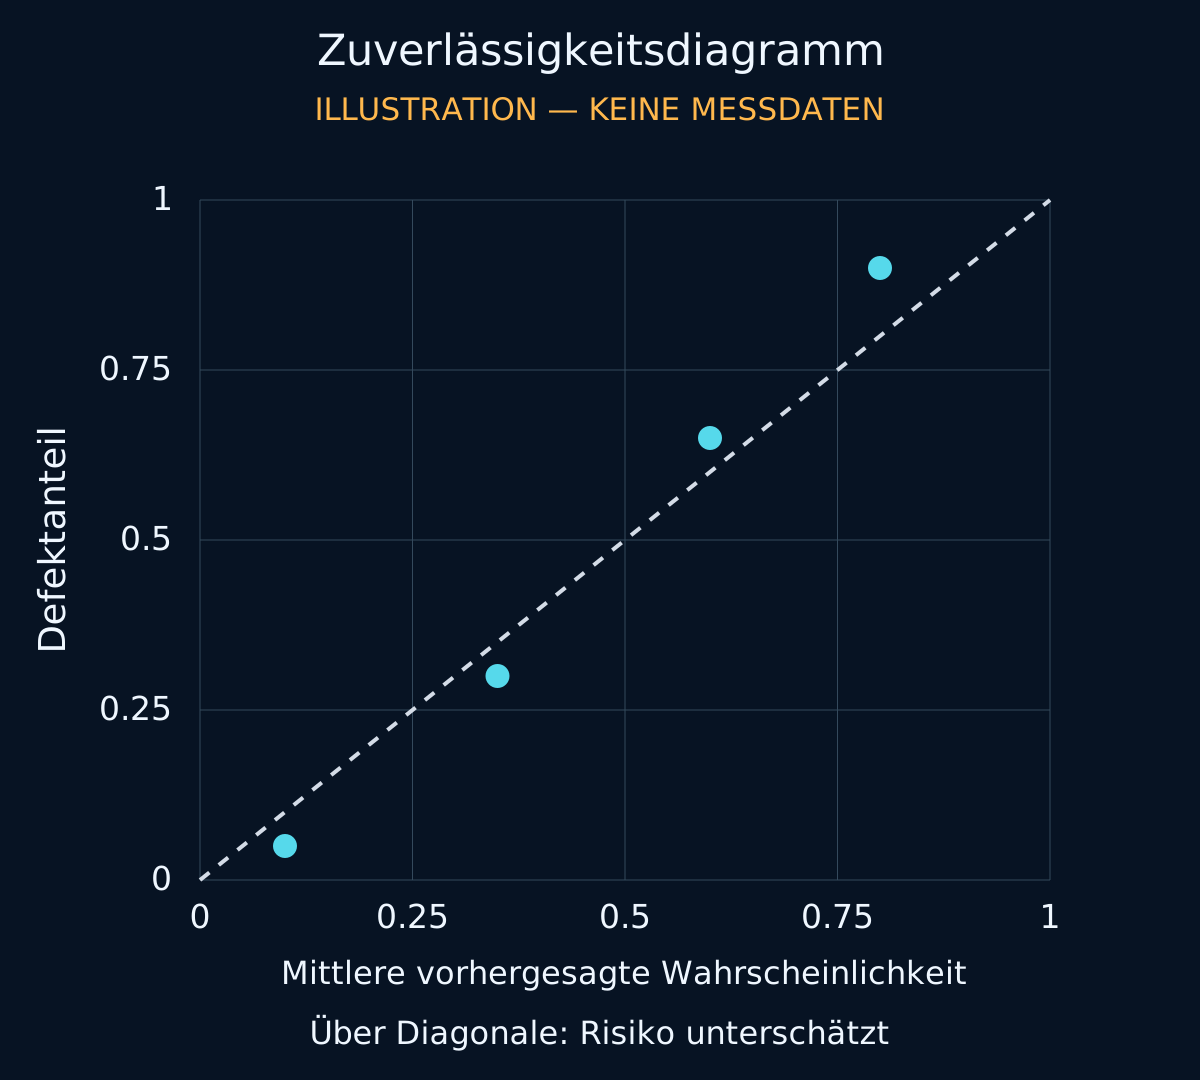
Im Zuverlässigkeitsdiagramm steht die horizontale Koordinate für die mittlere vorhergesagte Defektwahrscheinlichkeit eines Bins. Die vertikale Koordinate zeigt den beobachteten Defektanteil dieses Bins. Oberhalb der Diagonalen unterschätzt das Modell die Defekthäufigkeit, unterhalb überschätzt es sie. Zeigen Sie die Anzahl der Teile pro Bin. Leere oder sehr kleine Bins werden durch eine Verbindungslinie nicht belastbar.
Das beigefügte Diagramm nutzt ausdrücklich hypothetische Koordinaten, um diese Leseregel zu erläutern. Es belegt keine Verbesserung eines Prüfmodells. Für einen echten Bericht vergleichen Sie rohe und kalibrierte Vorhersagen auf denselben zurückgehaltenen Teilen, dokumentieren die Bin-Regel und berücksichtigen die Abhängigkeit innerhalb von Losen bei der Unsicherheit. Untersuchen Sie den Bereich niedriger Wahrscheinlichkeiten an der Freigabegrenze separat. Eine Darstellung über den gesamten Wertebereich kann gerade den Bereich verdecken, der über durchgelassene Defekte entscheidet.
Der offizielle Leitfaden zur Wahrscheinlichkeitskalibrierung warnt ausdrücklich: Der Brier-Verlust vermischt Zuverlässigkeit, Trennschärfe und Unsicherheit. Ein niedrigerer Brier-Verlust allein beweist keine bessere Kalibrierung. Berichten Sie Zuverlässigkeitskurven, Teile- und Defektzahlen, Brier-Verlust oder Log-Loss sowie Trennschärfemaße gemeinsam. Eine globale Kalibrierung kann zudem eine problematische Kamera oder Produktvariante verdecken. Unterteilen Sie die Auswertung nach den Bedingungen, die Sie tatsächlich freigeben wollen.
Übersetzen Sie Prüffehler in eine Entscheidungstabelle
p bezeichnet die kalibrierte Wahrscheinlichkeit eines defekten Teils innerhalb des validierten Betriebsbereichs. Für das Beispiel kostet die Freigabe eines defekten Teils 500 €, die Ausschleusung eines konformen Teils 20 € und eine manuelle Nachprüfung 3 €. Korrekte Freigabe und korrekte Ausschleusung haben gegenüber der gewählten Bezugsbasis keine zusätzlichen Kosten. Angenommen wird eine fehlerfreie Nachprüfung mit anschließend korrekter Zuordnung. Reale Prüfer sind weder fehlerfrei noch unbegrenzt verfügbar.
| Aktion | Kosten bei Konformität | Kosten bei Defekt | Erwartete Zusatzkosten |
|---|---|---|---|
| Freigeben | 0 € | 500 € für durchgelassenen Defekt | 500 × p |
| Nachprüfen, idealisiert | 3 € | 3 € | 3 |
| Ausschleusen | 20 € unnötiger Ausschuss | 0 € Bezugsbasis | 20 × (1 − p) |
Dies ist eine Kostenmatrix aus Aktion und tatsächlichem Zustand, keine gemessene Konfusionsmatrix. Verursacht die Ausschleusung eines tatsächlich defekten Teils zusätzliche Handhabungs- oder Entsorgungskosten, ergänzen Sie die Defektspalte und rechnen neu. Verwenden Sie für alle Zellen dieselbe wirtschaftliche Systemgrenze. Gewährleistung, nachgelagerte Nacharbeit und Eindämmungsmaßnahmen dürfen nicht doppelt eingehen. Qualitäts- und Finanzverantwortliche müssen die Annahmen freigeben. Data Science sollte den Tauschwert zwischen Defektdurchlass und Ausschuss nicht erfinden.
Ohne Nachprüfung sind die erwarteten Kosten bei 500p = 20(1 − p) gleich. Daraus folgt p = 20/520, also rund 3,85 %. Mit der idealisierten Nachprüfung liegt die Grenze zwischen Freigabe und Nachprüfung bei 3/500 = 0,6 %. Zwischen Nachprüfung und Ausschleusung liegt sie bei 1 − 3/20 = 85 %. Der breite Nachprüfbereich folgt aus der absichtlich günstigen und fehlerfreien Prüfung. Er ist kein sinnvoller Standardwert für eine Fertigungslinie.
| Bedingung | Illustrativ kostengünstigste Aktion | Betriebliche Voraussetzung |
|---|---|---|
| p unter 0,6 % | Freigeben | Gültiger Betriebsbereich und akzeptiertes Defektrisiko |
| p von 0,6 % bis einschließlich 85 % | Nachprüfen | Prüfkapazität vorhanden; Gleichstände gehen zur Nachprüfung |
| p über 85 % | Ausschleusen | Freigegebener Ausschleusweg und Teileverfolgbarkeit |
| Ungültiges Bild oder nicht freigegebenes Produkt | Außerhalb der Kostenregel sperren | Dokumentiertes Qualitäts-Notfallverfahren anwenden |
Bei p = 2 % betragen die erwarteten Kosten 10 € für die Freigabe, 3 € für die ideale Nachprüfung und 19,60 € für die Ausschleusung. Die kostengünstigste Aktion ist Nachprüfung, obwohl ein binärer Klassifikator mit Standardschwelle gewöhnlich „nicht defekt“ vorhersagen würde. Der Leitfaden zur Schwellenoptimierung trennt Wahrscheinlichkeitsschätzung und Handlung explizit. Seine Werkzeuge für binäre Schwellen implementieren allein noch keine kapazitätsbeschränkte Drei-Aktionen-Politik.
Machen Sie die Nachprüfwarteschlange zum Bestandteil der Politik
Ersetzen Sie die ideale Nachprüfung durch ein Betriebsmodell. e_miss bezeichnet die Wahrscheinlichkeit eines übersehenen Fehlers unter den tatsächlich defekten nachgeprüften Teilen. e_scrap bezeichnet die fehlerhafte Ausschleusung unter den konformen nachgeprüften Teilen. Die illustrativen erwarteten Kosten werden dann zu 3 + 500p × e_miss + 20(1 − p) × e_scrap. Schätzen Sie diese Fehler auf den Teilen, die tatsächlich in die Nachprüfung gelangen. Der mehrdeutige Teilbestand kann schwieriger sein als eine Zufallsstichprobe. Ergänzen Sie Verzögerungs- oder Sperrkosten, soweit relevant.
Kapazität kann die Rechnung bestimmen. Bei illustrativen 6.000 Teilen pro Stunde erzeugt ein Nachprüfanteil von 4 % genau 240 Prüfungen pro Stunde. Mit jeweils 45 Sekunden sind das drei Prüferstunden pro Zeitstunde – noch ohne Pausen, Handhabung und Schwankungen. Eine offline günstige Politik kann deshalb eine unbegrenzt wachsende Warteschlange erzeugen. Messen Sie im Schattenbetrieb Ankünfte, Bearbeitungszeit, Wartealter und späteste zulässige Teileentscheidung.
Erweitern Sie bei voller Warteschlange nicht stillschweigend die automatische Freigabe. Vereinbaren Sie mit der Qualitätsverantwortung ein Ersatzverfahren: betroffene Produktion sperren, eine freigegebene zweite Prüfung nutzen oder den Durchsatz reduzieren. Eine einfache Kostenrechnung bleibt verbindlichen Qualitätsgrenzen und der separat abgesicherten Anlagensteuerung untergeordnet. Der Beitrag zur Rationalisierung von Modellalarmen behandelt ein verwandtes Aufmerksamkeitsproblem. Die Nachprüfung benötigt jedoch Teileentscheidungen und Rückverfolgbarkeit statt Alarm-Deduplizierung.
Freigabeablauf und Abnahmecheckliste
Der Ablauf lautet: Teil und Prüfspezifikation identifizieren → Bildqualität und freigegebenes Kamera-/Produktregime prüfen → eingefrorenen Score pro Teil berechnen → passenden Kalibrator anwenden → Aktionskosten und Qualitätsgrenzen bewerten → freigeben, nachprüfen oder ausschleusen → abschließendes Referenzergebnis erfassen. Ungültige Eingaben verzweigen vor der wahrscheinlichkeitsspezifischen Entscheidung in die Sperrung. Ein Nachprüf-Timeout führt in das Qualitäts-Ersatzverfahren, nicht in eine implizite Freigabe.
Prüfpunkt 1 – Frieren Sie das Gesamtpaket ein: Modell, Vorverarbeitung, Mehransichten-Aggregation, Kalibrator, Entscheidungspolitik, Kostenannahmen, freigegebene Produkt-/Kamerabereiche und Rückfallversion. Protokollieren Sie die Paketkennung mit jeder Entscheidung, nicht nur die Modellversion.
Prüfpunkt 2 – Spielen Sie die vollständige Politik auf unberührten Abnahmelosen durch. Erstellen Sie eine beobachtete Matrix aus Aktion und tatsächlichem Zustand: konforme und defekte Teile je Freigabe, Nachprüfung und Ausschleusung. Zeigen Sie Gesamtzahlen, durchgelassene Defekte unter freigegebenen Teilen, unnötigen Ausschuss unter konformen Teilen und Nachprüfanteil unter allen zulässigen Teilen. Bewerten Sie das endgültige Nachprüfergebnis zusätzlich zur ersten Weiterleitung.
Prüfpunkt 3 – Benennen Sie Nenner und Ausschlüsse. Die Übersehensrate bezieht sich auf alle tatsächlich defekten zulässigen Teile. Der Defektanteil im freigegebenen Material bezieht sich auf alle freigegebenen Teile. Beide beantworten unterschiedliche Fragen. Halten Sie nicht prüfbare Teile und ausstehende Labels sichtbar. Null beobachtete durchgelassene Defekte beweisen kein Nullrisiko, besonders bei wenigen Defektfällen.
Prüfpunkt 4 – Testen Sie ungültige Bilder, Kamerawechsel, Beleuchtungsdrift, unbekannte Oberflächen, fehlende Teileidentität, volle Warteschlangen und verspätete Referenzlabels. Prüfen Sie die tatsächliche Durchsetzung der Sperr- oder Ersatzpfade und die Abstimmung jedes Teils. Optimieren Sie Schwellen nicht auf den Fehlern des letzten Abnahmesatzes, um denselben Satz anschließend als unabhängige Evidenz auszugeben.
Prüfpunkt 5 – Prüfen Sie auch freigegebene Teile nach einem Stichprobenplan, der die gewünschten Schätzungen unterstützt. Labels nur aus Ausschuss und Nachprüfung erzeugen selektive Rückkopplung und verbergen akzeptierte Defekte. Bewahren Sie Auswahlwahrscheinlichkeiten auf, wenn Gewichtung erforderlich ist. Nehmen Sie verspätete nachgelagerte Befunde auf, ohne frühere Berichte unbemerkt umzuschreiben.
Grenzen und ein praktischer Einstieg
Kalibrierung gilt nur relativ zur Datenverteilung und Zieldefinition, auf denen sie beruht. Beleuchtungsänderungen, neue Materialien und eine andere Defekthäufigkeit können die Abbildung entwerten. Neukalibrierung repariert kein Modell, das Gut- und Schlechtteile nicht mehr trennt. Eine andere Schwelle behebt keine widersprüchlichen Labels. Setzen Sie folgenreiche Nutzung außerhalb des freigegebenen Bereichs aus, bis die Evidenz eine Wiederaufnahme trägt.
Beginnen Sie mit einer Produktfamilie, einer Konformitätsdefinition und einer expliziten Teileentscheidung. Benötigt werden Bildidentitäten auf Losebene, adjudizierte Ergebnisse, Annahmen zu Ausschuss und Defektdurchlass sowie beobachtete Nachprüfzeiten. Ich unterstütze Sie dabei, daraus einen Kalibrierungsbericht, eine getestete Entscheidungspolitik und eine Freigabecheckliste zu entwickeln. Das erste sinnvolle Ergebnis kann sein, dass Labels oder Prüfkapazität noch nicht ausreichen. Diese Grenze vor einer automatischen Ausschleusung zu erkennen, ist ein belastbares Engineering-Ergebnis.