BLUF — budgetieren Sie CPU-Inferenz über Anfrageparallelität, Sitzungspools von ONNX Runtime und native Vorverarbeitungsbibliotheken hinweg. Wenn Sie jede Ebene unabhängig vergrößern, kann ein kleines Modell trotz höherer CPU-Auslastung langsamer werden. Beginnen Sie mit einer expliziten Ein-Thread-Basis und verändern Sie jeweils eine Ebene. Bewerten Sie Latenz ab geplanter Ankunft, abgeschlossene Arbeit und CPU-Kosten. Eine konfigurierte Thread-Zahl ist keine Messung gleichzeitig laufender Arbeit.
Für diesen Artikel wurde ein begrenzter synthetischer ONNX-Graph tatsächlich auf einem Linux-Gastsystem mit vier vCPUs ausgeführt. Die bewusst aggressive Konfiguration erzeugte bei derselben angebotenen Last Sekunden an Wartezeit, während konservative Konfigurationen im Millisekundenbereich blieben. Das ist ein Diagnosebeispiel, kein Leistungsversprechen: Der Workload ist künstlich, der Host wird geteilt, und die kurzen Stichproben begründen kein belastbares Produktions-p99.
Drei Ebenen teilen sich dasselbe CPU-Budget
Die Threading-Dokumentation von ONNX Runtime unterscheidet Intra-Op-Parallelität innerhalb eines Operators von Inter-Op-Parallelität zwischen Graphoperatoren. ORT_SEQUENTIAL führt die Graphoperatoren nacheinander aus; innerhalb eines Operators können trotzdem mehrere Threads arbeiten. intra_op_num_threads = 1 ist eine zusätzliche Entscheidung. Inter-Op-Pools werden bei ORT_PARALLEL relevant. Das kann verzweigten Graphen helfen, anderen Workloads jedoch schaden.
Darüber liegt die Parallelität der Anwendung: HTTP-Worker, Hintergrundverarbeitung oder Anfrage-Threads im selben Prozess. Daneben liegen Vorverarbeitungsbibliotheken. NumPy-Matrixoperationen können einen nativen BLAS-Pool verwenden; anderer Code nutzt OpenMP. Der Parallelitätsleitfaden von scikit-learn erklärt, warum n_jobs nicht alle darunterliegenden Pools steuert. Ebenso wenig kontrolliert ein Server-Worker-Parameter automatisch ONNX Runtime.
Die Eigentumsstruktur ist ebenso wichtig wie die Zahlen. Getrennte Betriebssystemprozesse besitzen üblicherweise getrennte Laufzeitinstanzen. Mehrere ORT-Sitzungen in einem Prozess können jeweils einen eigenen Intra-Op-Pool besitzen. Die hier untersuchte OpenBLAS-pthreads-Bibliothek dagegen stellt einen prozessweiten Pool bereit, den Python-Aufrufer teilen. Worker × ORT-Threads × BLAS-Threads wäre deshalb keine korrekte Messung gleichzeitig beanspruchter CPU-Kapazität. Außerdem können diese Ebenen nacheinander statt gleichzeitig arbeiten.
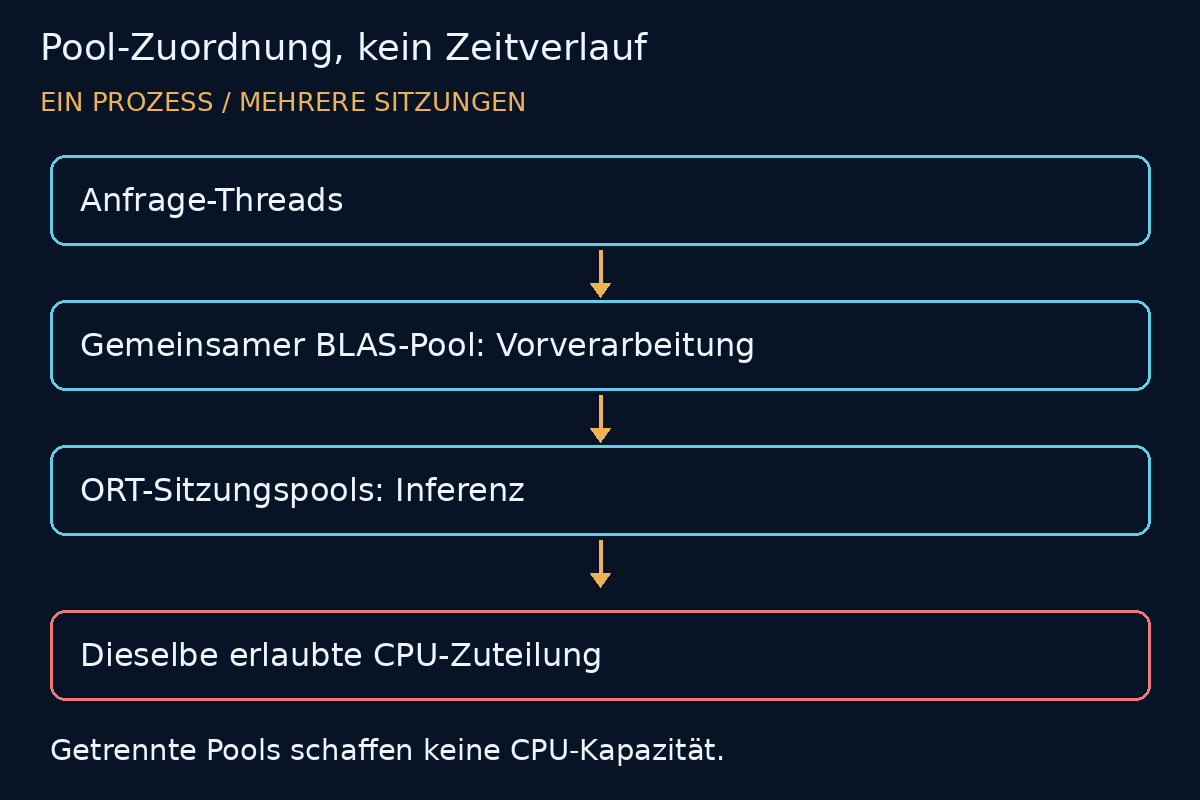
Das Diagramm zeigt die Ressourcenzuordnung, keinen gemessenen Zeitverlauf. Eine Anfrage durchläuft zuerst Vorverarbeitung und danach Modellausführung. Native Pools verschiedener Anfragen oder Sitzungen können dennoch um dieselben erlaubten CPUs konkurrieren. Aktives Warten kann zwischen Nutzaufgaben zusätzliche Zyklen verbrauchen. Getrennte Pools schaffen keine getrennte Prozessorkapazität.
Prüfen Sie die Zuteilung vor der Thread-Zahl
Erfassen Sie Prozessaffinität, effektives cpuset, cgroup-Pfad und alle wirksamen CPU-Quoten übergeordneter Gruppen. Eine Affinitätsmaske mit vier CPUs und eine Quote im Umfang einer CPU sind unterschiedliche Grenzen: Affinität begrenzt die Platzierung, die Quote die verfügbare Rechenzeit pro Periode. Die logische Prozessorzahl des Hosts ist nicht automatisch das Containerbudget. Dokumentieren Sie auch Topologie, NUMA, Virtualisierung und konkurrierende Workloads.
Die Ausführung verwendete Python 3.12.13, ONNX Runtime 1.31.0, ONNX 1.23.2 und NumPy 2.5.4. Der KVM-Gast meldete einen AMD EPYC-Milan, vier logische CPUs, zwei Kerne mit je zwei Threads und einen NUMA-Knoten. Prozessaffinität und effektives Root-cpuset waren 0–3. Lesbare cpu.max-Dateien übergeordneter Gruppen enthielten max 100000; die Blattgruppe stellte keine cpu.max-Datei bereit. In der sichtbaren Hierarchie wurde keine endliche übergeordnete Quote gefunden. Das beweist weder dedizierte Hostkerne noch die Abwesenheit von Hypervisor-Konkurrenz.
Prüfen Sie nach dem Import der numerischen Abhängigkeiten threadpool_info() oder führen Sie python -m threadpoolctl -i numpy aus. Hier wurde OpenBLAS 0.3.34.106.0 mit der pthreads-Threading-Ebene erkannt. Das Projekt threadpoolctl dokumentiert unterstützte BLAS-/OpenMP-Pools, Geltungsbereiche und Grenzen bei gemischten Laufzeiten. Es steuert nicht universell ORT, Prozesszahlen oder Betriebssystemaffinität. Prüfen Sie die installierte Version, statt die neueste Repository-API vorauszusetzen.
Ein ausgeführtes, bewusst begrenztes Experiment
Die Testvorrichtung verwendet Seed 62, float32-Eingaben der Form 32 × 512, eine feste Vorverarbeitungsmatrix mit 512 × 512 Elementen und acht MatMul-/Relu-Stufen mit einer gemeinsamen festen Gewichtsmatrix. Die Gewichte sind zufällige Lehrdaten, kein trainiertes Modell. Vor der Ausführung mit CPUExecutionProvider wurde die ONNX-Struktur geprüft. Jede Sitzung erhielt zwanzig Aufwärmaufrufe. Graph, Eingabe, Graphausführungsmodus, Ankunftsplan und Aufwärmregel blieben in allen Konfigurationen gleich.
Pro Konfiguration wurden 240 Anfragen mit 80 geplanten Ankünften pro Sekunde angesetzt, unabhängig vom Abschluss vorheriger Anfragen. Die Latenz beginnt bei der geplanten Ankunft und endet nach Vorverarbeitung, Inferenz und einer Prüfung auf endliche Ausgaben. Generatorverzögerung und Warten im Executor bleiben damit sichtbar. Gemessen wird nicht nur Kernelzeit. Der Durchsatz unten teilt Abschlüsse durch die Zeit von der ersten geplanten Ankunft bis zum letzten Abschluss. Werte knapp über 80 sind möglich, weil die letzte Ankunft des endlichen Plans vor dem Ende eines vollständigen Drei-Sekunden-Intervalls liegt.
Worker bezeichnet hier das Limit von Anfrage-Threads eines Python ThreadPoolExecutor, keine Betriebssystemprozesse. Der Executor erzeugt Threads bedarfsabhängig; bei geringer Last wird deshalb nicht zwingend jeder konfigurierte Aufrufer aktiv. Gemeinsam bedeutet eine ORT-Sitzung für die Aufrufer; pro Worker bedeutet eine vorbereitete Sitzung je möglichem Aufrufer. Die BLAS-Vorverarbeitung läuft vor ORT, nicht als instrumentierter BLAS-Aufruf innerhalb von ORT. Das Experiment macht Poolkonkurrenz sichtbar, ohne einen Trace verschachtelter Operatorausführung zu behaupten.
Gemessene Worker- und Pool-Matrix
Die Konfiguration bedeutet Anfrage-Worker-Limit / ORT-Intra-Op-Threads / BLAS-Limit. G steht für eine gemeinsame Sitzung, P für Sitzungen pro Worker. Spinning bezeichnet aktives Warten im ORT-Intra-Op-Pool. Alle Konfigurationen verwendeten ORT_SEQUENTIAL. Die Werte sind gerundete Ergebnisse je einer Ausführung, keine Schätzungen aus wiederholten Versuchen.
| Konfiguration | Spinning | p50 ms | p95 ms | p99 ms | Abschlüsse/s | CPU % |
|---|---|---|---|---|---|---|
| 1/1/1 G | aus | 2,49 | 3,74 | 3,91 | 80,27 | 21,7 |
| 2/1/1 G | aus | 2,66 | 3,51 | 3,98 | 80,24 | 22,7 |
| 2/1/1 P | aus | 2,58 | 3,72 | 4,01 | 80,27 | 22,4 |
| 2/2/1 P | aus | 2,59 | 3,14 | 3,41 | 80,25 | 35,4 |
| 4/4/4 P | an | 2371,52 | 4710,17 | 4890,52 | 30,25 | 399,5 |
| 4/4/1 P | aus | 2,63 | 3,13 | 3,39 | 80,27 | 51,5 |
| 4/4/1 P | an | 2,42 | 15,96 | 19,65 | 79,47 | 344,7 |
| 4/1/4 P | aus | 2,87 | 4,69 | 19,91 | 80,23 | 325,3 |
| 4/1/1 P | aus | 2,45 | 3,60 | 3,89 | 80,24 | 21,1 |
Alle neun Konfigurationen schlossen sämtliche 240 geplanten Anfragen ohne protokollierte Ausführungsfehler oder nicht endliche Ergebnisse ab. Es gab weder eine Zulassungsgrenze noch einen Timeout; die bewusst kleine Kohorte wurde vollständig abgearbeitet. Ein Produktionsdienst benötigt begrenzte Warteschlangen und explizite Fristergebnisse statt dieser endlichen Lehrlast. Prozess-CPU ist die Summe aus User- und System-CPU-Zeit geteilt durch Wandzeit. 100 % entspricht der Zeitkapazität einer logischen CPU, nicht des gesamten Gastsystems.
Der stichprobenartig erfasste Prozess-RSS lag zwischen 100,36 und 118,86 MiB. Die Konfigurationen liefen nacheinander im selben Interpreter. Zurückgehaltener Allokatorspeicher und bereits geladene Bibliotheken verhindern deshalb eine isolierte Zuordnung dieser Werte zu einzelnen Sitzungen. Die protokollierten Root-cgroup-Throttling-Differenzen waren null. Diese Zähler umfassen mehr als den Testprozess und schließen Hostkonkurrenz nicht aus. Erfasst wurden außerdem Kontextwechsel des Hauptthreads, nicht sämtliche Wechsel nativer Worker. Für Produktionsdiagnosen benötigen Sie korrekt abgegrenzte Prozess-, Thread- und Containertelemetrie.
Leiten Sie keinen unbelegten Sieger ab
Die 4/4/4-Konfiguration mit Spinning verändert mehrere Größen gleichzeitig und isoliert keine einzelne Ursache. Zusätzliche Konfigurationen präzisieren die nächste Untersuchung: Bei 4/4/1 ging aktiviertes Spinning in diesem Lauf mit höherem CPU-Verbrauch und schlechterer Tail-Latenz einher. Bei 4/1 ging ein BLAS-Limit von vier statt eins ebenfalls mit höheren CPU-Kosten einher. Das sind nützliche Einzelvergleiche, keine statistische Schätzung. Wiederholen Sie die Versuche in randomisierter Reihenfolge und isolieren Sie den Generator, bevor Sie Kausalität oder Kapazität behaupten.
4/4/1 ohne Spinning reproduzierte die extreme Warteschlange nicht. Das ist relevant: Konfigurierte Poolzahlen allein beweisen keinen Überbelegungsvorfall. Ebenso liegen die Ergebnisse mit zwei Aufrufern und gemeinsamer beziehungsweise getrennter Sitzung zu nah beieinander; die Messungen sind zu kurz und zu schwach ausgelastet für eine Produktionsentscheidung. Die Konfigurationen mit wenigen Threads bewältigten diese moderate angebotene Last. Ihr maximaler Durchsatz wurde nicht bestimmt.
Definieren Sie akzeptable Ergebnisse anhand des Inferenz-SLO-Modells, bevor Sie optimieren. Kaufen Sie nicht allein wegen einer hohen CPU-Anzeige zusätzliche Kapazität. Akzeptieren Sie umgekehrt keine kleine p95-Verbesserung, wenn der Kandidat mehr CPU benötigt, Fristen verletzt oder Qualitätsprüfungen nicht besteht.
Stellgrößen und ihre Grenzen
Setzen Sie SessionOptions.intra_op_num_threads explizit und wählen Sie execution_mode bewusst. Beginnen Sie mit ORT_SEQUENTIAL, solange Sie Intra-Op-Verhalten isolieren. Prüfen Sie ORT_PARALLEL und inter_op_num_threads getrennt, wenn Graph und Workload dies rechtfertigen. Laut Dokumentation erhalten explizit konfigurierte Intra-Op-Zahlen nicht dieselbe automatische Threadaffinität wie die Standardkonfiguration. Halten Sie diesen Unterschied im Versuchsmanifest fest.
Testen Sie session.intra_op.allow_spinning = "0" als Kandidaten, nicht als universelle Empfehlung. Aktives Warten kann Aufwecklatenz reduzieren, verbraucht aber CPU-Zyklen und Energie. Neuere zeitbegrenzte Spinning-Optionen erfordern eine Versionsprüfung und eigene Messungen. Wenn Sie Thread-Zahl, Affinität, Spinning und Graphoptimierung gleichzeitig ändern, können Sie das Ergebnis nicht allein der Thread-Zahl zuschreiben.
Konfigurieren Sie unterstützte BLAS-/OpenMP-Limits vor Beginn der Worker-Arbeit. Hier umschloss threadpool_limits(limits=..., user_api="blas") die gesamte Konfiguration. Es wurden nicht konkurrierend unterschiedliche prozessweite Limits pro Anfrage gesetzt. Manche Bibliotheken verwenden threadlokale Einstellungen, andere teilen einen prozessweiten Pool. Nach der Controller-Erzeugung geladene Bibliotheken können seiner Kontrolle entgehen. Prüfen Sie den tatsächlichen Geltungsbereich und behandeln Sie ORT separat.
Globale ORT-Pools sind eine weitere dokumentierte Architekturvariante über Laufzeit-APIs. Daraus folgt nicht, dass jedes Python-Binding einen bestimmten globalen Poolkonstruktor anbietet. Prüfen Sie Binding, Eigentümerschaft und Lebenszyklus. Affinität oder NUMA-Aufteilung können Konkurrenz reduzieren, aber auch Kapazität ungenutzt lassen. Dieses Experiment enthält keine Messung zur Affinitätsoptimierung.
Entscheidungstabelle: Was prüfen Sie als Nächstes?
| Beobachtung | Nächster kontrollierter Test | Risiko oder Ablehnungsgrund |
|---|---|---|
| Tail-Latenz und CPU steigen mit mehr Sitzungen | Sitzungsduplikation bei gleicher Last reduzieren | Semantik und Parallelität geteilter Sitzungen prüfen |
| Wartende Threads verbrauchen CPU ohne zusätzliche Abschlüsse | Nur Spinning ändern; Limits beibehalten | Aufwecklatenz kann steigen |
| Vorverarbeitung dominiert die CPU-Zeit | Unterstützte BLAS-/OpenMP-Pools prüfen und begrenzen | Falscher Geltungsbereich macht Limits unwirksam |
| Container-Throttling nimmt zu | Übergeordnete Quote und Zulassungsbudget prüfen | Mehr Threads schaffen keine zusätzliche Quote |
| Latenz sinkt, Ausgaben verändern sich | Numerische und fachliche Qualitätsprüfungen wiederholen | Ein schnelleres falsches Ergebnis wird nicht akzeptiert |
Das Gate für numerische ONNX-Gleichwertigkeit bleibt unabhängig von Performance. Hier wurden endliche Ausgaben geprüft, nicht Gleichwertigkeit über alle Konfigurationen oder fachliche Genauigkeit. Vor einem Rollout müssen Sie freigegebene Tensoren und nachgelagerte Entscheidungen vergleichen. Threadplanung und unterschiedliche Kernel können das Gleitkommaverhalten beeinflussen.
Eine reproduzierbare Freigabecheckliste
Zuteilung prüfen: Affinität, cpuset, Quotenhierarchie, Topologie, Laufzeitversionen und Bibliotheks-Backends festhalten. Zuständigkeit prüfen: Anfrage-Worker, Sitzungszahl, gemeinsame und private Pools sowie deren Arbeitsphasen auflisten. Workload prüfen: Graph- und Eingabe-Hashes, Ankunftsplan, Aufwärmung, Batchform und Vorverarbeitung einfrieren. Messung prüfen: Jedes geplante Ergebnis, Latenz einschließlich Warteschlange, Servicezeit, CPU-Sekunden, korrekt abgegrenztes Throttling und Speicherbeobachtungen erhalten.
Abnahme prüfen: Konfigurationen randomisiert unter repräsentativer Normal-, Spitzen- und Burstlast wiederholen. Verwenden Sie begrenzte Warteschlangen und explizite Timeout-/Abbruchergebnisse. Verwerfen Sie generatorlimitierte Läufe als Kapazitätsnachweis. Vergleichen Sie Streuung, Ausgabequalität und Kosten statt nur des besten Perzentils. Der synthetische Lauf liefert ein reproduzierbares Diagnosemuster; sein p99 ist lediglich ein empirisches Perzentil aus 240 Beobachtungen.
Hinterlegen Sie freigegebene Einstellungen und Rückfallkonfiguration im reproduzierbaren Release-Bundle. Bringen Sie für eine technische CPU-Inferenzprüfung ein Modellartefakt, die wirksame Ressourcenzuteilung, einen bereinigten Ankunftsverlauf und das tatsächliche Inventar nativer Pools mit. Das Ergebnis ist eine gemessene Entscheidung zum Beibehalten, Neuverteilen oder Isolieren — keine Regel, nach der jeder Worker sämtliche Kerne beanspruchen sollte.