BLUF: Eine gültige ONNX-Datei belegt nicht, dass ein Edge-Modell weiterhin dieselbe Entscheidung trifft. Behandeln Sie Konvertierung, Quantisierung und Ausführung auf dem Ziel-Provider als getrennte Änderungen. Vergleichen Sie eingefrorene Ein- und Ausgabetensoren, weisen Sie nichtendliche Werte und abweichende Formen zurück und prüfen Sie Wechsel zwischen Annahme, Prüfung und Ausschuss unabhängig von numerischen Toleranzen. Eine winzige Score-Abweichung kann den Tensorvergleich bestehen und trotzdem die Teileentscheidung verändern.
Dies ist ein Implementierungsmuster für einen begrenzten industriellen Empfehlungsscore, kein Bericht über einen Werkseinsatz. Das ausführbare Beispiel prüft ausschließlich das Vergleichsgate mit synthetischen Ausgaben. Es exportiert und betreibt kein ONNX-Modell, misst keine Feldgenauigkeit und validiert keine GPU oder NPU. Der produktive Ablauf verlangt diese zusätzlichen Prüfungen ausdrücklich mit Ihren tatsächlichen Freigabeartefakten und Zielgeräten.
Ein Export enthält mehrere Freigabefragen
Die Dokumentation des ONNX-Checkers beschreibt Konsistenzprüfungen am Modell; full_check ergänzt die Forminferenz. Keiner dieser Schritte bewertet Ihre zurückgehaltenen Produktionsfälle. Ein formal zulässiger Graph kann trotzdem vertauschte Kanäle verarbeiten, eine veränderte Ausgabeform liefern oder einen Score über eine Entscheidungsschwelle verschieben.
Trennen Sie drei Vergleiche. Vergleichen Sie zunächst das eingefrorene Modell im Quellframework mit seinem ONNX-Gleitkommaexport bei identischen vorbereiteten Eingaben. Vergleichen Sie danach den freigegebenen ONNX-Gleitkommagraphen mit einer quantisierten Variante unter dokumentierter Kalibrierungs- und Optimierungskonfiguration. Führen Sie schließlich das exakt freigegebene Artefakt auf dem vorgesehenen Execution Provider des Zielgeräts aus und vergleichen Sie es mit der genehmigten Referenz. Werden alle Änderungen vermischt, lässt sich ein Fehler schwer zuordnen.
Die ONNX-Runtime-Dokumentation zu Execution Providern erläutert, dass Provider unterstützte Knoten oder Teilgraphen über GetCapability übernehmen. Eine priorisierte CUDA/CPU-Liste kann Arbeit ohne CUDA-Unterstützung auf der CPU ausführen. Ein registrierter Provider beweist daher nicht, dass sämtliche Knoten dort liefen. Erfassen Sie die tatsächliche Zuordnung, soweit Profiling oder Laufzeitprotokolle sie offenlegen, und dokumentieren Sie verbleibende Sichtbarkeitslücken. Nicht freigegebener Fallback sperrt die Freigabe.
Frieren Sie den Tensorvertrag vor dem Score-Vergleich ein
Definieren Sie für einen Empfehlungsklassifikator mit einer Ausgabe beispielsweise float32-Batches mit fester Merkmalsreihenfolge und ausdrücklich zulässigen Batchgrößen. Schwingungs-RMS in mm/s und Lagertemperatur in Grad Celsius sind unterschiedliche Kanäle; eine Einheitenumrechnung oder vertauschte Reihenfolge ist eine Vertragsänderung, kein numerisches Rauschen. Frieren Sie Skalierungskoeffizienten, Clipping, Vorverarbeitung, Fehlwertregeln und Erfassungsfenster ein. Weisen Sie ungültige Eingaben vor der Inferenz zurück, sofern keine separat genehmigte Imputationsregel greift.
Bewahren Sie sowohl rohe Testdatensätze als auch vorbereitete Referenztensoren auf. Die Wiedergabe der Rohdaten prüft die Vorverarbeitung; die Tensorwiedergabe isoliert das ausführbare Modell. Bilden Sie Prüfsummen der Manifeste und halten Sie stabile Beispiel-IDs, erwarteten Datentyp, Dimensionen, Ausgabebedeutung und Referenzlaufzeit fest. Reduzieren Sie Tensoren nicht stillschweigend auf flache Listen, bevor die Achsen geprüft sind: Gleiche Elementzahlen können eine transponierte Ausgabe verbergen. Der kleine Vergleicher unten akzeptiert bewusst nur flache Listen mit einem Score je Beispiel; Adapter müssen komplexere Tensorstrukturen vorher prüfen.
Der bestehende Leitfaden zu industriellen Datenverträgen behandelt die vorgelagerte Semantik. Hier ist die Freigabegrenze enger: Erhält das neue ausführbare Artefakt bei exakt gleicher Eingabe den Ausgabevertrag und die genehmigte nachgelagerte Entscheidung?
Eine gestufte Vergleichspipeline
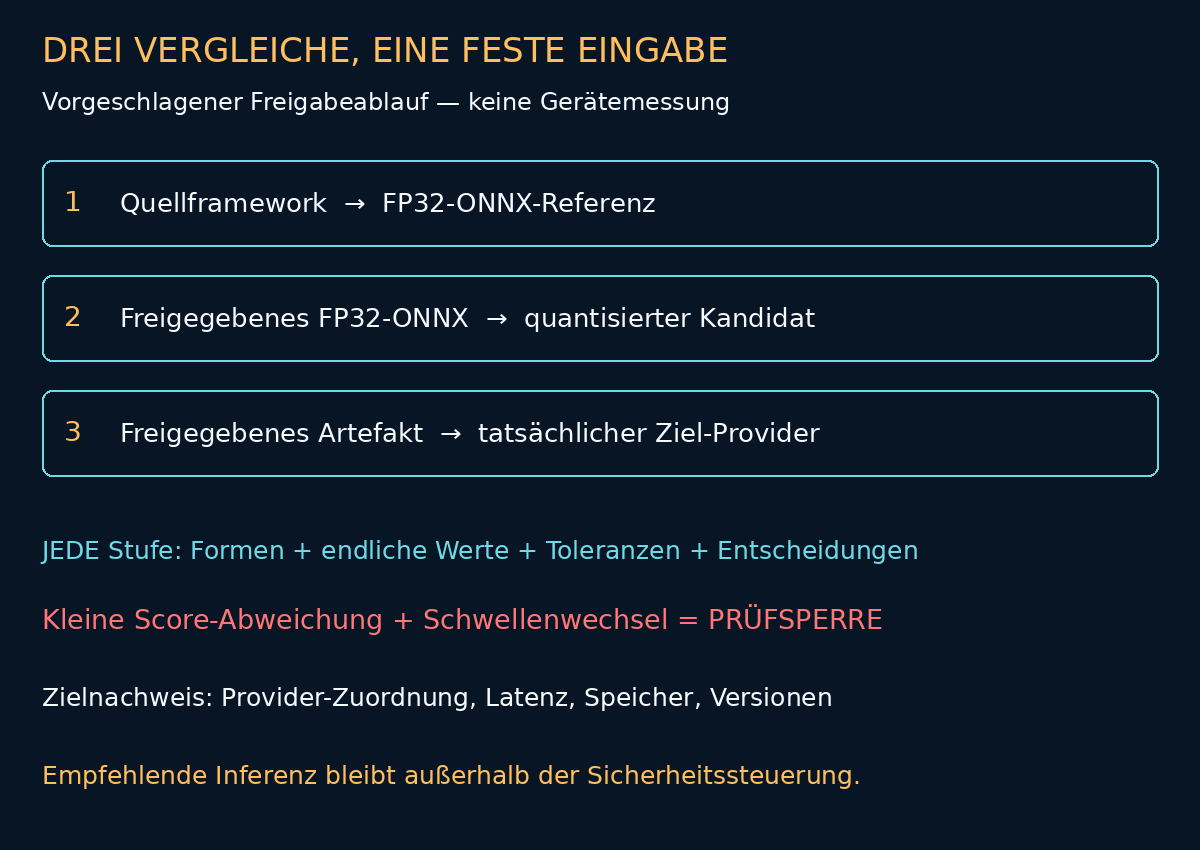
Bewahren Sie an jeder Stufe Eingabeprüfsumme, beide Ausgabetensoren, Vergleichsregeln und IDs fehlerhafter Beispiele auf. Ersetzen Sie die Referenz nicht durch den jüngsten Kandidaten, nur weil er sich laden lässt. Optimierungseinstellungen gehören zum Kandidaten: Operatorfusion und unterschiedliche Kernel können die Gleitkommaakkumulation verändern. Testen Sie die vorgesehene produktive Optimierungskonfiguration, nicht nur einen Debug-Modus ohne Optimierungen.
Grenzfalltests sollten Werte beiderseits jeder Entscheidungsschwelle, exakte Gleichstände, gültige Nulleingaben, konstante Kanäle, die maximal zulässige Batchgröße, Batchgröße eins und jede genehmigte dynamische Formfamilie enthalten. Degeneriert bedeutet nicht automatisch gültig: Leere Batches, NaN, Unendlich und nicht unterstützte Formen sollen den Ablehnungspfad prüfen. Ungültige Daten dürfen nicht als numerischer Erfolg zählen, weil eine Vergleichsbibliothek NaNs toleriert.
Entscheidungstabelle: Konvertierung ist nicht Quantisierung
| Änderung oder Befund | Erforderlicher Vergleich | Freigabeentscheidung |
|---|---|---|
| Quellmodell zu FP32-ONNX | Gleiche Referenzeingaben, Ausgabeschema, ausgabespezifische Toleranzen und Entscheidungen | Bei unerklärter Abweichung oder Entscheidungswechsel sperren |
| FP32 zu quantisiertem ONNX | Separater Gleitkomma-/Quantisierungsvergleich plus zurückgehaltene Aufgabenmetriken | Bis zum Bestehen des Qualitätsbudgets und der Entscheidungsregeln sperren |
| Freigegebenes Artefakt auf Ziel-Provider | Exakte Ziellaufzeit, Optimierung, Knotenzuordnung und Latenznachweis | Bei nicht unterstützten Operatoren oder ungenehmigtem Fallback sperren |
| Tensortoleranz erfüllt, Entscheidung verändert | Betroffene Beispiel-IDs und beide Entscheidungen ausweisen | Explizite Prüfung verlangen; Wechsel nicht im Mittelwert verstecken |
| Strukturprüfung erfolgreich | Nur Graphkonsistenz; kein Nachweis der Aufgabenbearbeitung | Weitere Tests, keine Produktionsfreigabe |
Nutzen Sie für die quantisierte Variante eigene Toleranzregeln. Erweitern Sie nicht die Konvertierungstoleranz, um Quantisierungsverlust zu verdecken. Ein neues Quantisierungsverfahren darf Scores verändern; die Annahme dieser Änderungen benötigt jedoch aufgabenbezogene Evidenz und genehmigte Entscheidungsregeln. Dieser Artikel wählt konservativ keine ungeprüften Entscheidungswechsel als Freigabebedingung, nicht die allgemeine mathematische Forderung nach identischen quantisierten Ausgaben.
Ein ausführbares Vergleichsgate mit absichtlicher Falle
Verwenden Sie elementweise abs(Kandidat − Referenz) ≤ atol + rtol × abs(Referenz). Die Referenz bestimmt die Skala. Nahe null ist der absolute Term entscheidend; ein rein relativer Fehler kann bedeutungslos werden. Legen Sie Einheiten und Toleranzen für jede Ausgabe getrennt fest. Die Beispielwerte atol = 0,000001 und rtol = 0,00001 dienen der Erklärung und sind keine empfohlenen Werksgrenzen.
Für den Beispielscore gilt: unter 0,2 annehmen, von 0,2 bis einschließlich 0,8 prüfen und über 0,8 aussortieren. Diese Schwellen sind keine kalibrierten Defektwahrscheinlichkeiten. Sie demonstrieren einen Freigabefehler. Der Artikel zur Kalibrierung visueller Qualitätsprüfung behandelt die Begründung realer Schwellen. Gleichwertigkeitstests sollen die bereits genehmigte Regel erhalten, nicht anhand der Konvertierungsfehler neu optimieren.
Das folgende Python-Beispiel verwendet nur die Standardbibliothek und ist in dieser Reihenfolge ausführbar. Es prüft gleiche, nichtleere Längen, endliche Werte, numerische Toleranz und Folgeentscheidungen. Es verarbeitet ausschließlich den bewusst begrenzten Vertrag flacher Ausgaben. Speichern Sie die Codezeilen gemeinsam und führen Sie sie mit python3 aus. Die englischen Bezeichner sind technische Ausgabewerte: accept bedeutet Annahme, review Prüfung und reject Ausschuss.
import math
atol, rtol = 1e-6, 1e-5
action = lambda x: 'accept' if x < .2 else 'reject' if x > .8 else 'review'
ref, got = [.1999999, .8000001], [.2000001, .7999999]
valid = bool(ref) and len(ref) == len(got)
valid = valid and all(math.isfinite(x) for x in ref + got)
close = valid and all(abs(a-b) <= atol + rtol*abs(a) for a,b in zip(ref,got))
flips = sum(action(a) != action(b) for a,b in zip(ref,got)) if valid else None
release = close and flips == 0
assert close and flips == 2 and not release
print({'numeric_pass': close, 'decision_flips': flips, 'release': release})
Ausgeführtes Ergebnis: numeric_pass = True, decision_flips = 2, release = False. Jede Abweichung beträgt ungefähr 0,0000002, trotzdem wechseln beide Beispiele die Entscheidung. Eines wechselt von Annahme zu Prüfung, das andere von Ausschuss zu Prüfung. Nur den mittleren absoluten Fehler zu melden, würde den Sperrgrund verbergen.
Der begleitende redaktionelle Selbsttest führte elf synthetische Fälle aus: normale Werte, Werte nahe null, Schwellenübertritte, größere Abweichung, Längenfehler, leere Eingabe, NaN, Unendlich, ein Element, drei Elemente und exakte Schwellenwerte. Alle elf ergaben die erwartete Annahme oder Sperre. Dies validiert lediglich das Verhalten des Vergleichers für diese Fälle. Die unterschiedlichen Listenlängen belegen keine dynamische Formunterstützung eines ONNX-Graphen. Für diese Ergebnisse wurden weder ONNX Runtime noch ein Framework-Export oder quantisiertes Modell ausgeführt.
Vom Selbsttest zum Artefaktnachweis
Erfassen Sie die Referenzausgaben des eingefrorenen Quellmodells im Evaluierungs-/Inferenzmodus mit den vorbereiteten Tensoren. Dokumentieren Sie Zufallsstarts und verbleibende nichtdeterministische Operationen; ein gesetzter Seed beweist allein keine deterministische Ausführung. Exportieren Sie mit expliziten Ein-/Ausgabenamen, unterstütztem Opset und Formbeschränkungen. Führen Sie die Strukturprüfung aus und erfassen Sie anschließend Ausgaben des exportierten Graphen auf dem Referenz-Provider. Ordnen Sie Ergebnisse über unveränderliche Beispiel-IDs zu, prüfen Sie Formen und Datentypen und wenden Sie das Vergleichsgate je benannter Ausgabe an.
Wiederholen Sie dies für das quantisierte Artefakt und anschließend auf dem Zielgerät. Verwenden Sie dieselben zurückgehaltenen Abnahmeeingaben. Optimieren Sie die Quantisierung nicht anhand der finalen Abnahmefehler und bezeichnen Sie denselben Satz danach als unabhängig. Statische Quantisierung bestimmt Aktivierungsbereiche anhand von Kalibrierungsdaten. Halten Sie deren Herkunft von Abnahmedaten getrennt und decken Sie repräsentative Betriebszustände ab. Quantisierung ist verlustbehaftet; die offizielle Quantisierungsdokumentation warnt ausdrücklich vor Genauigkeitsverlust und hardwareabhängiger Leistung. Ein kleineres Artefakt kann wegen Umwandlungsaufwand oder fehlender Kernelunterstützung langsamer laufen.
Lokalisieren Sie bei Divergenz zuerst die fehlerhafte Stufe. Für unterstützte Paare aus Gleitkomma- und quantisiertem Graphen bietet ONNX Runtime über qdq_loss_debug Zuordnungen von Gewichten und Aktivierungen, darunter create_weight_matching und create_activation_matching. Dies sind Debugging-Hilfen, keine Zusicherung, beliebige Tensoren aus Quellframework und Export einander zuordnen zu können. Graphtransformationen können die Zuordnung erschweren. Bewahren Sie einen vorverarbeiteten Gleitkommagraphen auf und trennen Sie Optimierung und Quantisierung, soweit praktikabel, damit Unterschiede interpretierbar bleiben.
Erklären Sie das Zielgerät nicht aufgrund eines CPU-Laufs für validiert. Erfassen Sie Provider-Build, Treiber/Firmware, Geräteidentität, Provider-Optionen und verfügbare Knotenzuordnung. Messen Sie Kaltstart und warmen Betrieb, Latenzverteilung, Speicherbedarf und Transferaufwand unter den relevanten Eingabeformen. Numerische Übereinstimmung belegt keine Fristgarantie; CPU-Fallback kann die Ausgaben erhalten und trotzdem betriebliche Zeitgrenzen verletzen.
Edge-Freigabemanifest und Abnahmecheckliste
Identität: Quellrevision, Prüfsummen von Modell und externen Gewichten, Prüfsummen exportierter und quantisierter Artefakte, Opset, ONNX-IR-Version, Konverterversion und vollständige festgeschriebene Laufzeitabhängigkeiten.
Vertrag: Ein-/Ausgabenamen, Datentypen, Achsenbedeutung, genehmigte Formen, Einheiten, Prüfsumme der Vorverarbeitung, Fehlwertbehandlung, Manifest der Referenzeingaben und Prüfsumme der Referenzausgaben.
Ausführung: Hardwareidentität, Provider-/Laufzeitversionen, Prioritäten und Optionen, Optimierungsgrad, Treiber/Firmware, beobachtete Knotenzuordnung und ausdrücklich nicht beobachtbare Details.
Abnahme: absolute und relative Toleranzen je Ausgabe, Schwellen- und Gleichstandsregeln, Bericht zu Entscheidungswechseln, Ergebnisse ungültiger Eingaben, zurückgehaltene Aufgabenmetriken, Latenz-/Speichermessungen, Ausschlüsse und Prüfentscheidung.
Betrieb: genehmigter Geltungsbereich, Verantwortliche, Rückfallartefakt und Kompatibilitätsnachweis. Binden Sie diese Evidenz in den Modellsteckbrief mit Rollback-Bündel ein, statt eine nicht rückverfolgbare Tabelle neben einem veränderlichen Modell-Tag abzulegen.
Geben Sie erst frei, wenn jeder erforderliche Vergleich ein explizites Ergebnis und jede Abweichung eine verantwortete Entscheidung hat. Halten Sie empfehlende Inferenz außerhalb des unabhängigen Sicherheitssteuerungspfads. Numerische Gleichwertigkeit belegt weder Sicherheitsintegrität noch Konformität, Feldgenauigkeit oder ein akzeptables Risiko unentdeckter Defekte. Auch ein verzerrtes Quellmodell lässt sich perfekt reproduzieren.
Beginnen Sie mit einer Konvertierungsgrenze
Wählen Sie ein Modell, einen eingefrorenen Vorverarbeitungsvertrag und ein Zielgerät. Erstellen Sie den Referenzeingabesatz, injizieren Sie einen Schwellenübertritt und führen Sie anschließend die realen Quell-/Export-/Zielvergleiche aus, bevor Sie die Hardwareflotte erweitern. Für eine technische Prüfung bringen Sie Artefakte, Provider-Konfiguration und vorhandene Abnahmeregeln mit. Ich unterstütze Sie dabei, ein Konvertierungsgate und Freigabemanifest aufzubauen, das Entwicklung und Betrieb reproduzieren können. Ein präziser Sperrgrund ist ein sinnvolleres erstes Ergebnis als eine grüne Anzeige durch pauschal größere Toleranzen.