Ein Embedding-Modellwechsel verändert ein gekoppeltes Retrieval-System, nicht nur gespeicherte Vektoren. Bauen Sie einen separaten Zielindex auf, erzeugen Sie Embeddings aus maßgeblichem Quelltext neu, spielen Sie Änderungen und Löschungen nach und schalten Sie Query-Encoder und Index als eine unveränderlich versionierte Route um. Halten Sie die alte Route ausreichend aktuell für ein Rollback. Ein Alias-Wechsel allein koordiniert weder Modelldienste noch Ingestion-Worker, Caches und Berechtigungen.
Der gefährliche Fehler ist nicht immer eine falsche Dimension. Zwei Modelle können gleich lange Vektoren erzeugen und Texte trotzdem unterschiedlich repräsentieren. Eine mit dem neuen Modell codierte Anfrage gegen alte Dokumentvektoren kann die Formprüfung bestehen und dennoch falsche Belege liefern. Dieser Beitrag beschreibt einen Architektur- und Abnahmevorschlag, keinen durchgeführten Kundenwechsel und kein Versprechen unterbrechungsfreien Betriebs.
Definieren Sie die Kompatibilitätseinheit
Erstellen Sie ein Routenmanifest mit route_id, query_encoder_revision, document_encoder_revision, tokenizer_revision, query_prefix, document_prefix, pooling, normalization, vector_dimensions, similarity_metric, chunker_revision, physical_index und authorization_policy_revision. Query- und Dokument-Encoder müssen das dokumentierte kompatible Paar bilden; nicht jedes Retrieval-System verlangt dafür identische Architekturen. Referenzieren Sie unveränderliche Modellrevisionen statt veränderlicher Namen.
Binden Sie eine Anfrage einmalig vor der Embedding-Erzeugung an dieses Manifest. Übergeben Sie dieselbe Routen-ID an Encoder, Retriever und Telemetrie. Prüfen Sie vor der Suche sowohl die Vertrags-ID des erzeugten Embeddings als auch seine Dimension. Lesen Sie nach der Vektorerzeugung keinen veränderlichen globalen Index-Alias erneut: Eine laufende Anfrage könnte sonst ein anderes Ziel erhalten als bei ihrer Codierung vorgesehen. Während eines schrittweisen Deployments dürfen alte und neue Anfragen parallel bestehen, solange jede in ihrer vollständigen Route bleibt.
Damit wird das grundlegende LLM-Release-Bundle für Retrieval konkret. Das Release-Artefakt ist unveränderlich; die indexierten Dokumente bleiben eine laufend aktualisierte materialisierte Sicht. Ergänzen Sie das Routenmanifest deshalb um einen separaten Ingestion-Checkpoint und ein Löschregister. Eine fixierte Konfiguration friert die Quelldaten nicht ein.
Erzeugen Sie Embeddings neu, statt alte Vektoren umzubenennen
Laut Elastic-Dokumentation zur Reindex-API kopiert Reindex Dokumente und benötigt _source. Indexeinstellungen, Mappings, Shard-Anzahl und Replikate werden nicht übernommen. Konfigurieren Sie den Zielindex ausdrücklich. Das Kopieren eines gespeicherten Vektorfelds ist keine Inferenz mit einem neuen Embedding-Modell. Eine gezielt konfigurierte und getestete Ingest-Inferenzpipeline kann Embeddings neu erzeugen; Reindex allein stellt diesen Vertrag jedoch nicht her.
Verwenden Sie den maßgeblichen extrahierten Text samt Quellrevision, keinen undurchsichtigen Vektorexport. Liegt Text nur noch als gekürzter Chunk im alten Index vor, prüfen Sie zuerst, ob dieser die erforderlichen Belege für das neue Modell bewahrt. Halten Sie das Chunking beim ersten Migrationsvergleich möglichst konstant. Erzwingt ein neues Tokenlimit andere Chunks, kennzeichnen Sie das Release als kombinierte Änderung und führen Sie ein Dokument-zu-Chunk-Manifest, damit überholte Chunks entfernt werden können.
Die Modellkarte von multilingual E5 large nennt beispielsweise Embeddings mit 1.024 Dimensionen, die Präfixe query: und passage: für asymmetrisches Retrieval auch bei nicht englischem Text sowie ein Limit von 512 Tokens. Die Beispiele verwenden aufmerksamkeitsmaskengestütztes Mean Pooling und Normalisierung. Das sind Anforderungen dieses Modells, keine universellen Embedding-Standards. Zählen Sie Präfixe, Titel und spezielle Tokens bei der Längenprüfung mit. Ein stillschweigend abgeschnittener Sicherheitshinweis darf nicht als erfolgreicher Backfill gelten.
Prüfen Sie vor Schreibzugriffen Dimensionen und endliche Zahlenwerte. Gleichen Sie Ähnlichkeitsmaß und Normalisierung mit der eingesetzten Vektor-Engine ab. Speichern Sie Modellrevision, Inhaltsdigest, Chunk-Identität und Encoding-Vertrags-ID zu jedem Ergebnis. Übergeben Sie unpassende oder nicht codierbare Datensätze in eine überwachte Fehlerwarteschlange mit Verantwortlichem. Gleiche Dokumentanzahlen beweisen keine vollständige Migration.
Bauen Sie zwei Projektionen aus einem dauerhaften Änderungsstrom
Die vorgeschlagene Architektur trennt Neuaufbau und laufende Änderungserfassung. Das gemeinsame Quellprotokoll enthält Dokumentänderungen, ACL-Änderungen und Löschungen. Es transportiert nicht die Vektoren eines Modells in den Index des anderen. Beide Encoder verarbeiten Text unter ihrem jeweiligen Vertrag.
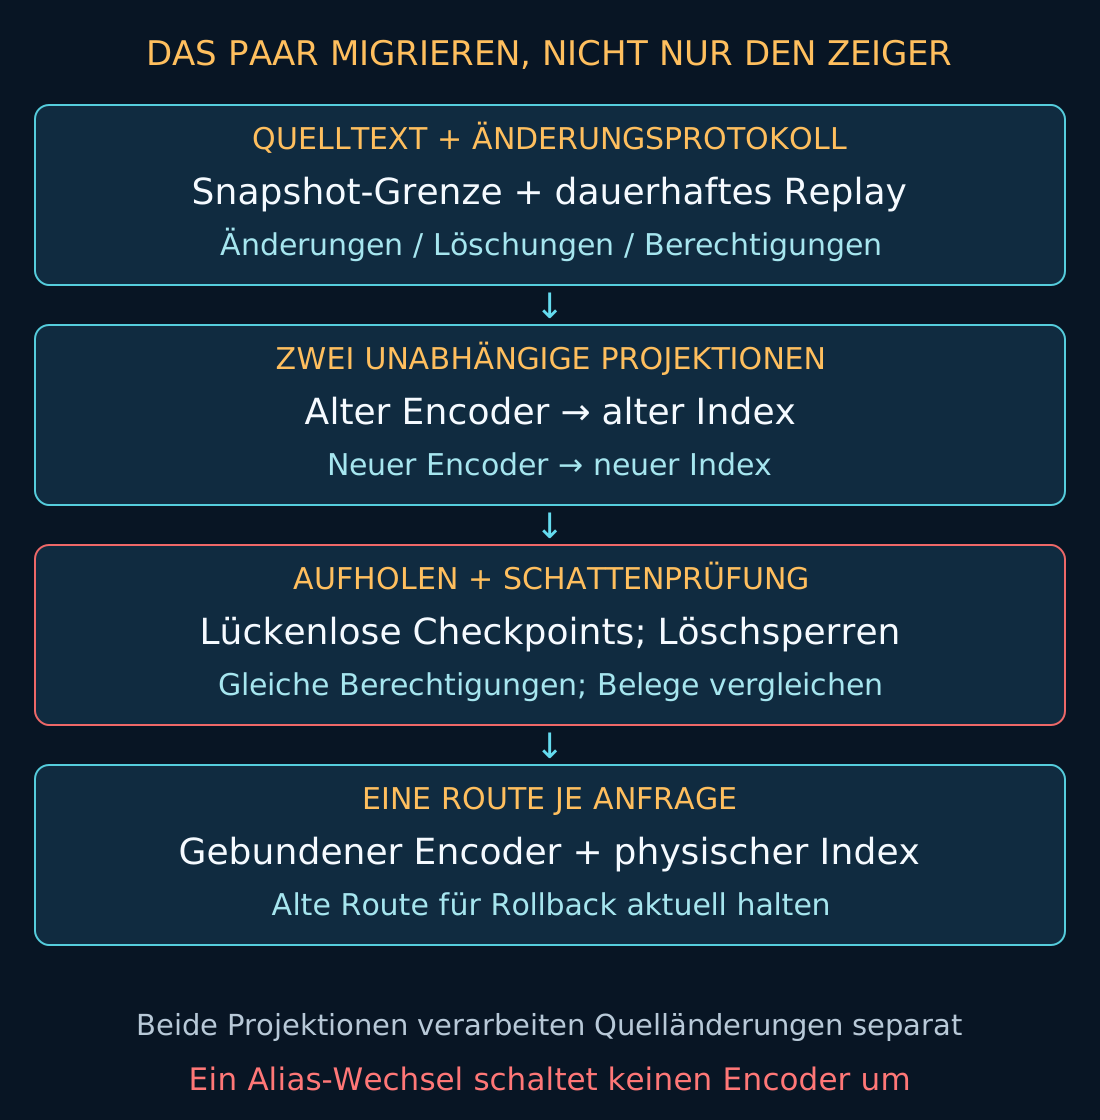
Erfassen Sie vor dem Snapshot einen Quellcheckpoint und bewahren Sie jede nachfolgende Änderung auf. Bei partitionierten Streams ist dies meist eine Menge partitionsbezogener Positionen, keine einzelne globale Zahl. Snapshot und Änderungserfassung müssen jede Änderung lückenlos abdecken; Überlappungen sind bei idempotenter Verarbeitung zulässig. Nutzen Sie das dokumentierte Snapshot-/CDC-Verfahren des Quellsystems. Können Sie diese Grenze nicht nachweisen, benötigen Sie ein Wartungsfenster oder einen Abgleich, der die Lücke nachweisbar schließt, statt eine Online-Garantie zu behaupten.
Betreiben Sie unabhängige Consumer für alte und neue Route auf Basis einer transaktionalen Outbox oder eines anderen dauerhaften Quellfeeds. Zwei HTTP-Schreibzugriffe nach dem Best-Effort-Prinzip reichen nicht: Der erste kann erfolgreich sein, während der zweite scheitert. Persistieren Sie Bestätigung, Retry-Zustand und Fortschrittsmarke pro Ziel für lückenlos erfolgreich angewandte Ereignisse. Der höchste jemals beobachtete Offset ist kein Vollständigkeitsnachweis, solange frühere Ereignisse offen sind.
Verwenden Sie monotone Quellrevisionen innerhalb der jeweiligen Dokumentreihenfolge. Ein langsamer Backfill darf eine neuere Änderung nicht überschreiben. Nach einer Löschung muss eine Revisionssperre oder ein dauerhafter Tombstone verhindern, dass ein verspätetes Embedding das Dokument wiederherstellt. Ändert ein Update die Chunk-Grenzen, gleichen Sie die vollständige neue Chunk-Menge ab und entfernen Sie ersetzte Chunks. Verhindern Sie, dass alte Worker anschließend überholte Chunk-IDs erneut einfügen. Dies sind Anwendungsanforderungen, keine Garantien eines Alias.
Elastic dokumentiert, dass Reindex mit standardmäßiger interner Versionierung passende Ziel-IDs überschreiben kann. Externe Versionierung bewahrt dagegen Quellversionen und aktualisiert nur ältere Ziele. Das hilft nur, wenn die Version die richtige maßgebliche Bedeutung hat. Es erzeugt keine konsistente Quellrevision über unabhängige Systeme hinweg und ersetzt kein dauerhaftes Löschregister. Testen Sie die tatsächlichen Schreib- und Löschsemantiken einschließlich Wiederholungen nach Ablauf temporärer Tombstones.
Machen Sie die Freigabe zu einer Entscheidung
| Zustand | Erforderlicher Nachweis | Betriebsentscheidung | Stoppbedingung |
|---|---|---|---|
| Backfill | Snapshot-Abdeckung; Encoding-Fehler erfasst | Alte Route bedient weiter | Fehlender Quellbereich oder unklare Chunk-Zuordnung |
| Aufholen | Jede Partition bis zur Barriere angewandt; Löschungen und ACLs abgeglichen | Kontrollierten Schattenbetrieb erlauben | Offenes Ereignis vor der Barriere |
| Schattenbetrieb | Vergleich autorisierter Belege; Latenz und Kosten gemessen | Begrenzten Canary freigeben | Kritischer Qualitäts- oder Berechtigungsfehler |
| Canary | Vollständige Route je Anfrage; beide Projektionen aktuell | Verkehr gezielt ausweiten | Vermischter Encoder-/Index-Vertrag |
| Umgestellt | Neue Route aktiv; alte Route besteht Aktualitätsprüfung | Rollback-Fenster offen halten | Alte Route verpasst notwendige Änderungen |
| Stillgelegt | Rollback-Fenster geschlossen; Aufbewahrung und Löschung geklärt | Alten Zugriffspfad und Zugangsdaten entfernen | Offene Aufbewahrungs- oder Löschpflichten |
Eine Aufholbarriere belegt, dass der Kandidat einen definierten Quellpräfix angewandt hat. Sie macht spätere Quelländerungen nicht automatisch synchron durchsuchbar. Definieren Sie zulässigen laufenden Ingestion-Verzug und eine Prüfung der Suchsichtbarkeit für beide Routen. Verspricht der Dienst stärkere Read-after-write-Eigenschaften, stimmen Sie eine Schreibbarriere oder kurze Schreibpause mit dem Anwendungsverantwortlichen ab. Ein Checkpoint begründet keine Konsistenzstufe, die das Produkt nicht tatsächlich liefert.
Schattenverkehr bleibt produktiver Datenzugriff
Führen Sie die neue Route mit demselben authentifizierten Mandanten- und Benutzerkontext wie die aktive Anfrage aus. Autorisieren Sie vor dem Retrieval und prüfen Sie Dokumentzugriffe erneut, soweit die Richtlinie dies verlangt. Auch eine dem Benutzer nicht angezeigte Schattenantwort kann geschützte Textstellen in Traces, externe Encoder oder Evaluationsspeicher übertragen. Verwenden Sie minimale Belegkennungen, zugriffsgeschützte Protokolle und freigegebene Datenverarbeitungsgrenzen.
Die bestehenden Kontrollen zur Mandantentrennung in RAG gelten für beide Indizes und jeden Cache. Versionieren Sie Cache-Schlüssel nach Route, Mandant und relevantem Berechtigungskontext. Invalidieren oder reautorisieren Sie zwischengespeicherte Ergebnisse nach Berechtigungsänderungen. Eine Migration darf keinen alten Antwortcache mit gelöschten Inhalten wieder aktivieren.
Vergleichen Sie beide Routen mit eingefrorenen, berechtigungsbewussten Testfällen: Abdeckung relevanter Belege, Verhalten bei unbeantwortbaren Fragen, Ausschluss veralteter Dokumente und kritische Sprach- beziehungsweise Fachsegmente. Vergleichen Sie Rangfolgen oder bewertete Relevanz, keine rohen Ähnlichkeitswerte verschiedener Modelle. Messen Sie p95-Latenz, Fehler, Ingestion-Verzug und Kosten je versuchter Anfrage unter der vorgesehenen Parallelität. Das RAG-Evaluationsharness liefert das übergreifende Qualitätsgate; die Migration ergänzt Zustandskonsistenz und Routingtests. Ein besserer mittlerer Retrieval-Wert hebt keinen Lösch- oder Mandantentrennungsfehler auf.
Schalten Sie die Route um, nicht nur den Alias
Die Elastic-Dokumentation zu Aliasen unterstützt Remove-/Add-Aktionen in einer atomaren Alias-Operation. Sie dokumentiert jedoch auch teilweise fehlgeschlagene Aktionen, darunter eine bestätigte Antwort mit errors: true. Prüfen Sie action_results und verwenden Sie gegebenenfalls must_exist, damit fehlende Voraussetzungen zum Fehler führen statt eine unbeabsichtigte Zuordnung zu erzeugen. Kontrollieren Sie den tatsächlichen Alias-Zustand nach der Operation, auch nach einem Timeout des Aufrufers.
Selbst ein erfolgreicher atomarer Alias-Wechsel umfasst nur den Alias-Zustand von Elasticsearch, nicht das Deployment eines separaten Encoders. Bevorzugen Sie unveränderliche physische Indexreferenzen im Routenmanifest. Ein kontrollierter Zeiger wählt beim Anfrageeingang die gesamte Route. Canary-Zuordnungen und laufende Anfragen behalten die gewählte Route. Muss ein Alias wechseln, ordnen Sie ihn eindeutig einer Route zu und verhindern Sie, dass alte Encoder-Anfragen dem neu umgeleiteten Ziel folgen.
Verwenden Sie für die Deployment-Entscheidung Compare-and-swap gegen die erwartete aktive Route. Prüfen Sie zuerst die Bereitschaft des Kandidaten, veröffentlichen Sie dann den Zeiger und beobachten Sie die tatsächlich von jedem Worker bediente Version. Unterschiedliche Anwendungsversionen sind nur zulässig, wenn jede den Routenvertrag versteht oder bei Unklarheit ablehnt. Ein gleichzeitiger Wechsel der gesamten Flotte ist nicht erforderlich; Kompatibilität innerhalb jeder Anfrage schon.
Testen Sie Fehler vor der Rollback-Freigabe
Test 1 — falsche Dimension: Injizieren Sie ein Embedding mit unpassender Länge. Erwartet wird eine Ablehnung vor der Vektorsuche samt Vertragsfehler, kein stilles Auffüllen oder Abschneiden.
Test 2 — gleiche Dimension, falscher Encoder: Kennzeichnen Sie einen Vektor mit der neuen Encoding-Vertrags-ID, während die alte Route adressiert wird. Erwartet wird eine Ablehnung trotz gültiger Array-Form. Eine reine Dimensionsprüfung muss an diesem Test scheitern.
Test 3 — verspätetes Ergebnis nach Löschung: Planen Sie die Codierung einer Dokumentrevision A, verarbeiten Sie deren spätere Löschung und liefern Sie erst danach das verzögerte Embedding. In keiner Projektion darf das Dokument durchsuchbar sein. Wiederholen Sie den Test nach Worker-Neustart und mit geänderten Chunk-Grenzen.
Test 4 — vermischte Route beim Deployment: Pausieren Sie eine Anfrage nach der Codierung, schalten Sie den Kandidaten frei und setzen Sie die Anfrage fort. Sie muss ihren ursprünglich gebundenen Index abfragen, nicht das inzwischen aktive Alias-Ziel.
Test 5 — unzulässiger Schattenzugriff: Führen Sie eine Anfrage von Mandant A aus, während beide Indizes ein Canary-Dokument von Mandant B enthalten. Weder B-Kennungen noch B-Text dürfen in Ergebnissen, Reranker-Eingaben oder Diagnoseprotokollen erscheinen. Wiederholen Sie dies nach ACL-Entzug und bei einem Cache-Treffer.
Test 6 — veraltetes Rollback-Ziel: Stoppen Sie den alten Consumer, ändern Sie ein Dokument, löschen Sie ein anderes und fordern Sie ein Rollback an. Der Controller muss ablehnen, bis Aufholen und Suchsichtbarkeit nachgewiesen sind, oder einen ausdrücklich freigegebenen eingeschränkten Modus wählen, der keine veralteten geschützten Inhalte ausliefert.
Ein noch vorhandener alter Index ist nicht automatisch ein sicheres Rollback-Ziel. Halten Sie Encoder-Artefakte, Zugangsdaten, Schreib-Consumer und Berechtigungsverarbeitung während des vereinbarten Fensters betriebsfähig. Verarbeiten Sie Löschungen auch auf aufbewahrten Kopien weiter. Lassen sich Kompatibilität, Aktualität oder Berechtigungen nicht schnell wiederherstellen, ist eine begrenzte Dienstunterbrechung besser als die Ausgabe verbotener Belege. Legen Sie alte Routen bewusst still, sobald ihr Rollback-Nutzen Kosten und Aufbewahrungsaufwand nicht mehr rechtfertigt.
Kosten, Grenzen und ein konkreter Einstieg
Parallele Indizes erhöhen Speicherbedarf und Indexierungsarbeit. Schattenanfragen verursachen zusätzliche Inferenz- und Suchlast; unabhängige Consumer erweitern den Betriebszustand. Der Mehrbedarf hängt von der Last ab und ist nicht automatisch eine exakte Verdopplung. Testen Sie Backfill-Drosselung gegen die produktive Latenz und reservieren Sie Kapazität für Wiederholungen. Ein Migrationshandbuch repariert weder ein schwaches Relevanzmodell noch lückenhafte Änderungserfassung oder umgehbare Autorisierung.
Beginnen Sie mit einer repräsentativen Korpuspartition. Definieren Sie Routenmanifest, lückenlose Quellgrenze, Löschsperren und Freigabetabelle vor dem vollständigen Re-Embedding. Proben Sie eine verspätete Änderung, eine verspätete Löschung und eine laufende Anfrage über den Umschaltzeitpunkt hinweg. Für eine Migrationsprüfung bringen Sie den Quelländerungsvertrag, die Encoder-Konfiguration und Ihr Rollback-Handbuch mit: Ich unterstütze Ihr Team dabei, daraus ausführbare Abnahmetests und eine Umschaltentscheidung mit expliziten Fehlergrenzen zu entwickeln.