Prüfen Sie vor dem überwachten Fine-Tuning die Labels, die Tokenizer, Chat-Template und Collator tatsächlich erzeugen. Ein sinkender Loss beweist nicht, dass die vorgesehenen Antworten trainiert werden. Fordern Sie Token-Zähler je Rolle, erhaltene Antwortenden und gezielte Negativtests, bevor Sie Trainingsrechenzeit freigeben.
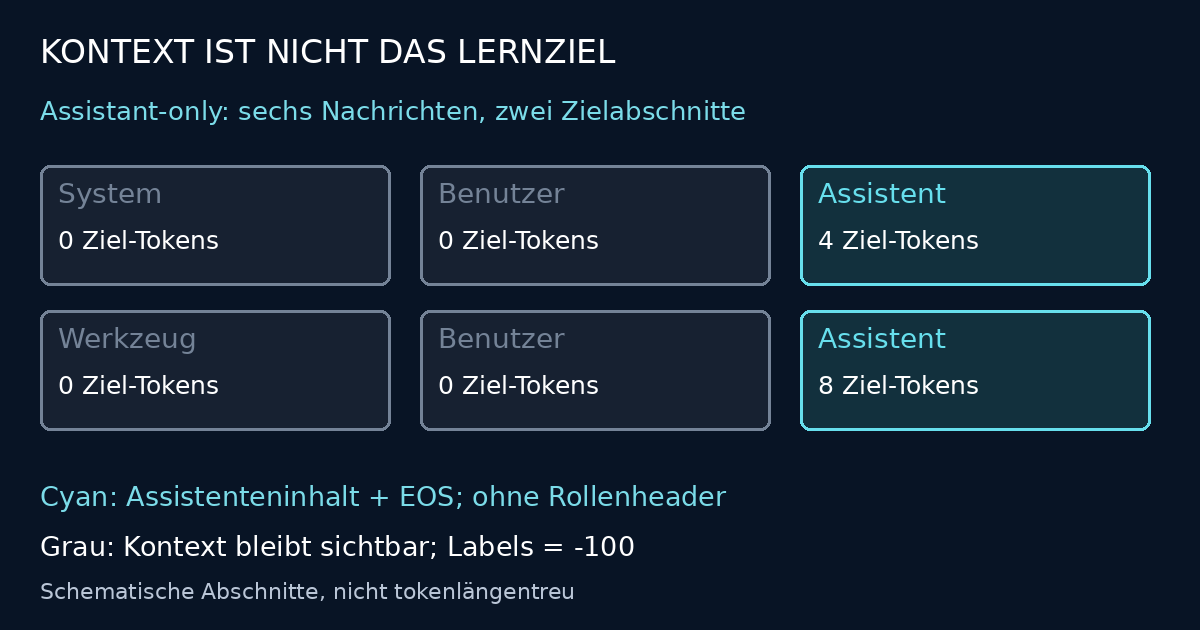
Betrachten Sie einen Wartungsassistenten mit Systemregel, Anfrage zum Pumpenzustand, werkzeugähnlicher Assistentenanweisung, Werkzeugergebnis und abschließender Empfehlung. Er soll das freigegebene Verhalten des Assistenten lernen, nicht die Fragen des Bedieners oder die Messwerte des Werkzeugs reproduzieren. Dieses Ziel ist ein Vertrag der Datenverarbeitung. Weder ein Rollenfeld im ursprünglichen JSON noch eine Attention-Maske beweist, dass der Vertrag Tokenisierung und Batchbildung übersteht.
Dieser Beitrag prüft genau diesen Vertrag mit synthetischen englischen und deutschen Dialogen. Er berichtet weder Kundendaten noch einen produktiven Trainingslauf oder eine Verbesserung der Modellqualität. Falls die Trainingsentscheidung noch offen ist, beginnen Sie mit dem Entscheidungsrahmen für Fine-Tuning, RAG und Prompting. Ein korrektes Lernziel behebt keinen Anwendungsfall, der eigentlich aktuellere Retrieval-Daten benötigt.
Attention und Supervision beantworten unterschiedliche Fragen
Bei einem kausalen Sprachmodell sind input_ids die dem Modell übergebenen Tokens. Der Attention-Mechanismus steuert, welche Kontextpositionen nutzbar sind; eine gewöhnliche Padding-attention_mask unterscheidet echte Eingaben von Batch-Padding. Labels bestimmen die Vorhersageziele. Im geprüften Pfad ignoriert die Kreuzentropie Positionen mit Label -100. Benutzertext kann damit als Kontext sichtbar bleiben, ohne unmittelbar als Vorhersageziel zum Loss beizutragen.
Entfernen Sie nicht sämtliche Benutzertokens aus der Attention, nur weil das Modell deren Reproduktion nicht lernen soll. Es benötigt die Anfrage, um die Antwort vorherzusagen. Umgekehrt bedeutet ein Attention-Wert von eins nicht, dass die Position ein überwachtes Ziel sein muss. Prüfen Sie den Batch nach der Collation, nicht nur die Quelldatensätze.
Auch die kausale Ausrichtung zählt. Im hier verwendeten gewöhnlichen Transformers-Vertrag für kausale Sprachmodelle sind Labels zunächst an den Eingabepositionen ausgerichtet; die Loss-Berechnung verbindet Logits an Position t mit dem Label an t+1. Verschieben Sie Labels nicht vorab, wenn das Modell anschließend erneut verschiebt. Zählen Sie nutzbare Ziele nach dieser Verschiebung und brechen Sie bei einem Nenner von null ab.
Wählen Sie das Lernziel vor dem Konfigurationsschalter
Die versionierte SFTTrainer-Dokumentation von TRL unterscheidet konversationelle Sprachmodell-Datensätze von Prompt-Completion-Datensätzen. assistant_only_loss wählt Assistentenabschnitte aus, sofern das Template deren Masken liefern kann. completion_only_loss wählt den Completion-Anteil eines Prompt-Completion-Datensatzes. Gemeinsam bilden beide die Schnittmenge, nicht die Vereinigungsmenge der Zielpositionen.
Das verändert ein mehrstufiges Dialogbeispiel. Ein vollständiger Dialog kann zwei Assistentenantworten trainieren. Enthält dagegen der Prompt alle früheren Turns und die Completion nur die letzte Antwort, wird die frühere Assistentenantwort nicht trainiert. In diesem Test umfasst Completion-only außerdem den Rollenheader der letzten Antwort; Assistant-only schließt Rollenheader gemäß expliziter Template-Regel aus. Übertragen Sie diese Header-Entscheidung nicht pauschal auf andere Modell-Templates.
| Daten und Lernziel | Konfiguration | Erforderliche Prüfung |
|---|---|---|
| Voller Dialog: Assistentenantworten | assistant_only_loss=True | Generation-Spannen und Rollenregel |
| Nur letzte Completion | completion_only_loss=True | Prompt-/Completion-Grenze |
| Assistent innerhalb Completion | Beide aktiviert | Schnittmenge; frühere Antworten ausgeschlossen |
| Gesamte Sequenz als Ziel | Beide deaktiviert | Benutzer-/Systemziele ausdrücklich gewollt |
Die Tabelle hilft bei der Auswahl, empfiehlt aber nicht, native Steuertokens eines vortrainierten Modells zu ersetzen. Der Test verwendet bewusst ein kleines eigenes Template mit prüfbaren Grenzen. Erhalten Sie bei einem realen Checkpoint dessen erwartetes Format und prüfen Sie ein kompatibles Trainings-Template. Generation-Marker sind Template-Anweisungen, keine zusätzlichen Tokens für die Modelleingabe.
Was tatsächlich ausgeführt wurde
Der CPU-Test fixiert TRL 0.23.1, Transformers 4.56.2, tokenizers 0.22.2 und PyTorch 2.9.0+cpu. Er lief unter Python 3.14.9. Das sind geprüfte Versionen, keine Behauptung über die neuesten Releases. Ein lokaler WordLevel-Tokenizer besitzt 54 Vokabulareinträge, explizite Rollentokens und ein [EOS]-Token, das absichtlich zugleich als Padding dient. Das zufällig initialisierte GPT-2-Modell hat eine Schicht, zwei Attention-Heads und eine Embedding-Dimension von 32. Es wurden weder vortrainierte Gewichte heruntergeladen noch Optimizer-Schritte ausgeführt.
Jede Sprache enthält sechs Nachrichten: System → Benutzer → Assistent → Werkzeug → Benutzer → Assistent. Die englischen Texte lauten „Follow approved maintenance policy“, „Check pump status“, „CALL inspect pump“, „pressure normal vibration high“, „What should I do next“ und „Request operator review before intervention“. Die deutschen Texte lauten „Befolgen Sie freigegebene Wartungsregeln“, „Prüfen Sie den Pumpenstatus“, „AUFRUF prüfen Pumpe“, „Druck normal Schwingung erhöht“, „Was soll ich als Nächstes tun“ und „Fordern Sie vor Eingriffen eine Bedienerprüfung an“. Dies sind einfache synthetische Zeichenfolgen, weder echtes Tool-Call-JSON noch eine industrielle Betriebsanweisung.
Die Regel trainiert Assistenteninhalt und dessen echtes EOS, aber keine Rollenheader, System-, Benutzer- oder Werkzeugtexte und kein Padding. Der Tokenizer verwendet WhitespaceSplit und ein Vokabular aus Korpus und Spezialtokens. Der Assistentenzweig setzt Inhalt und EOS innerhalb des Generation-Abschnitts; das folgende Trennleerzeichen bleibt außerhalb. add_generation_prompt ist false. Der Trainer bereitet sowohl vollständige Dialoge als auch Prompt-Completion-Daten mit letzter Antwort auf. Sein tatsächlicher Collator erzeugt die Labels.
Erwartete und tatsächliche Ziel-Tokens
Die Tabelle zählt Positionen im aufgefüllten Batch. Rollenheader und echte Nachrichtenenden gehören jeweils zur Gesamtzahl ihrer Rolle. „Erwartet“ folgt der unabhängigen Rollen-/Header-Regel; „tatsächlich“ zählt Labels ungleich -100. Padding wird separat ausgewiesen. Es handelt sich um zwei synthetische Beispiele, nicht um allgemeine Messungen der sprachspezifischen Token-Effizienz.
| Sprache / Rolle | Batch-Positionen | Erwartete Ziele | Tatsächliche Ziele |
|---|---|---|---|
| EN / System | 6 | 0 | 0 |
| EN / Benutzer | 12 | 0 | 0 |
| EN / Assistent | 12 | 10 | 10 |
| EN / Werkzeug | 6 | 0 | 0 |
| EN / Padding | 4 | 0 | 0 |
| DE / System | 6 | 0 | 0 |
| DE / Benutzer | 14 | 0 | 0 |
| DE / Assistent | 14 | 12 | 12 |
| DE / Werkzeug | 6 | 0 | 0 |
| DE / Padding | 0 | 0 | 0 |
Assistant-only auf dem vollständigen Dialog ergibt 10 englische und 12 deutsche Ziele. Completion-only für die letzte Antwort ergibt 7 und 9; die Schnittmenge mit Assistant-only ergibt 6 und 8. Dieser Unterschied ist messbar, obwohl alle drei Konfigurationen denselben Dialoginhalt erhalten. Vergleichen Sie Lernziele anhand ihrer Zielpositionen und Nenner, nicht allein anhand eines niedrigeren aggregierten Loss.
Ein kleiner Forward-Pass ergab einen Loss von 4,020492. Eine unabhängig berechnete Kreuzentropie aus Logits ohne letzte Position und Labels ohne erste Position stimmte damit überein; der Nenner umfasste 22 überwachte Ziele. Das prüft nur Ausrichtung und Maskierungsarithmetik. Ein endlicher Loss eines Zufallsmodells belegt weder Lernen noch Sicherheit oder wirtschaftlichen Nutzen.
Ein Grenzfehler, den der Test tatsächlich fand
Ein erstes Template platzierte das Trennleerzeichen nach dem Assistenten-EOS innerhalb des Generation-Abschnitts. Im fixierten Tokenizer-/Template-Pfad nahm die zurückgegebene Assistentenmaske dadurch den folgenden Werkzeug-Rollenheader auf. Die rollenbezogene Assertion schlug fehl, obwohl der gerenderte Dialog korrekt aussah. Nachdem das Trennzeichen außerhalb lag, entsprach die Maske der Vorgabe. Ein beibehaltener Negativtest reproduziert den Fehler und bestätigt gleichzeitig unveränderte input_ids.
Das ist eine Beobachtung dieses Tests, keine Behauptung, dass jedes Hugging-Face-Chat-Template diesen Fehler enthält. Sie zeigt, warum gerenderter Text oder Token-IDs allein nicht genügen: Zwei Templates können identische Modelleingaben und unterschiedliche Vorhersageziele erzeugen. Ein weiterer Regressionstest verschiebt EOS aus dem vorgesehenen Assistentenabschnitt und verlangt, dass die geänderte Maske erkannt wird.
Der Transformers-Leitfaden für Chat-Templates warnt außerdem vor doppelten Spezialtokens. Wenn Sie zunächst Text formatieren, tokenisieren Sie anschließend mit add_special_tokens=False. Der Test prüft die Gleichheit mit direkter Template-Tokenisierung und verlangt genau ein echtes EOS je Nachricht. Passen Sie diese Invariante an die tatsächliche End-of-Turn- und End-of-Sequence-Semantik des Checkpoints an. Nicht jede Architektur verwendet dafür ein gemeinsames Token.
Negativtests, die Refactoring überstehen müssen
Vollständig maskiertes Beispiel: Ersetzen Sie die Assistentenmaske durch Nullen. Die Testvalidierung weist das Beispiel zurück, weil kein verschobenes Ziel übrig bleibt. Verlassen Sie sich nicht auf eine hilfreiche Backend-Fehlermeldung. Ein leerer Zielbereich kann eine undefinierte oder anderweitig unbrauchbare Loss-Berechnung erzeugen.
Abschneiden vor der Antwort: Kürzen Sie die Tokensequenz vor dem ersten überwachten Token und verlangen Sie Ablehnung. Abschneiden innerhalb einer Antwort: Ein Ein-Token-Präfix besitzt weiterhin einen positiven Nenner. Deshalb erkennt der Test die fehlende Endgrenze separat. Entscheiden Sie ausdrücklich, ob Teilantworten zulässig sind; lassen Sie nicht die maximale Sequenzlänge stillschweigend entscheiden. Zählen Sie verworfene und gekürzte Beispiele nach Sprache und Quelle.
EOS gleich Padding: Der geprüfte TRL-Collator erhält echte überwachte EOS-Positionen und ignoriert Batch-Padding. Der generische Transformers-Collator für kausales Language Modeling maskiert bei derselben gemeinsam verwendeten Token-ID dagegen auch echte EOS-Positionen. Das ist ein ausgeführter Vergleich, keine universelle Aussage über jeden Collator. Die Data-Collator-Referenz beschreibt unterschiedliche aufgabenspezifische Collatoren. Derselbe Klassenname bedeutet keinen austauschbaren Vertrag.
Packing: Ein separater Test des Padding-free-Collators verbindet beide Beispiele mit expliziten Sequenzlängen. Er prüft Positionsrücksetzungen und ignorierte Labels an Sequenzanfängen. Er führt keine gepackte Attention durch ein Modell aus und beweist keine Isolation zwischen Beispielen. Eine Positionsrücksetzung ist Metadatum, für sich genommen kein Isolationsmechanismus. Prüfen Sie die tatsächliche Attention-Implementierung und Packing-Strategie vor produktiver Aktivierung.
Machen Sie daraus eine Freigabeprüfung vor dem Training
Erstens: Fixieren Sie Modellrevision, Tokenizer-Dateien, Template-Hash, Datensatz-Snapshot, Library-Lockfile, Rollenregel, Kürzungsregel und Packing-Konfiguration. Speichern Sie für synthetische oder angemessen geschützte Beispiele einen Token-Trace mit Position, dekodiertem Token, Rolle, Eingabe-ID, Attention-Wert, Label und erwarteter Supervision. Exportieren Sie keine Kundenprompts in unbeschränkt zugängliche CI-Logs.
Zweitens: Prüfen Sie den Zielvertrag nach Vorverarbeitung und Collation. Verlangen Sie einen positiven Nenner verschobener Ziele für akzeptierte Beispiele, keine überwachten System-/Benutzer-/Werkzeugpositionen unter dieser Regel, exakte Übereinstimmung von erwarteten und tatsächlichen Labels, erhaltene freigegebene Antwortenden, ignoriertes Padding und keine unerwarteten Spezialtoken-Dopplungen. Aggregieren Sie akzeptierte, verworfene und überwachte Token-Zahlen nach Sprache und Aufgabe. Eine fehlerfreie Gesamtzahl kann ein fehlendes Segment verdecken, wenn dessen Nenner null ist.
Drittens: Führen Sie Mutationstests bei jeder Änderung an Tokenizer, Template, Collator oder Libraries aus. Behalten Sie die Fälle vollständig maskiert, abgeschnittene Antwort, EOS/Padding und gleiche Eingabe bei anderer Maske bei. Ein fixierter Paketname genügt nicht: Bewahren Sie aufgelöste Umgebung und Tokenizer-/Template-Artefakte auf. Kann das produktive Template keine zuverlässigen Assistentenabschnitte liefern, beheben Sie die Inkompatibilität. Ein Konfigurationsschalter allein belegt kein Assistant-only-Training.
Viertens: Führen Sie die kleine ausgerichtete Loss-Prüfung und anschließend die Packing-/Attention-Prüfungen der vorgesehenen Laufzeit aus. Beginnen Sie erst danach einen begrenzten Trainingspiloten. Die nächste Hürde ist eine unabhängige Evaluation zurückgehaltener Aufgaben, gefolgt von den Qualitäts- und Serving-Prüfungen für Quantisierung und Adapter. Korrekte Maskierung liegt vor diesen Freigabeentscheidungen und ersetzt sie nicht.
Was diese Prüfung nicht belegen kann
Korrekte Labels begründen weder Trainingsrechte noch repräsentative Daten, nützliches Lernen oder sichere Aktionen. Der synthetische WordLevel-Tokenizer prüft kein produktives Subword-Vokabular, keine native Werkzeugserialisierung und nicht jede mehrsprachige Grenze. Der kleine CPU-Forward-Pass misst weder GPU-Durchsatz noch Speicherbedarf oder Trainingskosten. Rechtliche und datenschutzbezogene Fragen zu den vorgesehenen Trainingsdaten müssen die zuständigen Verantwortlichen prüfen.
Wenn Sie einen teuren Fine-Tuning-Lauf vorbereiten, beginnen Sie mit einer kompakten Prüfung des Lernziels: einer freigegebenen Rollenregel, einem versionierten Batch-Trace, Mutationstests und einem eindeutigen Ablehnungsbericht. Beratung zur KI-Implementierung kann daraus eine wiederholbare Freigabeprüfung machen. Das Ziel ist ein Trainingslauf, dessen Ziel-Tokens vor dem Rechenaufwand erklärt sind – nicht lediglich eine nach unten verlaufende Kurve.