Eine geänderte DNS-Antwort für einen KI-Endpunkt verschiebt keine bereits offene Verbindung. Im isolierten Versuch lieferte der Cache nach 1,139 Sekunden Origin B, die wiederverwendete HTTP-Verbindung nach 1,140 Sekunden jedoch weiterhin Origin A. Erst das Schließen der unbeschäftigten Verbindung und ein neuer Verbindungsaufbau verlagerten die Anfrage. Prüfen Sie Aktualität der Diensterkennung, Verbindungswiederverwendung und Anfrageergebnis getrennt: Eine kurze DNS-TTL ist kein Failover-SLO.
Dieser Implementierungsleitfaden richtet sich an Teams, die Inferenz-Gateways, Retrieval-Dienste oder Clients für externe Modelle betreiben. Er beschreibt weder die Messung einer kommerziellen Modell-API noch einen Produktionsvorfall oder Envoy-Benchmark. Die entscheidende Abnahmefrage lautet: Beweist Ihr Test, dass neue Arbeit das vorgesehene Backend erreicht, oder lediglich, dass eine DNS-Abfrage inzwischen eine andere Adresse liefert?
Drei Zeitmechanismen statt eines Failover-Timers
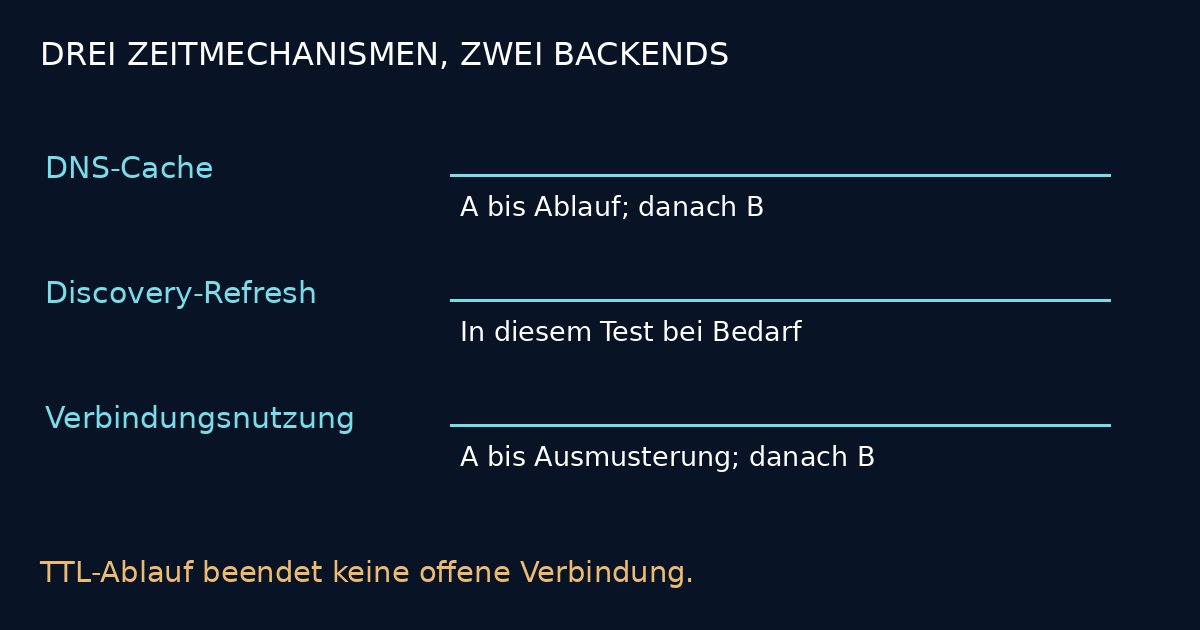
Der erste Mechanismus ist die Gültigkeit des DNS-Cacheeintrags. Die TTL eines Resource Records begrenzt dessen Speicherung im Cache, nicht die Lebensdauer einer TCP-Verbindung. RFC 1035 beschreibt Nachrichtenformat und Resource-Record-TTL. Vergleichen Sie die autoritative Antwort mit der Antwort, die Ihre Anwendung tatsächlich erhält. Eine Abfrage vom Laptop über einen anderen Resolver belegt nichts über den Auflösungspfad der Anwendung.
Der zweite Mechanismus ist die Aktualisierung der Diensterkennung. Ein Client kann nur beim Verbindungsaufbau auflösen, einen eigenen Cache verwenden oder einen asynchron aktualisierenden Proxy nutzen. Der Ablauf eines Eintrags löst nicht zwangsläufig sofort eine neue Abfrage aus. Erfassen Sie konfigurierte Regeln und beobachtete Abfragezeitpunkte. Berücksichtigen Sie Container-DNS, lokale Stub-Resolver und Sidecars, statt einen gemeinsamen Cache anzunehmen.
Der dritte Mechanismus ist die Wiederverwendung bestehender Verbindungen. Eine funktionsfähige HTTP-Verbindung kann nach einer DNS-Änderung weiterhin Anfragen zum bisherigen Peer übertragen. HTTP/2-Multiplexing und lange Inferenz-Streams erschweren das kontrollierte Ausmustern zusätzlich. Eine erfolgreiche DNS-Auflösung und eine erfolgreiche Anfrage können deshalb unterschiedliche Backends beschreiben, ohne dass eine der Beobachtungen falsch ist.
Ausgeführter lokaler Test: frisches DNS, alter Peer
Der Versuch lief mit Python 3.12.13 und dnslib 0.9.26. Ein an Loopback gebundener UDP-DNS-Server beantwortete model.test autoritativ mit 127.0.0.1 oder 127.0.0.2. Zwei lokale HTTP/1.1-Server verwendeten denselben Port auf den unterschiedlichen Adressen und lieferten origin-A beziehungsweise origin-B. Ein expliziter Ein-Namen-Anwendungscache verarbeitete die DNS-Netzwerkantwort. Ein kleiner Client verwendete dieselbe http.client.HTTPConnection bis zu ihrer gezielten Ausmusterung erneut.
Positive und negative Cacheeinträge galten jeweils eine Sekunde. Es gab keinen Hintergrund-Refresh: Der Cache fragte nach Ablauf erst bei Bedarf erneut an. Eine diagnostische Abfrage aktualisierte den Cache ausdrücklich, während die ursprüngliche HTTP-Verbindung offen blieb. Dadurch ließen sich beide Mechanismen unabhängig beobachten. Der Cache ist absichtlich eng begrenzt und kein produktiver rekursiver Resolver: Delegationsketten, DNSSEC, CNAME-Verarbeitung und eine vollständige Cache-Schlüsselstrategie fehlen.
Die Reihenfolge: Verbindung zu A öffnen; autoritative Antwort auf B ändern; vor Cacheablauf abfragen; nach einer Wartezeit von 1,1 Sekunden erneut abfragen; eine weitere Anfrage über die bestehende Verbindung senden; diese erst nach vollständig gelesenem Antwortkörper als unbeschäftigte Verbindung schließen; neue Verbindung öffnen. Jede beobachtete Anfrage lieferte HTTP 200. Erst die Identität im Antwortkörper machte die alte Route sichtbar.
| Laufzeit / Ereignis | Beobachteter Zustand | Anfrageergebnis |
|---|---|---|
| 0,038 s: Antwort geändert | Autorität B; Cache A | Bestehende Verbindung zu A |
| 1,139 s: Cache aktualisiert | Autorität B; Cache B | Verbindung zu A noch offen |
| 1,140 s: Wiederverwendung | Keine neue Verbindung | 200 von origin-A |
| 1,141 s: nach Ausmusterung | Neue Verbindung zu B | 200 von origin-B |
| 1,141 s: Name repariert | Autorität B; NXDOMAIN im Cache | Auflösung scheitert weiterhin |
| 2,243 s: negativer Eintrag abgelaufen | Frische Antwort; neue Verbindung | 200 von origin-B |
Die Zeiten sind monotone Laufzeiten dieses einzelnen lokalen Versuchs, auf Millisekunden gerundet. Es sind weder Latenzperzentile noch garantierte Wiederherstellungszeiten. Die beiden Wartezeiten von 1,1 Sekunden waren vorgegebene Testeingaben, keine gemessenen DNS-Propagationszeiten. Der Versuch belegte Verbindungswiederverwendung und negative Zwischenspeicherung mit echtem lokalem HTTP- und DNS-Verkehr. TLS, Envoy, HTTP/2, TCP-Timeouts und unterbrochene Inferenz-Streams wurden nicht getestet.
Für einen vergleichbaren Test benötigen Sie eine Backend-Identität im Antwortkörper oder Serverprotokoll sowie den Socket-Peer bei jedem Verbindungsaufbau. Korrelieren Sie diese Daten mit DNS-Antworten und Cachetreffern. Fixieren Sie Laufzeit und Resolver-Bibliothek, verwenden Sie einen isolierten Testnamen und hohe lokale Ports und schließen Sie die Listener anschließend. Ändern Sie weder öffentliches DNS noch Kundenendpunkte. Eine sinnvolle Prüfaussage lautet: Nach Cacheaktualisierung meldet die wiederverwendete Verbindung weiterhin A; nach sicherer Ausmusterung der unbeschäftigten Verbindung meldet eine neue Verbindung B. Weicht Ihr tatsächlicher Client ab, bewahren Sie dessen Ablaufprotokoll auf, statt das Ergebnis dieses Testclients zu unterstellen.
Negative Antworten brauchen einen eigenen Wiederherstellungstest
In der zweiten Phase lieferte der autoritative Server NXDOMAIN mit einem SOA-Record. Der Test verwendete das Minimum aus SOA-TTL und SOA-MINIMUM, hier jeweils eine Sekunde, als negative Cachegültigkeit. Diese Regel beschreibt RFC 2308. Anschließend wurde die autoritative Adresse sofort wiederhergestellt. Der Cache lieferte weiterhin den gespeicherten negativen Befund, bis nach Ablauf erneut abgefragt wurde. Nach 2,243 Sekunden erreichte die neue Anfrage B.
Am Phasenübergang wurde der vorherige positive Cacheeintrag absichtlich ungültig gemacht, damit die nächste Abfrage NXDOMAIN sah. Das ist Testvorbereitung und keine Empfehlung, bei jedem Vorfall Caches zu leeren. NXDOMAIN bedeutet, dass ein Name nicht existiert. NODATA bedeutet, dass für einen existierenden Namen der angefragte Record-Typ fehlt. Beides unterscheidet sich von einem Transport-Timeout. Getestet wurde nur NXDOMAIN. Produktive Resolver können zusätzlich veraltete Antworten weiterverwenden, mehrere Cacheebenen durchlaufen und Fehler unterschiedlich behandeln. Die eine Sekunde ist kein universeller Timer.
Ein gescheiterter TCP-Verbindungsaufbau tritt auf, nachdem eine Adresse ausgewählt wurde. Unterscheiden Sie SYN-/Connect-Timeout, Verbindungsverweigerung, TLS-Prüffehler und HTTP-Fehler. Da dieser Versuch keinen TCP-Timeout injizierte, belegt er weder dessen Dauer noch das Retry-Verhalten. Verbinden Sie einen späteren Timeout-Test mit einem ausdrücklichen Retry-Budget, nicht mit einer unbegrenzten Wiederverbindungsschleife.
Entscheidungstabelle für die Störungsanalyse
| Beobachtung | Nächste unterscheidende Prüfung | Vermeiden |
|---|---|---|
| Autorität B; Anwendung A | Tatsächlicher Resolver-Pfad und TTL | Zuerst den HTTP-Pool beschuldigen |
| Cache B; alter Peer A | Verbindungsalter und Wiederverwendung | TTL mit Socket-Ende gleichsetzen |
| Neuer Peer B; falsches Backend | Gateway-Routing und Origin-Identität | Nur der Peer-IP vertrauen |
| Autorität repariert; NXDOMAIN | Negative TTL und Cacheebene | Als TCP-Timeout einordnen |
| Adresse aufgelöst; Verbindung scheitert | Transport, TLS und Fristverlauf | Unbegrenzte Wiederholungen |
Erfassen Sie Korrelations-ID, Abfragezeitpunkt, Antwort und verbleibende TTL, Cacheebene, Verbindungsaufbauzeit, Peer-Adresse, Backend-Identität und Ergebnis. Protokollieren Sie dafür keine Prompts, Zugangsdaten oder vollständigen Kundeninhalte. Die Adresse eines Gateways kann gleich bleiben, während sich sein Upstream ändert. Dann reicht die Socket-Peer-Adresse allein nicht aus, um den tatsächlich ausführenden Modell-Worker zu bestimmen.
TLS-Identität und aktive Arbeit erhalten
Der lokale Versuch nutzte unverschlüsseltes HTTP auf Loopback und änderte keine TLS-Verifikationseinstellung. Für produktive HTTPS-Tests müssen ursprünglicher Hostname für Zertifikatsprüfung, SNI und HTTP-Authority erhalten bleiben, während Sie ausschließlich die Adressauswahl steuern. Ersetzen Sie den URL-Hostnamen durch eine IP-Adresse oder deaktivieren Sie die Prüfung, kann ein vermeintlich erfolgreicher Verbindungstest den Sicherheitsvertrag des Dienstes umgehen.
Prüfen Sie vor einer produktiven Verbindungsrotation folgende Abnahmekriterien:
1. Ermitteln Sie tatsächliche Client- und Proxy-Versionen, Resolver-Pfad, DNS-Refresh-Regeln und negative Cacheeinstellungen. Dokumentieren Sie die wirksame Konfiguration, nicht nur eine Deployment-Vorlage.
2. Prüfen Sie Zertifikat, Authentifizierung, Modellroute und Protokoll am Ersatzendpunkt. Testen Sie ein falsches Zertifikat als erwartete Ablehnung in einem gesonderten kontrollierten TLS-Test.
3. Trennen Sie unbeschäftigte von aktiven Verbindungen. Weisen Sie einer auslaufenden Route keine neue Arbeit zu und lassen Sie bereits angenommene Streams unter einer dokumentierten Frist abschließen. Beenden Sie nicht pauschal alle Verbindungen, nur damit der DNS-Test erfolgreich aussieht.
4. Erfassen Sie unfertige Anfragen und entscheiden Sie ausdrücklich, wann eine Wiederholung sicher ist. Teilweise übertragene Generierungen oder Workflows mit Werkzeugaufrufen sind nicht zwangsläufig wiederholbar. Stimmen Sie dies mit dem kontrollierten Beenden von KI-Diensten ab, statt offene Arbeit durch Wiederverbindung zu verdecken.
5. Messen Sie aus Clientsicht Abschlüsse und Fehler zusammen mit der Backend-Identität. Verknüpfen Sie die Abnahme mit Inferenz-SLOs, nicht allein mit GPU-Auslastung oder erfolgreichen DNS-Abfragen.
Dies sind Anforderungen an die Produktionsabnahme, keine Behauptungen über bereits geprüfte TLS- oder Stream-Eigenschaften dieses kleinen Versuchs. Häufige Verbindungsrotation verursacht zusätzliche Handshakes und Verwaltungsaufwand. Langlebige Pools reduzieren diese Kosten, können die Verkehrsverlagerung aber verzögern. Leiten Sie die Regeln aus Anfragefristen und Abschaltfenster des Backends ab und testen Sie geordneten Wechsel und harten Ausfall getrennt.
Was Sie bei Envoy zusätzlich prüfen müssen
Die Envoy-Dokumentation zur Diensterkennung ist die Primärquelle zu Discovery-Typen und Aktualisierungsregeln. Dieser Versuch führte Envoy nicht aus und enthält daher bewusst keinen gemessenen Vergleich zwischen Strict DNS und Logical DNS. Der kleine Testclient darf nicht als einer dieser Modi ausgegeben werden.
Fixieren Sie für einen Envoy-Test Release und Konfiguration und führen Sie dieselbe Beobachtungssequenz über genau dieses Programm aus. Prüfen Sie Discovery-Typ, Berücksichtigung der TTL, Refresh-Intervall, Aktualisierung nach Fehlern, Health Checks und Verhalten beim Ausmustern von Verbindungspools. Erfassen Sie Aktualisierungsversuche, Erfolge und Fehler gemeinsam mit der tatsächlichen Upstream-Identität. Ein dokumentierter Standardwert belegt nicht die wirksame Konfiguration Ihres Deployments.
Definieren Sie den Nachweis vor der Migration
Ein belastbarer Failover-Abnahmetest beantwortet drei Fragen: Was lieferte die Diensterkennung, welche Verbindung transportierte die Anfrage und welches Backend schloss sie ab? Zusätzlich benennt er ungetestete Eigenschaften. Eine einzelne dig-Ausgabe oder HTTP 200 beantwortet diese Fragen nicht vollständig.
Beginnen Sie vor einem Wechsel des Inferenzendpunkts mit einer Bestandsaufnahme der Clients und Pools sowie einem isolierten Ablaufprotokoll. Bringen Sie Resolver-Pfad, wirksame Proxy-Konfiguration, Stream-Fristen und Rückfallkriterien in eine Implementierungsprüfung mit Ade Christanto ein. Das Ergebnis sollte ein reproduzierbarer Abnahmetest mit ausdrücklichen Ausmusterungsregeln sein – kein Versprechen, jede Anfrage innerhalb einer TTL zu verschieben.