BLUF: Behandeln Sie jedes neue Metriklabel als Zulassungsentscheidung. Request-IDs und unbegrenzte Mandantenkennungen gehören nicht in Inferenzzähler oder Latenzhistogramme. Erlauben Sie nur Dimensionen mit verantwortetem, begrenztem Wertebereich. Filtern Sie vor der Aggregation, prüfen Sie das Overflow-Verhalten des tatsächlich eingesetzten SDKs und zählen Sie exportierte Zeitreihen. Ein Instrument erzeugt nicht automatisch nur eine Zeitreihe. Overflow kann die Gesamtzahl der Anfragen erhalten und gleichzeitig die für ein SLO erforderliche Aufschlüsselung nach Route oder Ergebnis zerstören.
Eine lokale synthetische Test-Fixture für diesen Artikel reduzierte einen Zähler von 200 exportierten Zeitreihen auf acht, indem nur Route, Ergebnis und Release erhalten blieben. Das zugehörige klassische Histogramm sank von 1.200 auf 48 Zeitreihen. Das sind gemessene Anzahlen eines versionierten SDKs und Exporters: keine gemessene RAM-Einsparung, kein Produktionsbenchmark und kein universelles Backend-Limit. Ein separater Overflow-Test erhielt alle 200 Zählerinkremente, fasste jedoch 125 davon in einem Punkt ohne die ursprünglichen Diagnosedimensionen zusammen.
Auch ein gesundes Backend kann ein Kardinalitätsproblem bekommen
Dieser Fehler unterscheidet sich von Telemetry-Backpressure bei Backend-Ausfällen. Das Backend bleibt hier erreichbar, während ein neues Label immer mehr unabhängige Zeitreihen erzeugt. Die Anwendung hält zusätzlichen Aggregationszustand, Exporter übertragen mehr Punkte, Speicherung und Abfragen verarbeiten zusätzliche Labelkombinationen. Eine größere Versandwarteschlange beseitigt diese Vervielfachung nicht.
Die Prometheus-Namenskonventionen erläutern, dass jede eindeutige Kombination von Labelwerten eine neue Zeitreihe erzeugt, und warnen vor unbegrenzten Kennungen. Ein Routentemplate wie /inference/{model} kann begrenzt sein. Ein Rohpfad mit Kunden- oder Request-Kennung ist damit nicht gleichzusetzen. Hashing verändert die Darstellung einer Kennung, nicht ihre Kardinalität. Die Kennung in den Metriknamen zu verschieben löst das Problem ebenfalls nicht.
Beginnen Sie mit einer konkreten Frage: Welche Aufschlüsselung verändert die betriebliche Entscheidung? Routenklasse und terminales Ergebnis unterstützen häufig Zuverlässigkeitsentscheidungen. Eine Request-ID unterstützt die Untersuchung eines einzelnen Vorgangs. Diese Zwecke brauchen nicht dasselbe Speichermodell. Die bestehende SLO-Architektur für Inferenz beschreibt den Vertrag über das Nutzerergebnis; hier geht es um das Budget seiner Dimensionen.
Fünf unterschiedliche Größen
Ein Instrument ist das API-Objekt, das Messungen entgegennimmt, beispielsweise ein Zähler oder Histogramm. Ein Attributsatz identifiziert eine Aggregationsgruppe nach der View-Verarbeitung. Die Kardinalität eines Erfassungszyklus beschreibt die unterschiedlichen Metrikpunkte dieses Datenstroms an der Erfassungsgrenze. Exportierte Zeitreihen berücksichtigen zusätzlich die Backend-Darstellung, Ressourcen-, Scope- und Zieldimensionen sowie die Histogrammaufteilung. Die Kardinalität im Aufbewahrungsfenster umfasst auch früher beobachtete Labelkombinationen, die das aktuelle Release nicht mehr sendet.
Die OpenTelemetry-Metrics-SDK-Spezifikation beschreibt Attributfilter, Kardinalitätsgrenzen und das synthetische Attribut otel.metric.overflow. Dieses Konfigurationsmodell beweist nicht, dass jedes Sprach-SDK denselben Parameter unterstützt. Eine Grenze pro Datenstrom ist auch kein globales Prozessspeicherlimit: Zusätzliche Instrumente, Views, Reader, Ressourcen und Replikate verursachen eigene Kosten.
Im synthetischen Entwurf ergeben zwei Routen × zwei Ergebnisse × zwei Releases acht mögliche begrenzte Kombinationen. Mit 25 Mandanten entstehen 200. Eine weitere Multiplikation mit 200 Request-IDs ergibt eine grobe kartesische Obergrenze von 40.000, nicht die beobachtete Population: Jede ID gehört genau zu einer Anfrage. Tatsächlich enthält die rohe Fixture daher 200 Kombinationen. Zählen Sie beobachtete Tupel und kennzeichnen Sie das Produkt als Obergrenze. Stellen Sie ein nicht auftretendes Kreuzprodukt nicht als gemessenen Verkehr dar.
Unser klassisches Histogramm hat drei endliche Grenzen, einen +Inf-Bucket, einen Count und eine Summe: sechs exportierte Zeitreihen pro Attributsatz. Acht Sätze erzeugen damit 48 Zeitreihen. Diese Formel gilt für die getestete klassische Darstellung. Der Prometheus-Leitfaden zu Histogrammen unterscheidet native Histogramme, deren zusammengesetzte Samples die Zeitreihenzählung verändern. Auch native Histogramme haben Bucket- und Samplegrößenkosten. Leiten Sie aus weniger Zeitreihen keine unbelegte prozentuale RAM- oder Speichereinsparung ab.
Aggregierten Systemzustand und Einzelnachweise trennen
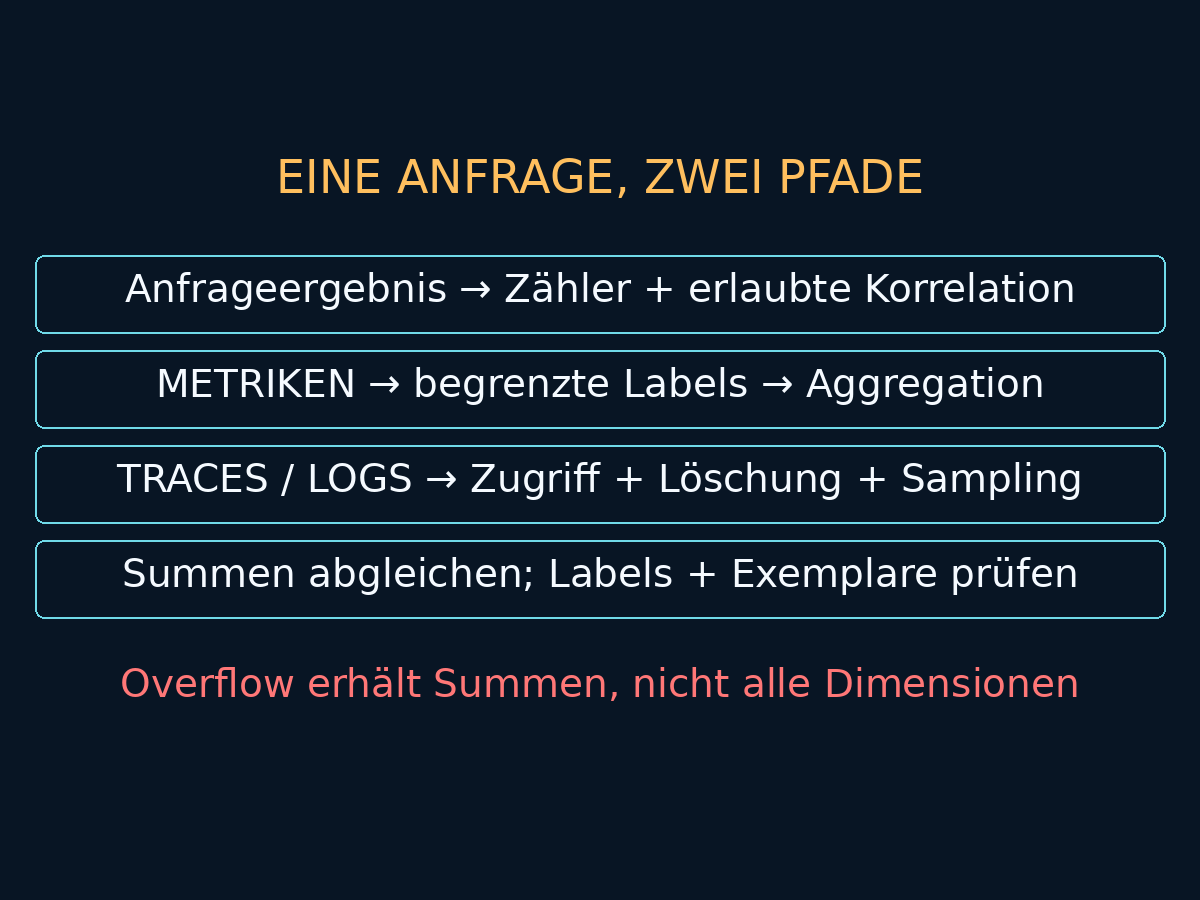
Der Metrikpfad akzeptiert eine Positivliste, normalisiert Werte auf verantwortete Enumerationen, aggregiert und exportiert begrenzte Betriebsgruppen. Der Diagnosepfad führt freigegebene Request-Korrelation in Traces oder Logs mit expliziten Regeln für Zugriff, Redaktion und Aufbewahrung. Er ist kein unbeschränktes Promptarchiv. Ein optionales Exemplar kann beide Pfade verbinden; seine Attribute benötigen jedoch eine eigene Prüfung.
Ein sensibles Attribut aus dem Metrikstrom zu entfernen ist keine vollständige Datenschutzkontrolle. Die SDK-Spezifikation warnt davor, dass herausgefilterte Attribute weiterhin in Exemplaren erscheinen können. Deaktivieren oder steuern Sie das Exemplar-Sampling und prüfen Sie die tatsächlich exportierte Nutzlast. Eine View allein garantiert nicht, dass eine Kennung den Prozess niemals verlässt.
Unabhängige Zähler sollen den Nenner der berücksichtigten Anfragen erhalten. Tail-Sampling für KI-Traces erklärt, warum selektiv aufbewahrte Traces diesen Nenner nicht ersetzen. Umgekehrt erhält eine im Overflow bewahrte Gesamtzahl nicht automatisch den nach Ergebnis getrennten Fehlerzähler, wenn dem Overflow-Punkt das Ergebnislabel fehlt.
Den Test mit begrenzten Labels reproduzieren
Die ausgeführte Fixture verwendete Node v22.22.3, @opentelemetry/sdk-metrics 2.12.0 und @opentelemetry/exporter-prometheus 0.223.0. Das sind Reproduktionsversionen, keine pauschale Deployment-Empfehlung für sämtliche Abhängigkeiten. Getestet wurden synchrone Zähler, Histogramme mit expliziten Buckets, ein manueller MetricReader mit standardmäßig kumulativer Zeitlichkeit und der Serializer des Exporters. Produktionstelemetrie, ein Prometheus-Server, das Scrape-Netzwerk und Speicherdruck waren nicht Bestandteil des Tests.
Installieren Sie die fixierten SDK- und Exporterversionen sowie @opentelemetry/api 1.9.0 in einem isolierten npm-Projekt und bewahren Sie die package-lock.json auf. Erzeugen Sie eine deterministische verschachtelte Kohorte in der Reihenfolge Route, Ergebnis, Release, Mandant: route = chat oder embed; outcome = ok oder error; release = a oder b; tenant = tenant-0 bis tenant-24. Vergeben Sie für jede der 200 Zeilen eine eindeutige req-N-Kennung. Erhöhen Sie pro Zeile ai_requests um eins und erfassen Sie 0,2 Sekunden in ai_duration. Die Histogrammgrenzen sind [0.1, 0.5, 1].
Verwenden Sie für jedes Szenario einen neuen MeterProvider, damit vorheriger kumulativer Zustand den Vergleich nicht verfälscht. Behalten Sie zunächst alle Attribute bei einem absichtlich großzügigen aggregationCardinalityLimit von 1000. Nutzen Sie anschließend das folgende View-Muster für jedes Instrument; die Histogramm-View benötigt zusätzlich die Aggregation mit expliziten Bucketgrenzen. Das ist JavaScript-Konfiguration und keine portable Collector-YAML-Einstellung:
{ instrumentName: 'ai_requests', attributesProcessors: [createAllowListProcessor(['route', 'outcome', 'release'])], aggregationCardinalityLimit: 1000 }
Die versionierte View-Implementierung stellt diese Optionen bereit. Die lokale Installation bestätigte den vorhandenen Allowlist-Prozessor und die Ausführung der konfigurierten Views. Die zusätzlich geprüfte View-Schnittstelle des Python-SDKs 1.45.1 stellte denselben Kardinalitätsparameter nicht bereit. Diese Option einfach nach Python zu kopieren würde den Versuch nicht reproduzieren.
Prüfen Sie nach reader.collect() die resourceMetrics.scopeMetrics und identifizieren Sie die Instrumente anhand ihres Deskriptornamens. Die Summe der Zählerwerte muss 200 betragen; die Summe der Histogramm-Counts ebenfalls. Serialisieren Sie diese Erfassung mit PrometheusSerializer und zählen Sie die Nichtkommentar-Samples der jeweiligen Instrumentfamilie. Dieser Serializer ist eine Implementierungsabhängigkeit des Tests, kein stabiler sprachübergreifender Vertrag. Die beobachtete Histogrammfamilie hieß ai_duration, mit Einheitenmetadatum s. Unterstellen Sie kein automatisch angehängtes seconds-Suffix.
Gemessene Anzahlen und betriebliche Entscheidungen
| Szenario | Zählerzeitreihen | Klassische Histogrammzeitreihen | Abgeglichene Anfragen | Betriebliche Entscheidung |
|---|---|---|---|---|
| Rohe Request- und Mandanten-IDs | 200 | 1.200 | 200 | Unbegrenzte Dimensionen vor Aggregation ablehnen |
| Nur Route, Ergebnis, Release | 8 | 48 | 200 | Begrenzte Betriebsaufschlüsselung erhalten |
| Mandant behalten; Request-ID entfernen | 200 | 1.200 | 200 | Request-ID-Entfernung allein reicht nicht |
| Begrenzte Labels; Limit auf 4 | 4 | 24 | 200 | Gesamtzahl bleibt; Overflow verliert Details |
| Fünf Release-Zyklen, kumulativ | 20 | 120 | 1.000 | Release-Wechsel über mehrere Zyklen budgetieren |
Diese Anzahlen schließen target_info und andere Metrikfamilien aus. Der Serializer fügte den Samples außerdem otel_scope_name und otel_scope_version hinzu. In der Fixture waren diese Werte konstant und vervielfachten die Anzahlen deshalb nicht. Unterschiedliche Scope-Versionen, Replikatidentitäten, Ressourcen-zu-Label-Umwandlung oder Scrape-Ziellabels können in einer realen Pipeline zusätzliche Zeitreihen erzeugen. Prüfen Sie die endgültige Exposition und gespeicherte Labels, nicht nur die Eingabeattribute der Anwendung.
Der Mandantentest behält absichtlich dieselben 25 synthetischen Mandanten in allen acht begrenzten Gruppen. Jeder Mandant hat eine Anfrage in jeder Gruppe. Deshalb reduziert das Entfernen von request_id allein die 200 Gruppen dieser Kohorte nicht. Realer Verkehr kann anders verteilt sein. Entscheidend ist, die verbleibenden Dimensionen zu prüfen, statt nach dem Verbot eines bekannten Labels bereits Erfolg zu melden.
Overflow verliert Details, nicht zwangsläufig Inkremente
Behalten Sie in einem getrennten Belastungsfall nur Route, Ergebnis und Release, setzen Sie aggregationCardinalityLimit jedoch auf 4. Der Delta-Prozessor der fixierten JavaScript-Version reserviert Platz für Overflow: Seine interne Schwelle für normale Gruppen entspricht dem konfigurierten Wert minus eins. Bei der Reihenfolge dieser Fixture enthalten drei normale Punkte jeweils 25 Inkremente und ein Overflow-Punkt 125. Die Summe bleibt 200; auch der Histogramm-Count stimmt mit der Eingabe überein.
Das ist beobachtetes Implementierungsverhalten, keine Behauptung identischer Grenzsemantik zwischen aktueller Spezifikation und sämtlichen SDKs. Testen Sie die genaue Grenze, Zeitlichkeit und Version Ihres Deployments. Die Spezifikation beschreibt, dass synchrone Messungen im Overflow weder doppelt gezählt noch verworfen werden sollen. Unser Test mit einer Erfassung belegt das angegebene Fixture-Ergebnis, nicht vollständige Konformität bei Nebenläufigkeit, Neustart oder allen Instrumenttypen.
Der Overflow-Punkt enthält otel.metric.overflow=true anstelle der ursprünglichen Route, des Ergebnisses und des Releases. Ein Dashboard mit Filter outcome=error kann diese 125 Inkremente daher nicht klassifizieren. Eine korrekte Gesamtzahl kann mit einer falschen oder unvollständigen SLO-Aufschlüsselung zusammenfallen. Bevorzugen Sie einen separat budgetierten Zuverlässigkeitszähler mit wenigen Dimensionen. Behandeln Sie Overflow in seinen erforderlichen Dimensionen als Instrumentierungsvorfall. Verwerfen Sie den Overflow-Punkt nicht stillschweigend, nur damit eine Grafik sauberer aussieht.
Im Release-Wechseltest erfasst jeder Zyklus 200 Anfragen unter einem neuen Release-Wert, während Route und Ergebnis begrenzt bleiben. Nach fünf Erfassungen mit kumulativem Reader enthält die Ausgabe 20 Gruppen und insgesamt 1.000 Anfragen. Vier neue Gruppen pro Zyklus sind nicht dasselbe wie 20 angesammelte Gruppen. Dieser Test nutzte das großzügige Limit; er belegt weder langfristiges kumulatives Overflow-Verhalten noch eine Speicherobergrenze über die Prozesslebensdauer.
Zulassungscheckliste für die nächste Instrumentierungsänderung
1. Benennen Sie Betriebsentscheidung, Instrument, Einheit, Verantwortlichen und erforderliche SLO-Dimensionen. Lehnen Sie Labels ohne betrieblichen Nutzer ab.
2. Definieren Sie erlaubte Schlüssel und begrenzte Werte getrennt. Eine Schlüsselpositivliste verhindert kein Wachstum der Release-, Routen- oder Mandantenwerte. Normalisieren Sie Routentemplates, definieren Sie terminale Ergebniswerte und verantworten Sie die zeitliche Relevanz von Release-Identitäten.
3. Berechnen Sie eine deklarierte Worst-Case-Obergrenze und messen Sie tatsächliche Tupel. Berücksichtigen Sie Histogrammdarstellung, Ziele, Scope-/Ressourcenerweiterungen und die Koexistenz während eines Rollouts. Trennen Sie Budgets für aktive Zeitreihen, Aufbewahrungsfenster und Samplevolumen.
4. Testen Sie eindeutige Request-IDs, viele Mandanten-IDs, Release-Wechsel und ein absichtlich kleines Limit. Gleichen Sie Eingabeinkremente und Histogramm-Counts ab. Untersuchen Sie Overflow-Attribute und endgültig exportierte Labels. Ergänzen Sie Overflow über mehrere Zyklen, Neustarts und Nebenläufigkeit, bevor Sie diese Grenzen als abgesichert betrachten.
5. Prüfen Sie Kapazität und fachliche Korrektheit gemeinsam: akzeptiertes Zeitreihenwachstum, keine unerlaubten Labels, erhaltene Gesamtzahlen, erforderliche Aufschlüsselungen und explizit geprüfte Exemplar-Nutzlasten. Weniger Zeitreihen sind kein Erfolg, wenn dadurch die Dimension zur Erkennung eines Nutzerproblems entfällt.
6. Führen Sie einen Canary durch. Messen Sie Prozessspeicher, Erfassungs- und Exportdauer, eingelesene Zeitreihen, Abfrageverhalten und Warnungen bei fehlenden Daten im tatsächlichen Backend. Halten Sie die Instrumentierungskonfiguration rücksetzbar. Die Prometheus-Instrumentierungsempfehlungen bieten hilfreiche Kardinalitätsheuristiken, aber keine universelle Obergrenze für jede Umgebung.
Nutzen und Grenzen
Filtern ersetzt unkontrolliertes Speicherwachstum durch bewussten Verlust diagnostischer Dimensionen. Eigene Traces und Logs erhalten einen Teil der Untersuchungstiefe, verursachen aber zusätzliche Zugriffs-, Aufbewahrungs-, Sampling- und Betriebskosten. SDK-Limits sind eine Schutzgrenze, kein Ersatz für einen Labelvertrag. Exporterübersetzung und Backend-Aufbewahrung bleiben separate Ebenen.
Bringen Sie für ein Inferenzgateway ein Instrumentenverzeichnis, repräsentative bereinigte Labelsätze, SDK-/Exporterversionen und die betrieblich entscheidenden Abfragen in eine Architekturprüfung ein. Daraus lassen sich eine verantwortete Labelpositivliste, ein reproduzierbarer Kardinalitätstest und ein Rollout-Gate ableiten. Das Ergebnis sollte zeigen, welche Nachweise an einer Kapazitätsgrenze erhalten bleiben – nicht bloß, dass das Monitoring-Backend grün bleibt.