BLUF: Nutzen Sie Tail-Sampling für diagnostische Belege, nicht zur Berechnung Ihrer servicebezogenen Fehlerquote. Eine Aufbewahrungsregel für Fehler oder hohe Latenz überrepräsentiert ungewöhnliche Anfragen absichtlich. Erfassen Sie Nutzerergebnisse für SLOs über unabhängig instrumentierte, nicht gesampelte Zähler. Führen Sie sämtliche Spans eines Trace zum selben Sampler und prüfen Sie verspätete Belege, Neustarts sowie Änderungen der Backend-Zusammensetzung. Ein erhaltener Fehler-Span beweist nicht, dass der vollständige Trace erhalten blieb.
Im lokalen synthetischen Test für diesen Artikel bewahrte OpenTelemetry Collector Contrib 28 von 100 Anfrage-Traces auf, darunter alle zehn absichtlich fehlgeschlagenen Anfragen. Das separate Ergebnisregister zeigte damit eine Fehlerquote von 10%, die aufbewahrte Trace-Menge dagegen etwa 35,7%. Das sind keine Produktionsbenchmarks. Die Abweichung ist die beabsichtigte Folge selektiver Aufbewahrung, keine Verschlechterung des Dienstes.
Zwei Messungen mit unterschiedlichen Verträgen
Die OpenTelemetry-Übersicht zum Sampling unterscheidet frühe Head-Entscheidungen von Tail-Entscheidungen anhand bereits eingegangener Spans. Tail-Sampling kann Fehler erhalten, die beim Beginn einer Anfrage noch nicht erkennbar waren. Dafür entstehen zusätzlicher Zustand, Rechenbedarf und Wartungsaufwand. Bei geringem Volumen kann es einfacher sein, sämtliche zulässige Telemetrie zu speichern, statt eine zustandsbehaftete Sampling-Stufe zu betreiben.
Definieren Sie Zuverlässigkeit an der Grenze der Nutzeroperation: berücksichtigte Operationen, akzeptable Ergebnisse und schlechte Ergebnisse. Bewerten Sie einen erfolgreich kompensierten Modellfehler nach dem endgültigen Nutzerergebnis, nicht automatisch als weitere fehlgeschlagene Nutzeranfrage. Bilden Sie den SLO-Nenner nicht aus den nach dem Sampler exportierten Spans. Die bestehende Implementierung für Burn-Rate-Alarme behandelt Ergebniszähler und Alarmvertrag. Hier geht es um die davon getrennte Aufbewahrung diagnostischer Belege.
Ein ERROR-Status im Trace ist nicht dasselbe wie ein schlechtes Nutzerergebnis. Ein interner Versuch kann scheitern, bevor ein Ersatzpfad erfolgreich ist. Eine technisch erfolgreiche Antwort kann inhaltlich falsch sein. Im Test entsprechen zehn ERROR-Kind-Spans absichtlich zehn schlechten Ergebnissen, damit der Selektionseffekt sichtbar wird. Diese Zuordnung müssen Sie in einer realen Implementierung separat herstellen.
Architektur: Trace-Zuordnung vor Aufbewahrung
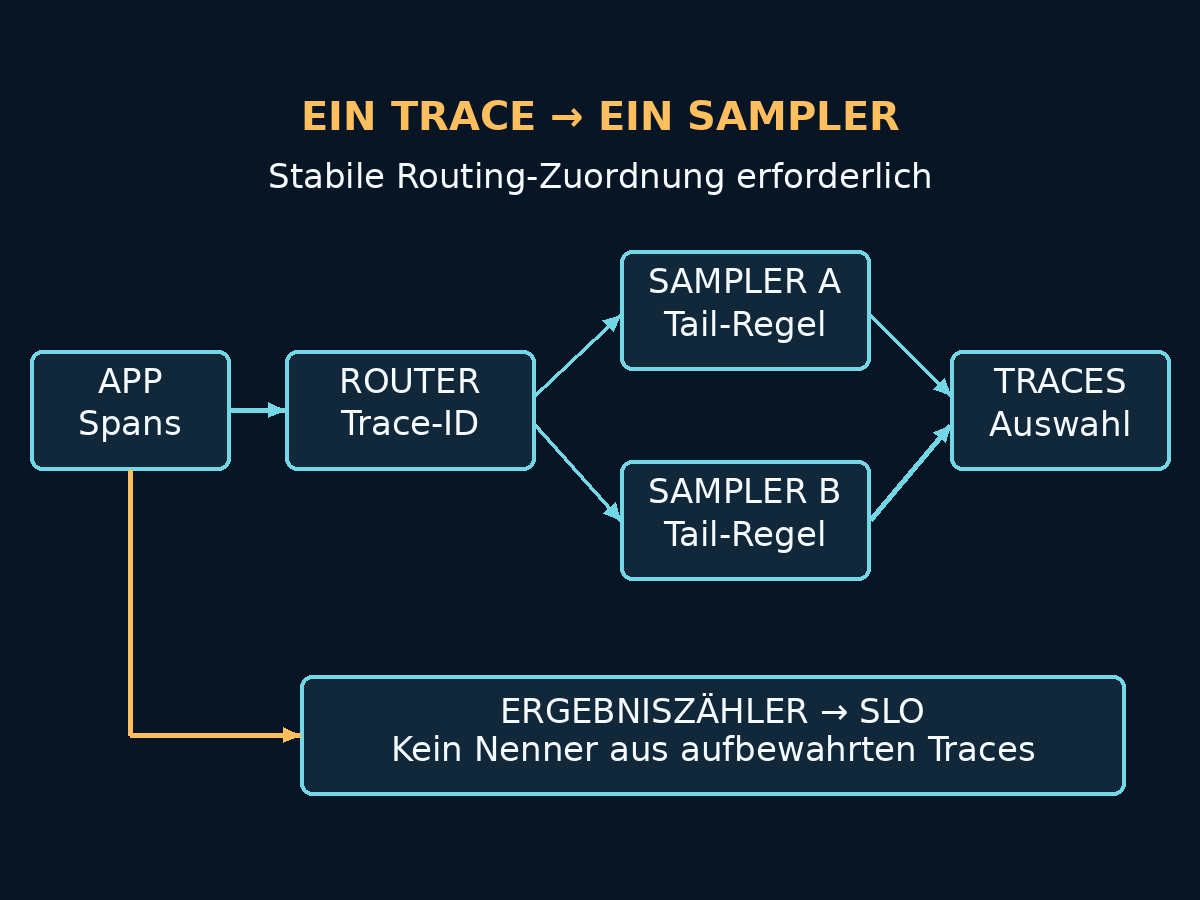
Anwendungen senden zulässige Spans an Routing-Collectors der ersten Stufe. Diese wählen über einen Trace-ID-basierten Load-Balancing-Exporter einen Sampler der zweiten Stufe. Jeder Sampler puffert seine Traces, bewertet Aufbewahrungsregeln und exportiert ausgewählte Belege. Ergebniskennzahlen laufen über einen separaten, nicht gesampelten Pfad von der Anwendung zum Metrik-Backend. „Unabhängig“ bezeichnet Instrumentierung und Nenner; gemeinsame Infrastruktur benötigt weiterhin eine Ausfallanalyse.
Die OpenTelemetry-Dokumentation zum Gateway-Muster beschreibt diesen zweistufigen Aufbau. Verwenden Sie dafür traceID statt einer Zuordnung nach Dienstnamen. Sämtliche Routing-Replikate müssen dieselben Backend-Identitäten und dieselbe Zusammensetzung kennen. Ein gewöhnlicher Round-Robin-Load-Balancer vor der Sampling-Stufe kann verschiedene Batches eines Trace auf unterschiedliche Sampler verteilen und damit die Entscheidungsgrundlage zerstören.
Diese Zuordnung gilt bei einer stabilen Routing-Sicht, nicht unbegrenzt. Laut versionsgebundener Dokumentation des Load-Balancing-Exporters ändern sich beim Wechsel der Backend-Zusammensetzung einige Trace-Zuordnungen. Konsistentes Hashing reduziert diese Bewegung, überträgt aber weder gepufferte Spans noch Entscheidungscaches. Behandeln Sie Herunterskalierung, rollierenden Austausch und DNS-Konvergenz als Ereignisse der Trace-Integrität, nicht nur der Verfügbarkeit.
Eine begrenzte, versionsgebundene Regel
Das ausführbare Beispiel verwendet Collector Contrib 0.135.0: eine bewusst festgelegte Reproduktionsversion, keine Empfehlung für eine alte Produktionsversion und keine Aussage über den aktuellen Versionsstand. Das offizielle Linux-Archiv wurde heruntergeladen, anhand der veröffentlichten SHA-256-Prüfsumme geprüft und lokal ausgeführt. Validieren Sie Regel und Abhängigkeiten vor dem Einsatz erneut mit Ihrer freigegebenen, sicherheitsgepflegten Distribution. Die zugehörige Tail-Sampling-Dokumentation definiert die folgenden Einstellungen.
Das Prozessorfragment ist JSON und kann auch als YAML-Syntax verwendet werden. Ordnen Sie es in der Collector-Konfiguration dem Schlüssel processors zu. Die drei positiven Regeln wirken hier wie eine ODER-Verknüpfung: Ein beobachteter ERROR, ein ausreichend langer Trace oder die deterministische Basisstichprobe kann einen Trace erhalten. Drop-, invertierte und zusammengesetzte Regeln sind nicht enthalten.
{"tail_sampling": {"decision_wait": "2s", "num_traces": 1000, "expected_new_traces_per_sec": 100, "decision_cache": {"sampled_cache_size": 10000, "non_sampled_cache_size": 10000}, "policies": [{"name": "errors", "type": "status_code", "status_code": {"status_codes": ["ERROR"]}}, {"name": "slow", "type": "latency", "latency": {"threshold_ms": 1000}}, {"name": "baseline", "type": "probabilistic", "probabilistic": {"sampling_percentage": 10, "hash_salt": "p49-fixture"}}]}}
Verbinden Sie für einen rein lokalen Versuch die Sampler-Pipeline über receivers: [otlp], processors: [tail_sampling], exporters: [file]. Konfigurieren Sie für den File-Exporter einen eigenen Ausgabepfad und flush_interval: 100ms. Binden Sie den OTLP-Receiver an Loopback. Die Routing-Stufe verwendet den Exporter loadbalancing, routing_key: traceID, einen statischen Resolver mit den beiden gRPC-Endpunkten der Sampler und protocol.otlp.tls.insecure: true ausschließlich für diesen isolierten Loopback-Test. Der Test deaktiviert Exporter-Warteschlangen und Wiederholungen im Router, damit Routing-Ergebnisse nicht verdeckt werden. Das ist keine Resilienzempfehlung für die Produktion. Validieren Sie jede vollständige Konfiguration vor dem Start mit otelcol-contrib validate --config <Datei>.
Die Wartezeit von zwei Sekunden ist für die Fehlerinjektion bewusst kurz. Sie beginnt beim ersten vom Sampler beobachteten Span, nicht beim Beginn der Nutzeroperation. Sie ist auch kein Inaktivitätszeitlimit, das jeder neue Kind-Span verlängert. Die Latenzregel verwendet den frühesten beobachteten Beginn und das späteste beobachtete Ende; sie misst nicht unmittelbar jeden anwendungsspezifischen Nutzerlatenzvertrag. Unvollständige Spans und abweichende Uhren können deshalb Aufbewahrung und Interpretation verfälschen. Zeitgenaue Observability bleibt eine Voraussetzung.
num_traces begrenzt den Trace-Puffer, nicht seine Gesamtgröße in Bytes. expected_new_traces_per_sec unterstützt die Speicherallokation und ist keine Zulassungsgrenze. Beide Entscheidungscaches sind begrenzt und deutlich größer als der Testpuffer. Sie merken sich Aufbewahrungs- und Verwerfungsentscheidungen nach der Freigabe von Span-Daten. Dieser Speicher ist jedoch kein dauerhaftes Prüfprotokoll. Ein gespeichertes Verwerfen kann einen späteren ERROR-Kind-Span entsprechend der bereits getroffenen Entscheidung verwerfen.
Deterministischer Test und Abgleich
Der Test startete drei lokale Collector-Prozesse: einen Router und zwei Sampler. Synthetisches OTLP/HTTP-JSON ging an den Router, der es per OTLP/gRPC an die Sampler weiterleitete. Produktionsprompts, Kundenkennungen und produktive Telemetrie-Backends waren nicht beteiligt. Die 100 Ergebnisse wurden in einem separaten Testregister gezählt. Ein produktives Metrik-Backend und ein Zählerexporter waren nicht Teil des Versuchs.
Manifest zur Reproduktion: Nummerieren Sie die Anfragen von 0 bis 99. Bilden Sie jede Trace-ID aus den ersten 32 Hexadezimalzeichen des SHA-256-Hashs der UTF-8-Zeichenfolge cohort-<Index>. Jeder Trace besitzt die Eltern-Span-ID 0000000000000001 und die Kind-Span-ID 0000000000000002. Anfragen 0–9 besitzen einen ERROR-Kind-Span; Anfragen 10–14 einen Eltern-Span von 1.500 ms bei erfolgreichem Ergebnis. Andere Eltern-Spans und sämtliche Kind-Spans dauern 10 ms. Eltern und Kinder werden mit identischen Trace-IDs in getrennten OTLP-Anfragen gesendet. Beide teilen einen synthetischen Startzeitpunkt. Das ist ein Selektionstest, kein realistisches Zeitmodell eines Dienstes.
Die erwartete Aufbewahrung wurde vor dem Vergleich der exportierten IDs berechnet: erhalten, wenn der Testfall fehlerhaft oder langsam ist oder die versionsgebundene probabilistische Auswertung besteht. Diese Version hasht das Salt p49-fixture und anschließend die 16 Bytes der Trace-ID mit FNV-1a-64 und vergleicht das Ergebnis mit der 10%-Schwelle. Dieses Implementierungsdetail ist versionsspezifisch, keine portable Sampling-Spezifikation. Eine endliche deterministische Kohorte muss unter der Basisregel nicht exakt 10% Aufbewahrung ergeben; die kombinierte Regel erhält absichtlich mehr.
Erwartete und tatsächlich aufbewahrte ID-Mengen stimmten exakt überein: 28 Traces mit jeweils beiden Spans, deren Spans jeweils nur einen Sampler erreichten. Zehn entsprachen schlechten Nutzerergebnissen im Testregister. Vergleichen Sie 10 / 100 = 10% mit 10 / 28 ≈ 35,7%. Obwohl jede absichtlich fehlgeschlagene Anfrage dieser abgeschlossenen Kohorte erhalten blieb, ersetzt der Stichprobenanteil den Anfrage-SLI nicht. Sampling liegt hinter Anwendungsinstrumentierung und Netztransport; das Ergebnis belegt nicht, dass jeder Produktionsfehler den Sampler erreichen würde.
Entscheidungstabelle: Was die Fehlertests überstand
| Fall | Erwartete Aufbewahrungsgrenze | Lokal beobachtetes Ergebnis | Betriebsentscheidung |
|---|---|---|---|
| Vollständige Kohorte, stabile Zusammensetzung | Fehler, langsame Traces oder Treffer der Basisregel | 28 von 100 Traces; exakte ID-Übereinstimmung; zwei Spans je erhaltenem Trace | Zur Diagnose nutzen; unabhängigen Nenner von 100 Anfragen behalten |
| ERROR-Kind innerhalb der Wartezeit | Eltern- und Fehler-Span können dieselbe Entscheidung beeinflussen | Zwei Spans nach 0,3 Sekunden Verzögerung erhalten | Ankunftsverteilung vor Wahl der produktiven Wartezeit messen |
| ERROR-Kind nach gespeichertem Verwerfen | Neue Belege öffnen die Entscheidung nicht erneut | Kein Span erhalten, wenn das Kind nach der Entscheidung eintraf | Verspätung überwachen; keine vollständige Fehleraufbewahrung versprechen |
| Sampler vor Entscheidung beendet | Elternzustand im Speicher liegt außerhalb der Exporter-Dauerhaftigkeit | Nur der spätere ERROR-Kind-Span überstand den Neustart | Span-Vollständigkeit prüfen, nicht nur das Vorhandensein der Trace-ID |
| Router-Zusammensetzung von A nach B geändert | Konsistentes Routing überträgt keinen vorhandenen Zustand | Eltern-Span auf A verworfen; ERROR-Kind auf B erhalten | Änderungen und Entleerung mit laufenden Traces testen |
Die Tests mit verzögerten Kindern verwendeten Trace-IDs, die die Basisregel nicht erfüllen. Damit konnte eine zufällige Aufbewahrung durch die Basisstichprobe das Ergebnis nicht verdecken. Das frühe Kind kam nach 0,3 Sekunden, das späte nach fünf Sekunden und damit in diesem Lauf sicher nach dem zweisekündigen Entscheidungsfenster. Der Neustarttest beendete Sampler A vor der Entscheidung und übermittelte den ERROR-Kind-Span nach dessen Neustart. Der Topologietest änderte die statische Backend-Liste des Routers zwischen Eltern- und Kind-Span von ausschließlich A auf ausschließlich B. Er zeigt Zustandsfragmentierung bei einem absichtlichen Austausch, nicht die zeitlichen Eigenschaften der Kubernetes-Erkennung oder eines produktiven rollierenden Updates.
Kapazität, Neustarts und lange KI-Abläufe
Bemessen Sie ausstehenden Zustand anhand der Ankunftsrate je Sampler und des Entscheidungsfensters. Prüfen Sie anschließend Lastspitzen, Trace-Größe und ungleiche Verteilung. Ein Trace mit vielen Werkzeugaufrufen kann wesentlich mehr Speicher benötigen als eine kurze Zustandsabfrage. Ein höheres decision_wait schafft mehr Zeit für verspätete Belege, erhöht aber Aufbewahrungslatenz und ausstehenden Zustand. Ein höheres num_traces ohne gemessenes Speicherbudget verschiebt lediglich die Ausfallgrenze.
Ein Exporter-WAL schützt Arbeit, die seine Warteschlange erreicht hat. Es persistiert nicht automatisch Spans, die noch auf eine Tail-Entscheidung warten. Der Beitrag zu Telemetry-Backpressure behandelt diese nachgelagerte Warteschlangengrenze. Die aktuelle Upstream-Dokumentation beschreibt außerdem experimentelle Tail-Storage-Unterstützung hinter einem Feature-Gate. Dieser Test hat sie weder konfiguriert noch geprüft. Leiten Sie Neustartfestigkeit nicht stillschweigend aus einer neueren README-Datei oder einer persistenten Exporter-Warteschlange ab.
Lange KI-Aufgaben benötigen eine eigene Entscheidung zum Trace-Zuschnitt. Ein minutenlanger Workflow kann ein praktikables Sampling-Fenster überschreiten, insbesondere bei schrittweise eintreffenden Spans. Prüfen Sie begrenzte Operations-Traces mit Span-Links oder einen ausdrücklich geregelten Belegstrom für wichtige Lebenszyklusereignisse. Das verändert traceübergreifende Regelsemantik und Suchbarkeit. Es ist kein kostenloser Ersatz für einen vollständigen verteilten Trace und kein Nachweis erfüllter Dokumentationspflichten.
Head-Sampling bildet eine weitere vorgelagerte Grenze. Zeichnet das SDK einen Span nicht auf oder exportiert es ihn nicht, kann der nachgelagerte Tail-Sampler ihn nicht rekonstruieren. Eine hybride Regel kann Telemetriekapazität schützen. „Alle Fehler erhalten“ bezeichnet dann jedoch nur Fehler, die im verbleibenden Eingang und Entscheidungsfenster sichtbar sind. Entfernen oder redigieren Sie sensible Prompt- und Antwortinhalte, bevor sie die vertrauenswürdige Erfassungsgrenze verlassen, nicht erst nach der Tail-Entscheidung.
Freigabecheckliste und Grenzen
Verlangen Sie vor der Produktionsfreigabe: einen verantworteten Nutzerergebnisvertrag; einen getrennten Metrikpfad mit Prüfungen für Zählerneustarts und fehlende Reihen; Trace-ID-Zuordnungstests über Routing-Replikate; eine gemessene Verteilung der Span-Ankunftszeiten; begrenzte Trace-, Cache- und Byte-Budgets; gezielte Neustart- und Topologieprüfungen; einen Abgleich von Aufbewahrung und Vollständigkeit anhand synthetischer IDs; geprüfte Redigierung; sowie eine zurücksetzbare Collector-Konfiguration.
Überwachen Sie Sampler-Pufferdruck, vorzeitige Verdrängungen, verspätete Spans, Regelfehler, angenommene und zurückgewiesene Telemetrie sowie Exportfehler. Prüfen Sie die Metriknamen für Ihre tatsächlich eingesetzte Version. Erhalten Sie die Beobachtbarkeit des Samplers über einen Pfad, der auch bei einem ausgefallenen Trace-Backend nützlich bleibt. Keine aufbewahrten Fehler können einen gesunden Dienst, verlorene Telemetrie, vorgelagertes Head-Verwerfen oder eine bereits gespeicherte Tail-Entscheidung bedeuten. Machen Sie daraus nicht pauschal einen grünen SLO.
Dieser lokale Versuch prüfte keine Durchsatzgrenzen, Speichererschöpfung, Exporter-Persistenz, experimentellen Tail-Storage, SDK-Head-Sampling oder Benachrichtigungszustellung. Er belegte das beschriebene Selektions- und Fragmentierungsverhalten für synthetische Eingaben auf einer festgelegten Binärversion. Die Betriebsempfehlung ist enger als „Tail-Sampling ist zuverlässig“: Trennen Sie den Zuverlässigkeitsnenner von diagnostischer Aufbewahrung und machen Sie Belegverlust beobachtbar.
Wenn Sie das Sampling-Budget Ihrer KI-Plattform festlegen, bringen Sie eine Nutzerergebnisdefinition, ein redigiertes Inventar Ihrer Trace-Strukturen und die Collector-Topologie in eine Architekturprüfung ein. Ich unterstütze Sie dabei, daraus eine versionierte Aufbewahrungsregel, ausführbare Fehlertests und eine Kapazitätsentscheidung abzuleiten, ohne eine interessantere Trace-Stichprobe als Beweis für höhere oder niedrigere Dienstzuverlässigkeit zu behandeln.