Eine Robustheitsquote ist erst dann ein belastbarer Freigabenachweis, wenn der Bericht erklärt, wer was innerhalb welcher Grenzen verändern darf und welche Beispiele in den Nenner eingehen. Legen Sie diesen Prüfvertrag vor dem Angriffstest fest. Berichten Sie anschließend Ausgangsgenauigkeit, Abdeckung geeigneter Beispiele, gültige Veränderungen, neu ausgelöste Fehler und Enthaltungen getrennt. Ein erfolgloser Angriff belegt nur das Ergebnis dieses Tests, nicht die Robustheit des Modells.
Dieser Beitrag entwickelt eine defensive, lokale Klassifikatorprüfung anhand eines tatsächlich ausgeführten synthetischen Tests. Er ist weder ein Angriff auf einen fremden Dienst noch ein Produktionsbenchmark oder eine Konformitätsbewertung. Im Mittelpunkt steht ein Messfehler: bereits falsche Vorhersagen als Angriffserfolge mitzuzählen oder unvollständige Prüfungen hinter einer beruhigenden Prozentzahl zu verstecken.
Beginnen Sie mit der geschützten Entscheidung
Betrachten Sie einen Inspektionsklassifikator, der ein Bauteil zur Annahme oder Prüfung weiterleitet. Das geschützte Ergebnis könnte lauten: „Ein defektes Bauteil darf nicht automatisch angenommen werden.“ Das ist präziser als Gesamtgenauigkeit. Ein ungezielter Angriff sucht irgendeine falsche Klasse; ein gezielter Angriff sucht ein bestimmtes schädliches Ergebnis. Trennen Sie diese Ziele, insbesondere wenn Fehlannahme und unnötige Zurückweisung unterschiedliche Folgen haben.
Die NIST-Taxonomie für adversariales maschinelles Lernen unterscheidet Lebenszyklusphasen, Ziele, Fähigkeiten und Wissen des Angreifers. Nutzen Sie diese Dimensionen für ein prüfbares Bedrohungsmodell. Evasion zur Inferenzzeit ist weder Trainingsdatenvergiftung noch Vertraulichkeitsverlust oder Prompt Injection. Ein Evasion-Test liefert allein keine Aussage über diese anderen Angriffsflächen.
Klären Sie Eigentum beziehungsweise ausdrückliche Berechtigung für Modell, Daten und Prüfumgebung. Fixieren Sie Datenvertrag und Herkunft der Referenzlabels vor der Variantenerzeugung; Daten-Governance und Lineage-Kontrollen bilden dafür die Grundlage. Eine Veränderung, die die wahre Klasse ändert, ist nicht allein wegen ihres kleinen numerischen Abstands ein gültiger labelerhaltender Angriff.
Arbeitsblatt für Bedrohungsmodell und Prüfstopps
Füllen Sie dieses Arbeitsblatt aus, bevor Sie das Werkzeug auswählen. Die rechte Spalte legt fest, wann ein Ergebnis zur Prüfung zurückgehalten werden muss, statt in eine Kennzahl einzugehen.
| Entscheidung | Erforderliche Festlegung | Ergebnis zurückhalten, wenn |
|---|---|---|
| Geschütztes Ergebnis | Ungezielter Fehler oder benanntes Schadensziel; Folge und Verantwortlicher | Ein harmloser Klassenwechsel als geschützter Schaden zählt |
| Angreiferzugriff | White-Box-Gradienten, Scores oder Labels; veränderbare und unveränderbare Felder | Der Test Zugriff erhält, den das Bedrohungsmodell nicht erlaubt |
| Veränderungsgrenze | Einheiten, Grenzen, Merkmalsmaske, Gültigkeitsprüfung und Labelerhalt | Ein unveränderbares Feld oder die wahre Klasse geändert wird |
| Arbeitsbudget | Gradientenschritte, Neustarts, Abfragezählung und Timeout-Regel | Fehlgeschlagene Versuche aus der Abdeckung verschwinden |
| Entscheidungsregel | Vorverarbeitung, Klassifikator, Ablehnungsschwelle und Rückfallpfad | Nur das Modell geprüft wird, der Bericht aber Systemrobustheit behauptet |
| Freigabegrenze | Schadensgrenzen je Klasse, Mindestabdeckung und benannter Prüfer | Ein besserer Durchschnitt einen unzulässigen Schaden ausgleicht |
Numerische und physikalische Grenzen sind nicht austauschbar. Eine Änderung von 0,05 nach Normalisierung kann für jedes Merkmal einer anderen Änderung in Originaleinheiten entsprechen. Dokumentieren Sie die Vorverarbeitung und prüfen Sie Grenzen im zugelassenen Koordinatenraum. Bei echten Messungen können unabhängig veränderte Merkmale zeitliche Stetigkeit, Erhaltungsbeziehungen oder Sensorkopplungen verletzen. Ein Fachexperte muss beurteilen, ob die erlaubte Menge eine plausible Manipulation oder lediglich mathematische Bequemlichkeit beschreibt.
Ausgeführter synthetischer Test mit klarer Reichweite
Der Test verwendet zwei dimensionslose latente Werte, gleichverteilt zwischen 0,1 und 0,9. Das Label ist eins, wenn ihre Summe größer als eins ist. Unabhängiges gaußsches Messrauschen mit Standardabweichung 0,025 erzeugt beobachtete Merkmale, begrenzt auf [0,1]. Das Label bleibt dem latenten Objekt zugeordnet; die Veränderung der Beobachtung etikettiert das Objekt nicht neu. Dies ist ein bewusst künstliches Messmodell, kein Nachweis für entsprechende Manipulationsmöglichkeiten an Industriesensoren.
Mit Seed 63 erzeugt das Skript 3.000 Zeilen, trainiert eine logistische Regression auf den ersten 2.000 und prüft die übrigen 1.000. Es gibt keinen trainierten Skalierer: Die Vorverarbeitung ist die Identitätsabbildung. Der Schätzer verwendet C=1, den Solver lbfgs und max_iter=1000. Ausgeführt wurde der Test mit Python 3.12.13, NumPy 2.2.6, scikit-learn 1.6.1, SciPy 1.15.3 und Adversarial Robustness Toolbox 1.20.1. Das sind fixierte Testversionen, keine Empfehlung für einen gleitenden latest-Stand.
Zunächst addiert eine nicht adversariale Vergleichsprüfung unabhängiges gleichverteiltes Rauschen zwischen −0,05 und +0,05 zu beiden beobachteten Merkmalen und begrenzt auf [0,1]. Anschließend führt ART FastGradientMethod einen ungezielten White-Box-Schritt mit L-Unendlich-Budget 0,05 auf ursprünglich korrekt klassifizierten Beispielen aus. Konfiguration: eps=0.05, eps_step=0.05, minimal=False, num_random_init=0, batch_size=128 und y=None. In dieser Konfiguration nutzt ART Modellvorhersagen als Angriffslabels; die Eignung wird separat gegen Referenzlabels bestimmt. Die ART-Angriffsdokumentation erläutert die Parameter; die fixierte Implementierung bestimmt das geprüfte Verhalten.
Das Ziel ist vollständig lokal; es gibt keine Remote-Abfragen. Die Instrumentierung erfasste innerhalb der Angriffserzeugung 959 beispielbezogene Gradientenberechnungen und 1.918 beispielbezogene Vorhersageberechnungen, einschließlich der Gradientenimplementierung des Schätzers. Gezählt werden verarbeitete Beispiele, nicht API-Anfragen. Ausgangsbewertung und abschließende Auswertung kommen hinzu. Ein Bedrohungsmodell mit ausschließlich Score- oder Labelzugriff benötigt ein eigenes Abfragebudget und eine passende Implementierung, nicht einen umbenannten White-Box-Befund.
Machen Sie den Nenner sichtbar
Die Ausgangsgenauigkeit betrug 959/1.000 beziehungsweise 95,9 %. Die übrigen 41 Beispiele waren bereits falsch und dürfen nicht als neue Angriffserfolge zählen. Alle erzeugten Kandidaten bestanden Prüfungen auf endliche Werte, den Bereich [0,1] und Merkmalsänderungen innerhalb des Budgets mit numerischer Toleranz 0,000001. Separate Validierungstests wiesen NaN, Bereichsverletzungen und übergroße Änderungen zurück. Das bestätigt den synthetischen Zahlenvertrag, nicht die physikalische Plausibilität in einer Anlage.
| Kennzahl | Gleichverteilte Störung | FGM mit einem Schritt |
|---|---|---|
| Fixierter Prüfsatz | 1.000 | 1.000 |
| Ursprünglich korrekte geeignete Beispiele | 959 | 959 |
| Bearbeitete Beispiele | 1.000 | 959 |
| Gültige Versuche auf geeigneten Beispielen | 959 | 959 |
| Ungültige Versuchskandidaten | 0 | 0 |
| Neue Fehler auf geeigneten Beispielen | 19 / 959 = 1,98 % | 188 / 959 = 19,60 % |
| Vorher und nachher korrekt | 940 / 1.000 = 94,0 % | 771 / 1.000 = 77,1 % |
| Alle nach dem Test korrekten Beispiele | 949 / 1.000 | 771 / 1.000 |
| Enthaltungen der Ausgangsregel | 0 / 1.000 | 0 / 1.000 |
Die Störungsspalte beschreibt eine bedingte Fehlerauslösungsrate, keine adversariale Erfolgsquote. Ihre Genauigkeit nach dem Test enthält ursprünglich falsche Beispiele, die korrekt geworden sind. Deshalb unterscheidet sie sich von der Anzahl der vorher und nachher korrekten Beispiele. Bei FGM blieben ursprünglich falsche Beispiele unverändert. Würden alle 229 Fehler nach dem Test als „Angriffserfolge“ gezählt, ergäben sich 22,9 % über den Gesamtbestand statt der tatsächlichen bedingten Erfolgsquote von 188/959 beziehungsweise 19,60 %.
Die empirisch verbleibende robuste Genauigkeit bezeichnet hier den Anteil, der sowohl im Ausgangszustand als auch nach dem konkreten gültigen Test korrekt ist. Sie ist keine zertifizierte Worst-Case-Genauigkeit über sämtliche erlaubten Veränderungen. Eine Suche mit einem Schritt kann Fehler übersehen. Für breitere Prüfungen bilden Sie die Vereinigung der Fehler kompatibler Angriffe auf denselben fixierten Beispielen, statt Erfolgsquoten zu mitteln. Nicht vergleichbare Budgets und Ziele bleiben getrennt.
Beispielsweise änderte sich Prüfzeile 8 von ungefähr (0,862541; 0,175712) zu (0,812541; 0,125712). Das Referenzlabel blieb eins; die Vorhersage wechselte von eins zu null. Damit lässt sich ein gezählter Fehler auf die tatsächlich erlaubte Veränderung zurückführen. Bewahren Sie erfolgreiche und erfolglose Fälle auf, nicht nur die Endquote.
Ungültige Versuche, fehlende Abdeckung und Enthaltungen
Definieren Sie die Auswertungsmasken ausdrücklich: Geeignet bedeutet, dass die Ausgangsvorhersage mit der Referenz übereinstimmt und das Beispiel im Prüfumfang liegt. Gültig bedeutet, dass der erzeugte Kandidat die Bedrohungsgrenzen einhält. Erfolg bedeutet geeignet, bearbeitet, gültig und falsch gemäß dem festgelegten Angriffsziel. Die bedingte Erfolgsquote teilt Erfolge durch gültige Versuche auf geeigneten Beispielen. Daneben stehen Abdeckung sowie ungültige und fehlende Versuche. Ist der Nenner null, lautet das Ergebnis „nicht geprüft“, nicht null Prozent Erfolg.
Bezeichnen Sie ungeprüfte oder ungültige Beispiele nicht als robust. Dieser Test hat vollständige Abdeckung der geeigneten Beispiele und keine ungültigen Versuche. Eine produktive Auswertung muss dagegen offene Fälle ausweisen und eine Freigabeaussage sperren, wenn die geforderte Abdeckung fehlt. Legen Sie den Umgang mit Timeouts, Werkzeugfehlern und ungültigen Kandidaten vorab fest. Ein schwacher Generator darf die Kennzahl nicht durch häufigeres Scheitern verbessern.
Eine zusätzliche Diagnose wandte auf die FGM-Ergebnismenge eine Schwelle von 0,6 für die maximale vorhergesagte Klassenwahrscheinlichkeit an; darunter wurden Fälle zur Prüfung weitergeleitet. Die Regel enthielt sich bei 176/1.000 Beispielen und akzeptierte dennoch 118 falsche Vorhersagen. Die Schwelle ist illustrativ und nicht kalibriert. Sie verändert Abdeckung und Prüflast, beseitigt aber keine Fehler. Gemessen wurde eine nachträgliche Entscheidungsregel, kein adaptiver Angriff auf diese Regel. Prüfen Sie vor einer Wirksamkeitsbehauptung den vollständigen abgesicherten Entscheidungspfad erneut, einschließlich gezielter Fehlannahmen mit hoher Modellkonfidenz und der Folgen einer überlasteten Prüfstelle.
Binden Sie den Nachweis an die Freigabe
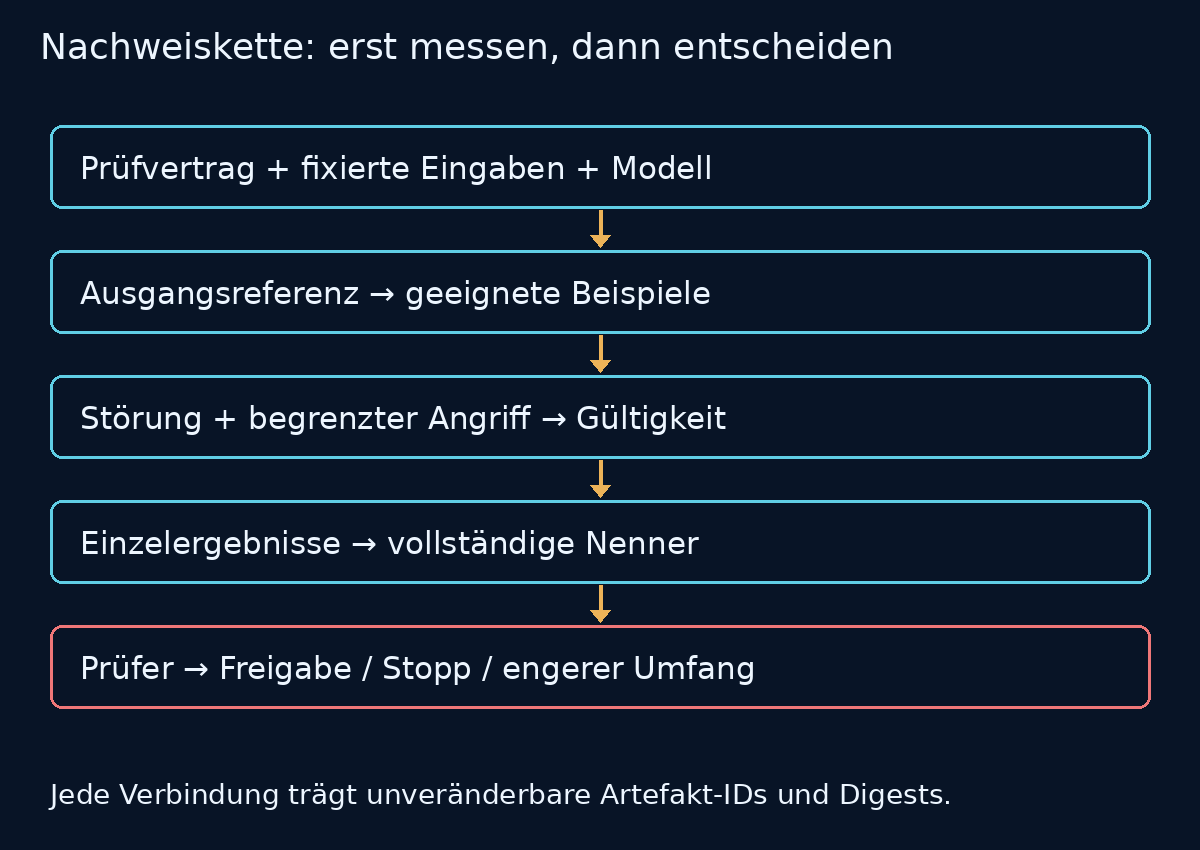
Die Grafik trennt Messpfad und Freigabeentscheidung. Ein Manifest sollte die Revision des Bedrohungsmodells, Daten- und Label-Digests, Vorverarbeitung, Modell-Digest, Seeds, Paket-Lockdatei, Angriffsparameter, Arbeitszähler, Gültigkeitsregeln und Einzelergebnisse enthalten. Der Lauf muss auch nach Änderungen im Modellregister oder an Paketvoreinstellungen zuordenbar bleiben. Verknüpfen Sie das Paket mit technischer Dokumentation und Logging, nicht mit einem unversionierten Dashboard-Screenshot.
Der ausgeführte Test bewahrte SHA-256-Digests für Modell, Eingaben und Skript sowie Fehlerbeispiele auf. Eine Reproduktion muss dieselben Daten erzeugen, Digests vergleichen und die Nennerprüfungen erneut ausführen. Ändert ein Bibliotheksupdate die Ergebnisse, erhalten Sie beide Läufe und untersuchen Sie die Differenz, bevor Sie die Referenz ersetzen. Ein Hash belegt Artefaktidentität, nicht korrekte Labels oder ein realistisches Bedrohungsmodell.
Was Artikel 15 regelt und dieser Test nicht belegt
Der von der Kommission bereitgestellte Wortlaut von Artikel 15 behandelt Genauigkeit, Robustheit und Cybersicherheit von Hochrisiko-KI-Systemen. Dazu gehören Widerstandsfähigkeit gegen Fehler sowie, soweit angemessen, Maßnahmen gegen KI-spezifische Angriffe wie Evasion und Datenvergiftung. Auch Konsistenz über den Lebenszyklus und die Angabe relevanter Genauigkeitsmetriken werden angesprochen. Daraus ergeben sich technische Nachweisfragen, aber weder ein universell vorgeschriebener FGM-Test noch eine allgemeine Bestehensquote.
Die verlinkte Service-Desk-Seite gibt ausdrücklich die ursprüngliche Amtsblattfassung wieder. Sie bestätigt nicht die aktuell anwendbare konsolidierte Rechtslage. Qualifizierter Rechtsbeistand muss Einstufung, Anbieter- beziehungsweise Betreiberpflichten, aktuelle Änderungen, Anwendungszeitpunkte und Konformitätsfolgen für das konkrete System prüfen. Dieser Beitrag ist technische Orientierung, keine Rechtsberatung, Zertifizierung oder Behauptung, dass ein einzelner Benchmark Artikel 15 erfüllt.
Freigabecheckliste und betriebliche Zielkonflikte
Prüfschritt 1: Genehmigen Sie geschütztes Ergebnis, Zugriffsmodell, veränderbare Fläche und physikalische Begründung vor dem Test. Prüfschritt 2: Fixieren Sie Referenzlabels, Modell und Vorverarbeitung. Prüfschritt 3: Führen Sie einfache Störungstests aus, validieren Sie Kandidaten und gleichen Sie jedes geeignete Beispiel ab. Prüfschritt 4: Bewerten Sie schädliche Fehler nach Klasse und Folge. Prüfschritt 5: Prüfen Sie Gegenmaßnahmen mit einer adaptiven Auswertung und messen Sie Qualitätsverlust im Normalbetrieb, zusätzliche Latenz und Prüfkapazität. Prüfschritt 6: Dokumentieren Sie den Prüfer und offene Grenzen in der Freigabeentscheidung.
Stärkere Suchverfahren benötigen mehr Rechenzeit und Wartung; Ablehnungsregeln binden menschliche Kapazität; adversariales Training kann Normalgenauigkeit gegen getestete Robustheit eintauschen. Der obige Test beantwortet diese Kostenfragen nicht. Vergleichen Sie gepaarte Läufe unter demselben Prüfvertrag und verwenden Sie nicht kompensierbare Freigabegrenzen: Ein günstigeres Modell oder bessere Durchschnittsgenauigkeit darf einen Verstoß gegen das geschützte Ergebnis nicht ausgleichen.
Eine gezielte Implementierungsprüfung kann aus einem vorhandenen Klassifikatorbericht ein reproduzierbares Bedrohungsmodell, eine vollständige Nennerrechnung und eine Freigaberegel machen. Bringen Sie die aktuelle Entscheidungsregel, einen autorisierten Prüfsatz und einen fehlgeschlagenen oder strittigen Testbericht mit. Das nützliche Ergebnis ist eine nachvollziehbare Entscheidung darüber, was ungeprüft bleibt, nicht eine weitere isolierte Robustheitsquote.