Eine wiederhergestellte Workflow-Datenbank ist noch kein wiederhergestellter Geschäftsprozess. Stellen Sie Checkpoints in einer isolierten Umgebung wieder her, halten Sie ausgehende Aktionen gesperrt und gleichen Sie jede möglicherweise bereits ausgeführte Operation mit dem Zielsystem ab. PostgreSQL kann lokale Datensätze zurücksetzen, aber keinen bereits erteilten Auftrag, keine Freigabe und kein extern angelegtes Ticket. Ein Restore-Test besteht erst, wenn er sowohl wiederherstellbaren Zustand als auch kontrollierte Geschäftsaktionen nachweist.
Der Fehler: Ihr Checkpoint ist älter als die Außenwelt
Betrachten Sie einen beispielhaften Wartungsworkflow. Zum Zeitpunkt T0 enthält das Backup einen freigegebenen Auftrag, aber kein abgeschlossenes Ticket. Bei T1 legt der Workflow das Ticket im externen Dienst an. Bei T2 geht der Checkpoint verloren, der diesen Erfolg dokumentiert. Nach Wiederherstellung von T0 erscheint der Auftrag erneut ausführbar. Wenn Sie den Worker ohne Abgleich starten, kann ein zweites Ticket entstehen – auch bei einem vollständig konsistenten Backup.
Das ist eine Disaster-Recovery-Grenze und nicht lediglich eine weitere Retry-Regel. Retry-Budgets begrenzen Versuche während der Ausführung. Ein historischer Restore kann zusätzlich lokale Nachweise über Versuche, Freigaben, Stornierungen und Deduplizierungsentscheidungen entfernen. Auch ein auf denselben alten Stand zurückgesetztes Operationsjournal belegt nur die damalige Absicht, nicht die Abwesenheit späterer Aktionen.
Die Architekturfrage lautet: Welches System kann verbindlich bestätigen, ob die beabsichtigte Geschäftsaktion bereits stattgefunden hat? Ist diese Auskunft nicht verfügbar, lautet der sichere Zustand „ungeklärt“, nicht „zur erneuten Ausführung bereit“.
Definieren Sie den Wiederherstellungsumfang vor dem Backup-Verfahren
Inventarisieren Sie Workflow-Datenbank, Anwendungsdaten, Operationsjournal, persistente Queue, langfristigen Agentenspeicher, Artefaktmanifeste und externe Ziele. Dokumentieren Sie jeweils Verantwortung, Sicherungsverfahren, Wiederherstellungspunkt, Versionskompatibilität und maßgebliche Abgleichquelle. Trennen Sie Daten zur Interpretation der Historie von Zugangsdaten, mit denen diese Historie versehentlich erneut ausgeführt werden könnte.
Die LangGraph-Dokumentation zur Persistenz unterscheidet Graph-Checkpoints eines Threads von Stores für anwendungsdefinierte Daten über mehrere Threads hinweg. Der Restore des Checkpointers allein belegt nicht, dass zugehöriger Store, Retrieval-Daten und Werkzeugschema zusammenpassen. Ein Checkpointer im Arbeitsspeicher ist kein Sicherungsmechanismus. Wählen Sie Persistenz passend zur tatsächlich abzusichernden Ausfallgrenze.
Halten Sie Graph-Code, Abhängigkeiten der Checkpoint-Serialisierung, Datenbankschema sowie Modell- und Konfigurationsmanifest identifizierbar. Das LLM-Release-Bundle adressiert reproduzierbare Artefakte; hier wird es zur Voraussetzung für die Zustandswiederherstellung. Alten Zustand ohne Kompatibilitätstest in neuen Code einzuspielen, ist eine Migration und kein transparenter Neustart. Eine frühere Revision eines gehosteten Modells kann nicht mehr verfügbar sein. Die identische Neugenerierung einer alten Antwort dürfen Sie deshalb nicht voraussetzen.
Auch Datenbankkonsistenz hat einen begrenzten Geltungsbereich. Unabhängige Datenbanken, Objektspeicher und externe APIs erhalten keinen gemeinsamen Wiederherstellungspunkt, nur weil ihre Backup-Anzeigen grün sind. Koordinieren Sie ihre Grenzen oder entwickeln Sie einen ausdrücklichen Abgleich für Abweichungen. Der Architekturvergleich für die Orchestrierung hilft bei der Zuordnung: Welche Schicht besitzt Zustand, und welches Backend muss Aktionskontrollen durchsetzen?
SQL-Dump oder Basissicherung mit WAL?
Die PostgreSQL-Dokumentation zu SQL-Dumps beschreibt pg_dump als intern konsistenten Snapshot zum Beginn des Dumps. Er umfasst eine Datenbank; Rollen und Tablespaces müssen Sie gesondert berücksichtigen. Selbst pg_dumpall synchronisiert nicht die Snapshots aller Datenbanken. Ein Dump ist sinnvoll, wenn Wiederherstellungspunkt und Restore-Dauer Ihre Ziele erfüllen. Als Grundlage für WAL-Replay eignet er sich nicht.
Kontinuierliche Archivierung und Point-in-Time Recovery kombinieren eine physische Basissicherung mit der erforderlichen Folge archivierter WAL-Dateien. Damit lässt sich ein ausgewählter Punkt auf einer wiederherstellbaren Timeline erreichen. Fehlende erforderliche Segmente, eine unbrauchbare Basissicherung oder inkompatible Serverversionen können diesen Weg ungültig machen. Änderungen an Konfigurationsdateien wie postgresql.conf und pg_hba.conf werden nicht über WAL wiederhergestellt. Sichern Sie die relevante Konfiguration separat.
| Wiederherstellungsweg | Wiederhergestellter Umfang | Zentrale Voraussetzung | Kein Nachweis für |
|---|---|---|---|
| Konsistenter SQL-Dump | Snapshot einer Datenbank | Vollständiger Dump, Rollen und getesteter Restore | Systemübergreifende Konsistenz oder Rücknahme externer Aktionen |
| Basissicherung mit archiviertem WAL | Datenbankcluster am erreichbaren Zielpunkt | Kompatible physische Sicherung und erforderliche WAL-Kette | Lokale Kenntnis aller bestätigten externen Effekte |
| Workflow-Checkpoints und Store | Thread-Zustand und gemeinsame Anwendungsdaten | Kompatibler Graph, Serialisierung und Speichergrenze | Sichere erneute Ausführung von Geschäftsaktionen |
| Abgeglichene Operationsnachweise | Entscheidung über jede unklare Aktion | Maßgeblicher Zielstatus und stabile Identität | Allgemeine Exactly-once-Ausführung |
Physische Wiederherstellung erfordert gewöhnlich engere Serverversionskompatibilität als logische Dumps. Binden Sie Ihr Verfahren an die tatsächliche PostgreSQL-Hauptversion und das eingesetzte Backup-Werkzeug. Die Quellen belegen die Sicherungsmechanismen. Die Freigabekriterien dieses Artikels sind technische Empfehlungen, keine Datenbankgarantien.
Zeitachse: Lokaler Restore nimmt externe Effekte nicht zurück
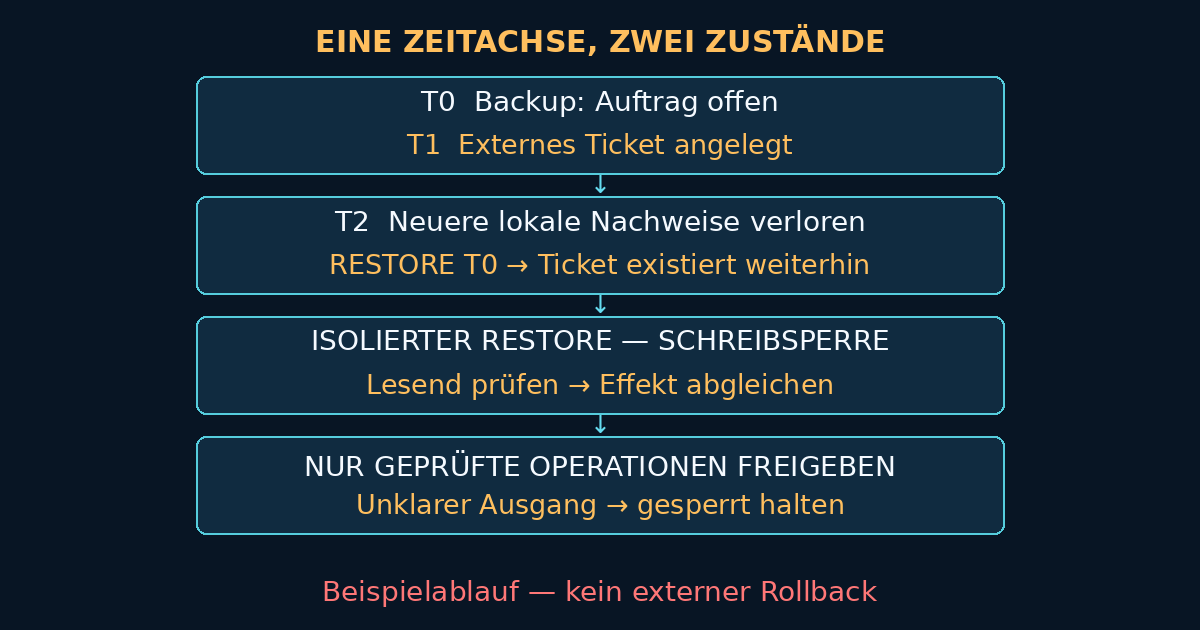
Die Grafik zeigt eine beispielhafte Abfolge, keinen gemessenen Vorfall. T0 ist der wiederhergestellte lokale Stand, T1 die externe Festschreibung und T2 der Verlust neuerer lokaler Nachweise. Die Restore-Umgebung bleibt isoliert, während ein ausschließlich lesender Abgleichpfad das Zielsystem prüft. Nur eine geprüfte Teilmenge darf in einen separat autorisierten Fortsetzungspfad gelangen.
Führen Sie einen isolierten Restore-Test durch
1. Szenario und Zeitmessung festlegen. Benennen Sie simulierten Ausfallzeitpunkt, angestrebten Wiederherstellungspunkt, betroffene Workflows und fachliche Abnahmekriterien. Legen Sie fest, ob das Wiederherstellungszeitziel auch Abgleich und Freigabe umfasst. Beenden Sie die Messung erst bei sicher nutzbarem Geschäftsbetrieb, nicht schon bei erfolgreicher Datenbankverbindung. Dokumentieren Sie Datenbankstand und fehlende Geschäftsergebnisse getrennt.
2. Vor dem Restore isolieren. Stellen Sie eine getrennte Netzwerk- und Identitätsgrenze bereit, die ausgehende Verbindungen standardmäßig verweigert. Stoppen Sie Worker, Scheduler, Queue-Consumer und eingehende Trigger. Binden Sie keine produktiven Schreibzugangsdaten ein. Prüfen Sie alternative Wege über Proxys, SDK-Endpunkte, E-Mail, Webhooks und Message-Broker. Eine Einstellung in der wiederhergestellten Datenbank reicht nicht als Sperre: Der Restore kann sie überschreiben.
3. Isolation mit harmlosem Test nachweisen. Versuchen Sie aus der Worker-Identität heraus einen kontrollierten Aufruf an ein eigens eingerichtetes Testziel und bestätigen Sie dessen Blockierung. Bewahren Sie Richtlinien- und Netzwerknachweise auf. Auch ein Sandbox-Endpunkt kann echte Benachrichtigungen auslösen oder Kosten verursachen, wenn Kontogrenzen falsch gesetzt sind. Prüfen Sie daher Zielmandant und URL.
4. Wiederherstellen und Integrität prüfen. Validieren Sie Backup-Kennung, Datenbankziel und Werkzeugversion vor der Ausführung. Lassen Sie einen logischen Restore bei Fehlern abbrechen und prüfen Sie den Exit-Status, statt ein teilweise wiederhergestelltes Schema zu akzeptieren. Belegen Sie bei PITR, dass die Wiederherstellung das beabsichtigte Ziel auf der richtigen Timeline erreicht und dort angehalten hat. Prüfen Sie Tabellen, Anwendungsinvarianten und Checkpoint-Dekodierung mit der festgelegten Laufzeit, ohne aktionsfähige Worker zu starten.
5. Unklare Operationen vollständig erfassen. Berücksichtigen Sie zum wiederhergestellten Zeitpunkt offene Aktionen, bekannte spätere Geschäftsereignisse, erneute Broker-Zustellungen und Arbeit, die möglicherweise erst nach dem Backup entstanden ist. Eine Abfrage ausschließlich wiederhergestellter offener Zeilen übersieht die letzte Kategorie. Sichern Sie verfügbare neuere Nachweise vor destruktiver Wiederherstellung. Ziehen Sie bei Bedarf Zielsystemhistorie oder einen kontrollierten Änderungsexport hinzu.
6. Über separaten Leseadapter abgleichen. Vergleichen Sie Mandant, fachliche Operationskennung, externe Objektkennung und Eingabe-Fingerprint. Dokumentieren Sie maßgeblichen Zustand, Beobachtungszeit und Nachweisreferenz. Ein veraltetes Replikat oder ein Suchtreffer-Ausfall bei verzögerter Konsistenz belegt keine Abwesenheit. Kann das Zielsystem den Ausgang nicht klären, sperren Sie die Operation für eine verantwortliche Prüfung.
7. Selektiv freigeben und beobachten. Halten Sie freigegebene Operationsmenge und aktuelle Wiederherstellungsgeneration außerhalb des veralteten Restore-Zustands fest. Deaktivieren Sie alte Worker und Queue-Consumer, bevor Sie die neue Gruppe aktivieren. Erzwingen Sie Generations- oder Fencing-Prüfungen an der Aktionsgrenze, damit eine alte Lease keine Schreibberechtigung zurückerlangt. Aktivieren Sie nur erforderliche Ziele, Zugangsdaten und Last. Stoppen Sie bei unerwarteten Effekten.
Entscheidungstabelle für den Abgleich
| Wiederhergestellter Zustand | Nachweis im Zielsystem | Fortsetzungsentscheidung | Erforderliche Kontrolle |
|---|---|---|---|
| Offene Aktion | Genau passender Effekt ist festgeschrieben | Abgeglichenen Abschluss erfassen; Anlage überspringen | Stabile Identität und geprüfte Ergebniszuordnung |
| Offene Aktion | Maßgebliche Quelle bestätigt Abwesenheit | Neu autorisierten Versuch erwägen | Aktuelle Freigabe, gültige Eingabe und Sicherheitsvertrag des Ziels |
| Offene Aktion | Timeout, veraltete Suche oder unklarer Status | Für Abgleich zurückhalten | Keine automatische Wiederholung bei unklarem Ausgang |
| Abgeschlossene Aktion | Externes Objekt wurde geändert oder storniert | Aktuelle fachliche Absicht prüfen | Alte Freigabe darf spätere Stornierung nicht ersetzen |
| Keine lokale Operation | Neuere Zielhistorie belegt einen Effekt | Nachweise vor Einplanung rekonstruieren | Arbeit nach dem Backup berücksichtigen |
| Beliebige Aktion | Deduplizierungsfrist oder Eingabeidentität weicht ab | Automatische Wiederverwendung stoppen | Empfängervertrag prüfen; Unklarheiten eskalieren |
Ändern Sie nicht unbedacht interne Checkpoint-Tabellen des Frameworks, um Arbeit als abgeschlossen zu markieren. Verwenden Sie unterstützte Zustands-APIs oder eine geprüfte Migration, die Graph-Invarianten erhält. Testen Sie anschließend den nächsten Übergang. Abschluss ist eine fachliche Aussage mit Zielsystemnachweis und nicht bloß ein bequemer Statuswert.
Idempotenz reduziert doppelte Effekte nur innerhalb der dokumentierten Semantik des Empfängers. Erhalten Sie die ursprüngliche fachliche Aktionsidentität. Erzeugen Sie nicht allein wegen einer neuen Wiederherstellungsgeneration einen neuen Schlüssel. Die Generationskennung für Fencing bleibt davon getrennt. Hat der Empfänger seinen Deduplizierungseintrag bereits gelöscht, kann er einen alten Schlüssel als neu behandeln. Übersteigt der Restore-Horizont diese Aufbewahrungsfrist, muss der Abgleich die Sicherheit begründen.
Messen Sie den Test und provozieren Sie schwierige Fälle
Dokumentieren Sie den tatsächlich wiederhergestellten Datenbankpunkt und das Intervall fehlender lokaler Nachweise. Vergleichen Sie dies mit dem vereinbarten Wiederherstellungspunktziel. Zählen Sie bekannte externe Effekte, abgeglichene Operationen, ungeklärte Ausgänge und fehlende Geschäftsereignisse separat. Auch ein kleines Datenverlustfenster kann eine teure doppelte Aktion enthalten. Eine einzige Kennzahl beschreibt nicht beide Risiken.
Zerlegen Sie die Wiederherstellungszeit in Bereitstellung, Daten-Restore, Anwendungsprüfung, Abgleich und kontrollierte Freigabe. Messen Sie den gesamten Weg gegen das Wiederherstellungszeitziel und bewahren Sie die Abschnittsdauern zur Engpassanalyse auf. Der Abgleich kann dominieren, obwohl die Datenbank schnell wiederhergestellt ist. Aus der Wahl von PostgreSQL oder LangGraph folgt kein allgemeingültiges Zeitziel.
Testen Sie ein fehlendes erforderliches WAL-Segment, inkompatible Checkpoints, eine extern abgeschlossene Aktion ohne erhaltene Bestätigung, abgelaufene Deduplizierung, einen wiederanlaufenden alten Consumer und eine erst nach dem Backup angelegte Operation. Erwarten Sie explizite Blockierung oder kontrollierten Abgleich statt stillen Fortschritts. Verwenden Sie Zielsystem-Stubs oder isolierte Mandanten, die Versuche und Effekte unabhängig zählen. Client-Logs allein beweisen keine Duplikatfreiheit.
Die Freigabecheckliste ist konkret: Isolation getestet; Backup und Ziel identifiziert; Schema und Checkpoint-Dekodierung geprüft; unklare Operationen erfasst; Entscheidung für jede fortgesetzte Aktion vorhanden; ungeklärte Aktionen weiterhin gesperrt; alte Schreiber ausgeschlossen; aktuelle Autorisierung geprüft; Monitoring und Stoppfunktion bereit. Bewahren Sie Runbook, Umgebungsmanifest, Restore-Logs, Abgleichentscheidungen und abgezeichnete Freigabe gemeinsam auf.
Grenzen, Datenschutz und der nächste Umsetzungsschritt
Ein isolierter Test kostet Infrastruktur, Betriebszeit und Integrationsaufwand. Lesender Abgleich kann an API-Limits scheitern, historische Lücken aufweisen oder einen ebenfalls ausgefallenen Anbieter benötigen. Konservatives Zurückhalten schützt vor Duplikaten, verzögert aber berechtigte Arbeit. Ein unabhängiges Journal hilft nur, wenn Aufbewahrung, Integrität und Ausfallgrenze den Vorfall überstehen. Es ist nicht automatisch die maßgebliche Quelle für einen externen Commit.
Ein Restore kann zuvor gelöschte Daten oder entzogene Zugriffe wieder einführen. Wenden Sie aktuelle Aufbewahrungs-, Lösch- und Zugriffsentscheidungen an, bevor Sie wiederhergestellte Daten freigeben oder Workflows verbinden. Beteiligen Sie Datenschutz, Sicherheit und qualifizierte Rechtsberatung, sofern entsprechende Pflichten betroffen sind. Dieser Artikel bietet technische Betriebshinweise und keine Rechtsberatung.
Bringen Sie für die nächste Architekturprüfung einen zustandsbehafteten Workflow, sein Backup-Inventar und den Vertrag einer API mit Seiteneffekten mit. Ich unterstütze Sie dabei, daraus eine dokumentierte Wiederherstellungsgrenze, einen Abgleichadapter und ein Abnahmekriterium für Restore-Tests zu entwickeln. Der relevante Nachweis ist, dass Ihr System wiederhergestellt werden kann, ohne die Geschäftsaktionen von gestern blind zu wiederholen – nicht eine weitere grüne Backup-Meldung.