BLUF — KV-Zustand mit geringerer Präzision ist ein Kapazitätsexperiment, kein kostenloser Geschwindigkeitsschalter. Halten Sie Modellgewichte konstant, fixieren Sie Attention-Backend und Skalierungsverfahren und akzeptieren Sie FP8 nur, wenn mehr nutzbare Anfragen dieselben Qualitäts- und Latenzanforderungen erfüllen. Verschlechtern sich Langkontextbelege oder Zahlenextraktion, sind zusätzlich zugelassene Sequenzen keine nutzbare Kapazität.
Dieser Leitfaden liefert ein Versuchsmanifest, eine Entscheidungstabelle und einen ausführbaren synthetischen Belegtest. Er enthält keine GPU-Benchmark-Ergebnisse. Der Test prüft die Auswertungslogik; er beweist nicht, dass ein bestimmtes Modell oder ein Beschleuniger seine Genauigkeit behält. Ausgangspunkt ist das SLO-Modell für selbst betriebene Inferenz, nicht allein die Geräteauslastung.
Gewichte, laufenden Zustand und reservierten Speicher trennen
Gewichte sind die persistenten Modellparameter. Der KV-Zustand enthält Schlüssel und Werte der für Attention gehaltenen Tokens. Gewichtspräzision und KV-Präzision betreffen unterschiedliche Teile des Speicherbudgets. Bei konventioneller vollständiger Attention benötigen mehr gehaltene Tokens und gleichzeitige Sequenzen mehr Zustand; Grouped-Query Attention, gleitende Fenster und alternative Attention-Architekturen verändern diese Rechnung.
Für einen vereinfachten homogenen Decoder mit vollständiger Attention ergeben sich die ungeshardeten KV-Nutzdatenbytes aus 2 × Schichten × KV-Heads × Head-Dimension × gehaltene Tokenpositionen × Bytes je Element. Der erste Faktor zählt Schlüssel und Werte. Summieren Sie die gehaltenen Positionen über Sequenzen und berücksichtigen Sie gemeinsam verwendete Blöcke gesondert. Skalierungsmetadaten, Blockrundung, Allokatoraufwand, temporäre Aktivierungen und replizierter Zustand fehlen in dieser Näherung. Übertragen Sie die Formel nicht unverändert auf Latent-Attention- oder Hybridmodelle.
Der Wechsel von einem Zwei-Byte- zu einem Ein-Byte-KV-Element halbiert diesen Nutzdatenterm, nicht den gesamten GPU-Speicher, nicht den Parameterspeicher und nicht zwingend die Latenz. Engines können einen ähnlich großen Speicherpool reservieren und darin mehr Tokens unterbringen. Berichten Sie deshalb sowohl belegten Gerätespeicher als auch nutzbare KV-Block- beziehungsweise Tokenkapazität. Eine unveränderte Speicheranzeige widerlegt keinen Kapazitätsgewinn.
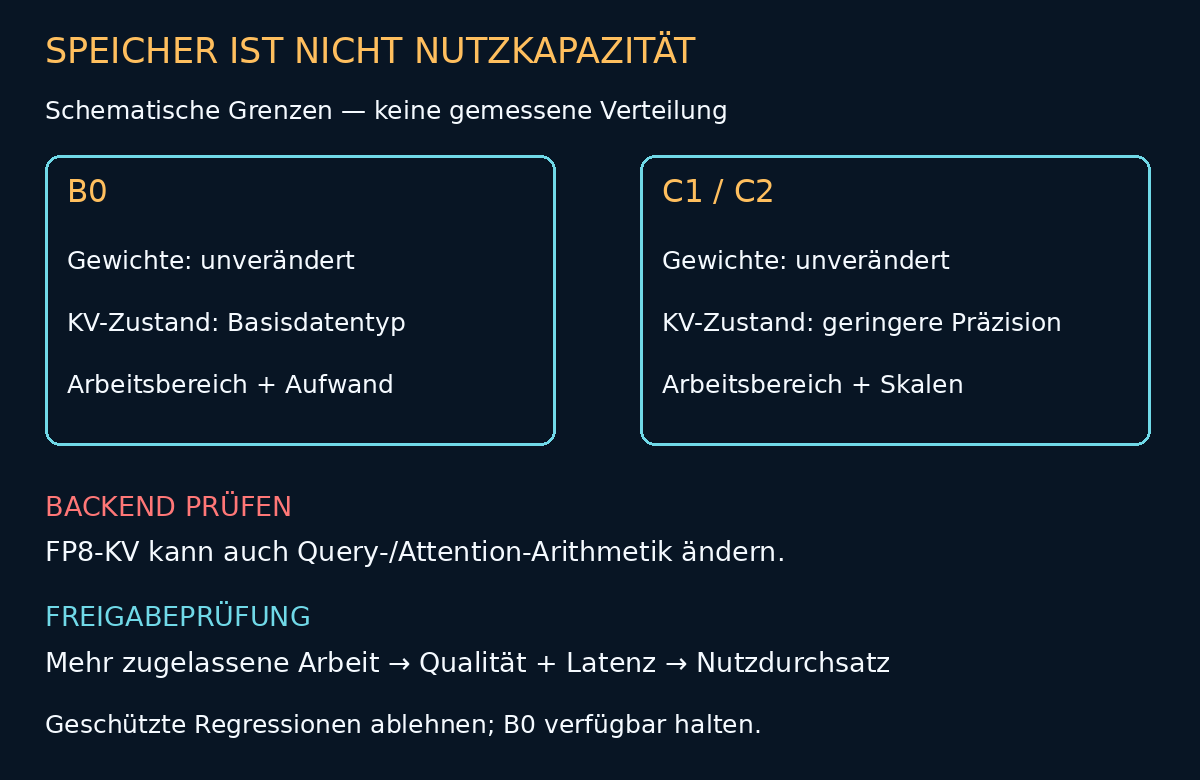
Lesen Sie die Grafik als Modell der Speichergrenzen, nicht als gemessene Speicherverteilung. Gewichte bleiben unverändert; der Kandidat verändert die Darstellung des Attention-Zustands. Der gewonnene Raum muss weiterhin Zulassungs-, Latenz- und Antwortprüfungen bestehen.
Der Eingriff kann Attention-Arithmetik einschließen
Die vLLM-Dokumentation zum quantisierten Cache erklärt ausdrücklich, dass Flash Attention 3 mit FP8-KV-Cache auch Attention-Operationen im quantisierten Bereich ausführt und Queries quantisiert. Dies als reinen Speicherversuch zu bezeichnen, würde eine relevante numerische Änderung verschweigen. Dokumentieren Sie das beim Start tatsächlich ausgewählte Backend, nicht nur die angeforderte Einstellung.
Die Dokumentation beschreibt Standardskalen von 1.0 und Datensatzkalibrierung über llm-compressor, einschließlich Strategien je Attention-Head mit Backend-Einschränkungen. Diese Fähigkeiten sind versionsabhängig. Die verlinkte latest-Dokumentation ist eine Entwicklervorschau: Prüfen Sie Flags, unterstützte Schichttypen und tatsächlich geladene Skalen anhand der eingesetzten Version, Startprotokolle und Hilfeausgabe. Ein nicht unterstützter Kandidat ist eine ungültige Versuchszelle, kein negatives Qualitätsergebnis.
Die technische vLLM-Analyse berichtet über Korrekturen der Kernel-Akkumulation, von der Head-Dimension abhängiges Prefill-Verhalten und Ausnahmen für Hybridschichten. Ihre Messungen gelten für die dortigen Modelle, Kernel und Beschleuniger, nicht für Ihren Endpunkt. Auch die Kalibrierungsempfehlung garantiert keine Verbesserung jedes zurückgehaltenen Prüfsegments. Bewerten Sie kalibrierte und unkalibrierte Varianten getrennt.
Übertragen Sie keine fremde Bibliotheks-API. Die Transformers-Dokumentation zu Cache-Strategien beschreibt QuantizedCache und warnt vor schlechterer Latenz bei kurzen Kontexten und ausreichend Speicher. Die Einstellung cache_implementation ist kein vLLM-Deployment-Flag. Übertragbar ist der Zielkonflikt zwischen Speicher und Latenz, nicht eine austauschbare Konfiguration.
Vor dem Präzisionswechsel ein Manifest fixieren
Erstellen Sie eine unveränderliche Baseline B0 mit Image-Digest, vLLM-Version oder Commit, Attention-Kernel-Revision, GPU-Modell und -Anzahl, Treiber- und Runtime-Versionen, Modellrevision, Tokenizer-Revision und Digest des Chat-Templates. Erfassen Sie Gewichtsdatentyp und Quantisierungsverfahren auch dann, wenn sie unverändert bleiben. Vergleichen Sie bei einem Modellverzeichnis mit neuen Skalierungsmetadaten die ursprünglichen Tensoren, damit keine versteckte Gewichtsänderung in den Versuch gelangt.
Ergänzen Sie KV-Datentyp, ausgelassene Schichten, Skalengranularität, Skalenquelle, Digest des Kalibrierungsartefakts, effektives Backend und Query-/Attention-Präzision. Halten Sie fest, ob Standard-, Checkpoint- oder zur Laufzeit bestimmte Skalen tatsächlich geladen wurden; ein Dateiname beweist das nicht. Unterstützt die Version eine Skalenberechnung zur Laufzeit, behandeln Sie diese als eigene Variante statt als identisch zur Offline-Kalibrierung.
Fixieren Sie Tensorparallelität, Kontextlimit, Speicherbudget, Scheduler-Grenzen, Prefix-Cache-Regeln, Speculative Decoding, Decoding-Parameter, Abbruchregeln und Ausgabelimit. Erfassen Sie auch tatsächliche Ausgabelängen: Eine kürzere Antwort kann schneller und zugleich weniger nützlich sein. Trennen Sie Kalibrierungs- und Evaluationsdaten mit unveränderlichen Manifesten und Deduplizierungsregeln. Berücksichtigen Sie repräsentative Sprachen und Langkontextstrukturen in der Kalibrierung, ohne geschützte Prüfantworten offenzulegen.
Ein minimales maschinenlesbares Manifest verwendet baseline_id, candidate_id, image_digest, model_revision, tokenizer_revision, weights_digest, attention_backend, kernel_revision, gpu_inventory, kv_dtype, scale_granularity, scale_artifact_sha256, calibration_corpus_sha256, evaluation_corpus_sha256, skipped_layers, effective_args, trace_sha256 und evaluator_revision. Speichern Sie Messwerte getrennt und lassen Sie sie bis zur tatsächlichen Ausführung weg. Ein fehlender TTFT-Wert ist keine Latenz von null.
Entscheidungstabelle für Baseline und Kandidaten
| Versuchszelle | Konstant halten | Erforderliche Belege | Entscheidung |
|---|---|---|---|
| B0 freigegebene Präzision | Vollständiges Produktionsmanifest | Qualität und SLOs je Klasse | Als Rückfallziel erhalten |
| C1 unterstütztes FP8 mit Standardskalen | Gewichte, Anfragen und Scheduler | Effektive Skalen; Langkontext- und Zahlenfehler | Bei Verletzung geschützter Segmente ablehnen |
| C2 unterstütztes kalibriertes FP8 | Gleiche zurückgehaltene Prüfung und Last | Kalibrierungsherkunft; tatsächlich geladene Skalen | Nur bei ausreichender Qualität und Nutzdurchsatz freigeben |
| C3 unterstützte Schichtausnahmen | Gleiches Modell und gleicher Lastverlauf | Geänderte Schichten; Speicher und Latenz | Als eigenen Eingriff behandeln |
| Nicht unterstütztes Backend oder Skalenverfahren | Keine Ersatz-Runtime | Kompatibilitätsnachweis fehlt | Ungültig markieren; kein Ergebnis erfinden |
Die Tabelle definiert Versuche, keine Benchmark-Ergebnisse. Wechseln Sie zwischen C1 und C2 nicht unbemerkt den Kernel und schreiben Sie jede Änderung der Kalibrierung zu. Ist eine Kopplung unvermeidbar, benennen Sie den vollständigen Eingriff und vergleichen Sie Deployment-Pakete statt einen kausalen reinen Cache-Effekt zu behaupten.
Gepaarte Qualitätsprüfungen vor dem Lastversuch
Senden Sie zunächst dieselben freigegebenen Prompts an B0 und jeden kompatiblen Kandidaten. Segmentieren Sie nach kurzer, mittlerer und langer tokenisierter Eingabe, tatsächlicher Ausgabelänge, Deutsch und Englisch, Belegposition und numerischem Aufgabentyp. Platzieren Sie den benötigten Fakt am Anfang, in der Mitte und am Ende; ergänzen Sie Ablenkungsdaten mit ähnlichen Kennungen und Fälle ohne vorhandene Antwort. Verwenden Sie den fixierten Tokenizer: Wiederholte Zeichen sind keine verlässliche Kontextlängenmessung.
Ein reproduzierbarer synthetischer Test kann den Datensatz „Asset AX-104; revision B; nominal torque 12.5 N.m“ zwischen fremden Datensätzen platzieren und asset, revision, nominal_torque und unit als JSON-Objekt abfragen. Erwartet wird das Tupel AX-104, B, 12.5, N.m. Lehnen Sie eine falsche Revision, einen Faktor-zehn-Fehler, eine falsche Einheit sowie fehlende oder zusätzliche Felder ab. Ergänzen Sie eine Anfrage zu einer nicht vorhandenen Anlage, deren freigegebene Antwort eine Ablehnung statt eines erfundenen Werts ist. Dies sind erfundene Testdaten, keine Wartungsanweisung.
Der begleitende Test wurde lokal ausgeführt, um die Annahme korrekter Antworten und die Ablehnung injizierter Fehler zu prüfen. Er hat kein LLM aufgerufen. Ein bestandener Selbsttest belegt nur diese Prüfungen; führen Sie den Modellvergleich in einer isolierten Serving-Umgebung aus, bevor Sie Kapazitätsaussagen treffen. Erweitern Sie die Prüfung um dokumentübergreifende Belege, beleggestütztes Schlussfolgern und Geschäftsregeln. Prüfen Sie gepaarte Abweichungen. Ablehnungen, fehlerhafte Ausgaben und Zeitüberschreitungen bleiben im Nenner.
Nutzbare Kapazität statt zugelassener Parallelität messen
Vergleichen Sie Varianten zunächst mit demselben angebotenen Ankunftsverlauf und freigegebenen Zulassungslimit. Variieren Sie danach angebotene Last und Zulassungsgrenzen getrennt, um den Betriebsbereich jedes Kandidaten zu bestimmen. Ein geschlossener Parallelitätstest diagnostiziert Sättigung, kann aber wachsende Warteschlangen verbergen: Langsame Antworten reduzieren neue Anfragen. Verwenden Sie zusätzlich einen offenen Lastverlauf mit geplanter Ankunft, tatsächlichem Versand und clientseitiger Verzögerung.
Erfassen Sie je Kontextlängenklasse angebotene und abgeschlossene Anfragen, akzeptierte Antworten, Fristverletzungen, Wartezeit, TTFT, Inter-Token- und Ende-zu-Ende-Latenz. Trennen Sie Engine-Tokenzeitpunkte von Abständen zwischen Netzwerk-Streaming-Blöcken. Erfassen Sie belegten Speicher, effektive KV-Kapazität, wartende Anfragen und Preemption-Zählerdifferenzen mit Neustartgrenzen. Prüfen Sie das bereitgestellte Metrikschema, bevor Sie Namen auswählen oder Engine-weite Zähler einzelnen Klassen zuordnen.
Definieren Sie Nutzdurchsatz als Antworten, die sowohl Aufgabenprüfung als auch Klassen-SLO erfüllen, geteilt durch ein festes Beobachtungsintervall. Ordnen Sie die Kohorte anhand der Ankunft im Intervall zu, wenden Sie eine vorab festgelegte Abschlussfrist an und halten Sie unerledigte Arbeit sichtbar. Abgewiesene und fehlgeschlagene Anfragen zählen zur angebotenen Nachfrage und zu Betriebskosten. Berichten Sie Fallzahlen und Wiederholungsstreuung; eine Gesamtverbesserung kann Langkontextverluste verdecken.
Randomisieren Sie die Reihenfolge, wiederholen Sie Läufe und trennen Sie Engine-Aufwärmung von Prefix-Cache-Aufwärmung. Halten Sie Wiederverwendungsregeln im Präzisionsvergleich konstant; untersuchen Sie realistische Wiederverwendung getrennt mit dem Prefix-Caching-Versuch. Mehr residente Sequenzen können Wartezeiten oder Preemptions erhöhen. Wird Rechenleistung zum Engpass, rechtfertigt Speicherersparnis allein keine höhere Zulassung.
Checkliste für Freigabe und Rückkehr zur Baseline
Prüfung 1 — Kompatibilität: Das fixierte Image lädt vorgesehenes Modell, Backend, Skalen und Schichtausnahmen. Archivieren Sie effektive Konfiguration und Startbelege. Stille Rückfallmechanismen oder unbekannte Skalenherkunft sind nicht akzeptabel.
Prüfung 2 — Qualität: Verantwortliche legen absolute Qualitätsuntergrenzen und erlaubte gepaarte Regressionen vor der Ergebnisprüfung fest. Jedes geschützte Sprach-, Langkontext- und Zahlensegment muss bestehen. Reicht die Stichprobe nicht für eine belastbare Entscheidung, sammeln Sie weitere Belege statt Gleichwertigkeit zu behaupten.
Prüfung 3 — Betrieb: Fordern Sie vereinbarte TTFT-, Streaming-, Fehler- und Abschlussgrenzen bei der Ziellast. Dokumentieren Sie Kosten je akzeptierter SLO-konformer Antwort einschließlich Wiederholungen. Reservieren Sie Baseline-Kapazität: Ein kleinerer KV-Zustand garantiert nicht, dass die Rückkehr zum größeren Zustand mit dem Zulassungslimit des Kandidaten funktioniert.
Prüfung 4 — Wiederherstellung: Begrenzen Sie den Canary-Verkehr, leiten Sie neue Anfragen bei Grenzverletzung zur Baseline und lassen Sie bestehende Streams nur bis zur festgelegten Frist auslaufen. Reduzieren Sie nötigenfalls die Zulassung vor der Wiederherstellung des größeren Caches. Erproben Sie Neustart, Cache-Verlust und Aufwärmung; rekonstruieren Sie das freigegebene Manifest nicht erst während eines Vorfalls.
Den nächsten Versuch aus dem Fehler ableiten
Dominieren Gewichte, verwenden Sie die getrennten Qualitätsprüfungen für Gewichtsquantisierung und Adapter. Ist KV-Zustand der Engpass, aber geschützte Antworten verschlechtern sich, untersuchen Sie Skalen, numerisches Backend-Verhalten und unterstützte Schichtausnahmen, bevor Sie den scheinbaren Parallelitätsgewinn nutzen. Bleibt Qualität stabil, ohne dass der Nutzdurchsatz steigt, behalten Sie die einfachere Baseline.
Bringen Sie für eine Inferenz-Architekturprüfung das unveränderliche Serving-Manifest, einen bereinigten Ankunftsverlauf, repräsentative zurückgehaltene Anfragen und Abnahmegrenzen je Klasse mit. Das sinnvolle Ergebnis ist eine geprüfte Entscheidung für Beibehaltung, Kalibrierung oder Rückkehr zur Baseline — kein Versprechen, dass FP8 Ihre Serving-Kapazität verdoppelt.