Eine RAG-Pipeline kann keine Beziehung finden, die bereits bei der Datenaufnahme verloren gegangen ist. Prüfen Sie vor einem Wechsel des Embedding-Modells, ob jeder wichtige PDF-Wert weiterhin zur richtigen Zeile, Überschrift, Einheit, Bedingung und Dokumentrevision gehört. Bewahren Sie die strukturierte Extraktion als Beleg auf; leiten Sie den Suchtext erst nach einer Abnahmeprüfung daraus ab. Sind Struktur oder Herkunft ungeklärt, sperren Sie die betroffenen Belege für die Suche, statt das Sprachmodell die Zuordnung rekonstruieren zu lassen.
Hier geht es um die Parsergrenze, nicht um einen weiteren Vergleich von Chunk-Größen. Ein Suchtreffer kann die richtige Teilenummer und sämtliche Zahlen einer Tabelle enthalten und trotzdem eine falsche Antwort stützen. Flüssige Sprache und hohe Ähnlichkeitswerte beweisen nicht, dass „12,5“ weiterhin das Nenndrehmoment und nicht das maximale Drehmoment bezeichnet.
Der Vertrag beschreibt Beziehungen, nicht Wortmengen
Definieren Sie für technische Tabellen eine Belegeinheit aus Dokumentidentität und Revision, Tabellenidentität, Zeilenschlüssel, hierarchischer Spaltenüberschrift, Rohwert, Einheit und zutreffender Fußnote. Speichern Sie Seitenverweise und verfügbare Quellkoordinaten zusätzlich. Erhalten Sie die Ausdehnung verbundener Zellen und unterscheiden Sie leere Zellen, fehlende Extraktion und ausdrücklich „nicht zutreffend“. Keiner dieser Zustände darf stillschweigend zu null werden oder einen Nachbarwert übernehmen.
Die DoclingDocument-Repräsentation unterstützt Tabellen, Hierarchie, Provenienz und verfügbare Layoutinformationen. Ihr Dokumentbaum bildet die Lesereihenfolge ab. Das sind geeignete Bausteine, aber keine Zusicherung korrekter Tabellenerkennung. Ein Begrenzungsrahmen für die gesamte Tabelle ist nicht automatisch ein geprüfter Rahmen für jeden einzelnen Wert. Kennzeichnen Sie die tatsächlich vorhandene Granularität.
Verwenden Sie neben der fachlichen Revision einen stabilen Dokumenthash. Die Revision bezeichnet die gültige Handbuchfassung; der Hash identifiziert die verarbeiteten Bytes. Halten Sie Parserkonfiguration, Paket- und Modellrevisionen, OCR-Sprachen und Extraktionszeitpunkt in einem Manifest fest. Eine geänderte Parser- oder Modellversion erzeugt einen neuen Extraktionskandidaten, keine Erlaubnis zum stillschweigenden Überschreiben freigegebener Belege.
Ein ausgeführter Test mit bewusst enger Aussagekraft
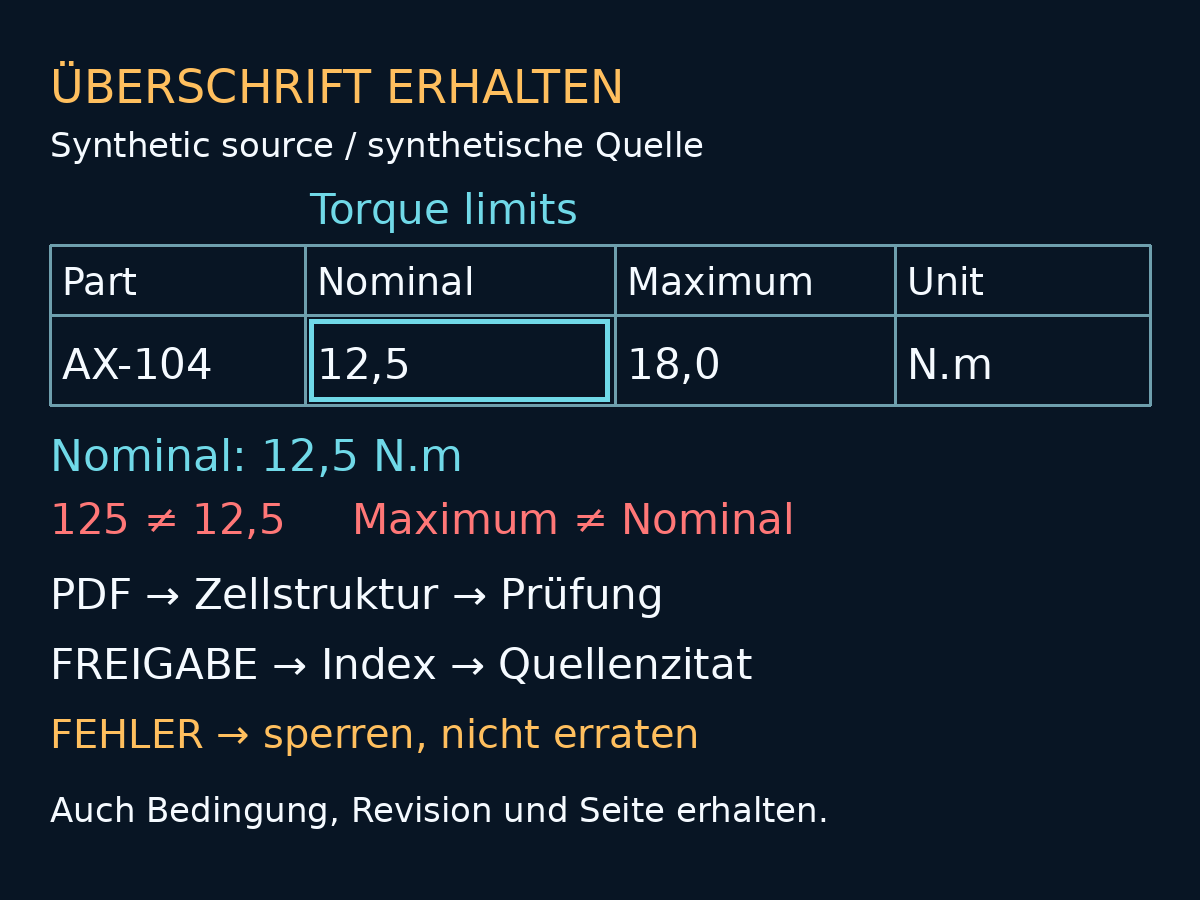
Für diesen Artikel wurde mit ReportLab 5.0.1 ein zweiseitiges PDF mit Textebene erzeugt und mit PyMuPDF 1.28.2 gelesen. Es enthält die verbundene Gruppenüberschrift „Torque limits“ über „Nominal“ und „Maximum“, eine separate Einheitenspalte, wiederholte Überschriften auf der Fortsetzungsseite und eine Fußnote. Alle Kennungen und Werte sind synthetisch und ausdrücklich keine Wartungsanweisung.
Die erste Seite enthält AX-104, Nennwert 12,5, Maximum 18,0, Einheit N.m und die Bedingung „Dry assembly only.“ Die zweite enthält BX-208, Nennwert 8,0 und Maximum 10,0 mit derselben Einheit und Bedingung. Ein ausschließlich für dieses Testdokument geschriebener Geometrieadapter extrahiert Wörter aus bekannten Zellbereichen. Geprüfte Zuordnungen für Überschriften, Fortsetzung und Fußnote werden explizit vorgegeben; der Adapter erkennt sie nicht selbstständig. Diese Einschränkung ist beabsichtigt: Der Test prüft den Abnahmevertrag, nicht allgemeine Tabellenerkennung.
Vier erwartete numerische Tupel bestanden die Prüfung. Sechs getrennte Mutationen wurden jeweils zurückgewiesen: falsche Einheit, entfernter Dezimaltrenner, falsche Überschrift, fehlende Fußnote, falsche Revision und fehlender Begrenzungsrahmen. Das sind deterministische Validatorprüfungen, weder sechs beobachtete Parserfehler noch eine gemessene Genauigkeitsrate. Docling-Konvertierung, OCR, Modellinferenz und Tokenüberlauf wurden in diesem Test nicht ausgeführt. Dafür benötigen Sie zusätzliche Durchläufe mit Ihren Dokumentfamilien.
Die tatsächlich extrahierte, abgeflachte Textfassung der ersten Seite enthält weiterhin alle Wörter, aber keine expliziten Zellbeziehungen: „Torque limits Part Nominal Maximum Unit Note AX-104 12,5 18,0 N.m * * Dry assembly only.“ In diesem Beispiel ging keine Ziffer verloren. Verloren ging die explizite Zuordnung, die ein nachgelagerter Verbraucher sonst erschließen muss.
| Darstellung | Wert und Kontext | Bedeutung für die Abnahme |
|---|---|---|
| Quelltabelle, Seite 1 | AX-104; Nominal unter Torque limits; 12,5; N.m; nur trockene Montage | Geprüfte Sollbeziehung |
| Abgeflachter Text | Überschriften, danach AX-104 12,5 18,0 N.m | Wörter vorhanden; Beziehungen implizit |
| Überschriftenbezogener Beleg | AX-104; Torque limits / Nominal = 12,5 N.m; nur trockene Montage; Revision B; Seite 1 | Beziehung explizit und rückverfolgbar |
| Injizierte Dezimalmutation | Gleiches Tupel, aber Rohwert 125 | Zurückweisen: ursprünglicher Wert verändert |
| Injizierte Überschriftenmutation | Gleicher Wert unter Torque limits / Maximum | Zurückweisen: Bedeutung verschoben |
Das Quell-PDF, Seitenbilder, extrahierte Tupel, Mutationsergebnisse und das ausführbare Skript wurden mit den Publikationsbelegen gespeichert. Der SHA-256-Hash des PDF lautet 6fdccb50dee86538395cbe129e8a1e601be9fa379ba9faeb4225909ae4c2f79d. Der Test zeigt, dass ein kleiner Prüfvertrag absichtlich eingebaute Fehler erkennt. Er belegt keine Extraktionsqualität im Produktionsbetrieb.
Strukturierte Belege vor dem Suchtext erhalten
Das Docling-Projekt dokumentiert PDF-Layout, Tabellenstruktur, OCR, lokale Ausführung und verlustfreien JSON-Export. Nutzen Sie den strukturierten Dokumentexport als vorgelagerten Datensatz, statt ausschließlich Markdown aufzubewahren. Halten Sie das Original-PDF unter derselben Zugriffsrichtlinie vor. Lokale Verarbeitung ersetzt keine Vorgaben für Dokumentverarbeitung, Aufbewahrung oder freizugebende Modelldownloads.
Implementieren Sie einen Adapter vom festgeschriebenen Extraktionsschema auf Ihr Belegschema. Verarbeiten Sie Tabellenzellen mit ihren Zeilen- und Spaltenausdehnungen, lösen Sie den vollständigen Überschriftenpfad auf und verknüpfen Sie Zeilenkennungen, Einheitenzellen und Fußnotenmarker. Validieren Sie diese Zuordnungen anhand geprüfter Beispiele. Liefert der Parser keine brauchbaren Zellkoordinaten, erhalten Sie Tabellen- und Seitenprovenienz und kennzeichnen Sie den fehlenden Zellbeleg. Wenden Sie die Prüfregel des Anwendungsfalls an, statt Koordinaten zu erfinden.
Ein geeigneter Suchtext für das Testdokument lautet: „Dokument fixture-A, Revision B. Tabelle T1. Teil AX-104. Torque limits / Nominal: 12,5 N.m. Bedingung: nur trockene Montage.“ Der getrennte Metadatensatz hält Dokumenthash, Seite 1, Tabelle T1, Zeile 0, Spalte 1 und den extrahierten Begrenzungsrahmen fest. Diese Zeilen- und Spaltenindizes sind Adapterkoordinaten, keine über Parserwechsel hinweg unveränderlichen Quellidentitäten.
Der gemessene PyMuPDF-Wortrahmen für 12,5 lag ungefähr bei (161,00; 157,10; 184,35; 173,59) in Seitenkoordinaten mit Ursprung links oben. Dokumentieren Sie Ursprung, Seitengröße, Maßeinheit und Rotation für die Übertragung in einen Dokumentbetrachter. Unterstellen Sie nicht, dass andere Bibliotheken dieselbe Konvention verwenden. Prüfen Sie bei gedrehten oder gescannten Seiten die tatsächliche Überlagerung auf dem Seitenbild.
Behandeln Sie die Suchtextserialisierung als neu erzeugbare Ansicht freigegebener Belege. Die Zitatauflösung sollte Originalseite und relevante Tabelle oder Zelle anzeigen, nicht lediglich einen Dokumenttitel. Zugriffsprüfungen müssen für Belegspeicher, abgeleitete Chunks und Quellansicht gleichermaßen gelten. Auch eine sachlich richtige Zelle aus einem nicht freigegebenen Handbuch ist eine unzulässige Antwortgrundlage.
Fortsetzungen und Fußnoten ausdrücklich zuordnen
Wiederholte Seitenüberschriften sind keine zusätzlichen Datenzeilen. Umgekehrt beweisen identische Überschriften auf benachbarten Seiten nicht, dass dieselbe Tabelle fortgesetzt wird. Kombinieren Sie Tabellenkennungen, Beschriftungen, kompatible Spalten und geprüfte Fortsetzungsregeln. Erhalten Sie die Provenienz jeder beteiligten Seite. Verteilt sich eine Zeile auf mehrere Seiten, speichern Sie mehrere Quellbereiche; erzeugen Sie keinen fiktiven gemeinsamen Begrenzungsrahmen.
Verbundene Überschriften brauchen Pfade, nicht nur ein zusammengezogenes Etikett. „Nominal“ unter Drehmoment und „Nominal“ unter Druck bezeichnen unterschiedliche Felder. Erhalten Sie die Gruppenüberschrift und unterscheiden Sie eine tatsächlich verbundene Einheitenzelle von einer leeren. Fußnoten können eine Zeile, eine Spalte oder die gesamte Tabelle einschränken. Ein Stern ohne aufgelöste Bedingung ist ein unvollständiger Beleg, selbst wenn das numerische Tupel plausibel erscheint.
Bewahren Sie bei Dezimalkommas den ursprünglichen Text und einen getrennt normalisierten Wert mit festgelegter Gebietsschemaregel auf. Entfernen Sie Satzzeichen nicht pauschal: Aus 12,5 wird sonst 125. OCR-Verwechslungen, Minuszeichen, Hochstellungen und Einheitenpräfixe benötigen geprüfte Testfälle. Konfidenzwerte können die manuelle Prüfung priorisieren, ersetzen aber keinen Vergleich mit der Quelle.
Eine Abnahmeentscheidung vor den Vektorindex setzen
Die folgende Richtlinie ist ein vorgeschlagenes Engineering-Gate, kein Docling-Standard. Legen Sie ihre Strenge mit dem Dokumentverantwortlichen und anhand der Folgen einer falschen Antwort fest. Sperren Sie den kleinsten unabhängig nutzbaren Belegbereich. Eine fehlerhafte gemeinsame Überschrift kann die gesamte Tabelle statt einer einzelnen Zelle betreffen.
| Befund | Entscheidung | Vor Freigabe erforderlicher Beleg |
|---|---|---|
| Wert, Überschrift, Einheit und Bedingung entsprechen dem geprüften Testfall | Für nachgelagerte Evaluation annehmen | Quellidentität und auflösbare Provenienz |
| Mehrdeutige verbundene Überschrift oder Seitenfortsetzung | Prüfen; betroffene Tupel ausschließen | Freigegebene Zuordnung mit allen Quellseiten |
| Falscher Dezimaltrenner, Vorzeichen, Einheit oder Zeilenbezug | Betroffenen Beleg sperren | Korrigierte Extraktion und Regressionstest |
| Fußnotenmarker ohne aufgelöste Bedingung | Prüfen oder sperren | Quellenbelegte Bedingung und Geltungsbereich |
| Zellkoordinaten fehlen | Festgelegte Provenienzrichtlinie anwenden | Seiten- oder Tabellenverweis und explizite Granularitätsgrenze |
| Zeile überschreitet nachgelagertes Tokenbudget | Neu serialisieren oder sperren | Überschrift, Wert und Bedingung überstehen tatsächliche Tokenisierung |
Führen Sie exakte Tupelprüfungen vor Retrieval- und Antwortbewertungen aus. Vergleichen Sie Soll- und Istmengen einschließlich fehlender und unerwarteter Datensätze. Ein Gleichheitstest nur für die erste passende Zeile kann Auslassungen verdecken. Verwenden Sie Rohwertgleichheit für die Transkription und eine getrennte, geprüfte Regel für numerische Normalisierung. Bei sicherheitsrelevanten technischen Werten darf ein guter Durchschnitt keinen bestätigten Einheiten- oder Anwendbarkeitsfehler ausgleichen.
Ein minimaler Validator prüft alle erwarteten Schlüssel, übereinstimmende Datensatzanzahl und den Erhalt von Teil, Überschrift, Rohwert, Einheit, Bedingung, Seite und Revision. Anschließend prüft er Quellhash und geforderte Provenienzgranularität. Die sechs Mutationen des Testdokuments prüfen diese Ablehnungspfade. Für Produktion müssen Sie zusätzlich doppelte Zeilen, verbundene Zellen, gedrehte Seiten, Scans und Revisionen mit berechtigten Wertänderungen testen.
Überschriften verbrauchen ebenfalls Tokenbudget
Die Docling-Dokumentation zur Chunk-Erzeugung beschreibt wiederholte Tabellenüberschriften im HybridChunker. Sie dokumentiert auch omit_header_on_overflow: Ist die Option aktiviert, kann eine Überschrift für eine Zeile entfallen, die allein, aber nicht zusammen mit der Überschrift ins Budget passt. Das ist ein semantischer Kompromiss, nicht nur eine Effizienzeinstellung. Aktivieren Sie ihn nicht ohne Nachweis, dass der Beleg interpretierbar bleibt.
Zählen Sie mit dem eingesetzten Tokenizer, nachdem Überschriften, Kennungen und Bedingungen ergänzt wurden. Ist eine Zeile zu breit, zerlegen Sie sie in Belegeinheiten, die jeweils den relevanten Überschriftenpfad, Zeilenschlüssel, die Einheit und Einschränkung erhalten. Bewahren Sie Verknüpfungen für Fragen über mehrere Zellen auf. Passt keine sichere Darstellung ins Budget, leiten Sie Frage oder Dokument zur Prüfung weiter, statt stillschweigend zu kürzen. Mehr Überlappung oder ein größeres Embedding-Modell reparieren keine bereits falsche Einheitenzuordnung.
Vergleichen Sie erst danach Chunking-Strategien, untersuchen Sie die Suche nach exakten Kennungen und führen Sie das übergreifende RAG-Evaluationsgate in CI aus. Halten Sie Extraktionsrichtigkeit, Belegerhalt, Retrieval-Recall und Antwortbegründung als getrennte Ergebnisse fest.
Freigabecheckliste und betriebliche Kompromisse
Prüfen Sie vor Freigabe Originalbytes und Revision; fixieren Sie Parser- und Modellkonfiguration; prüfen Sie repräsentative Quellseiten; validieren Sie Zell-, Überschriften-, Einheiten- und Bedingungstupel; kontrollieren Sie Provenienzüberlagerungen; testen Sie Fortsetzungsregeln; messen Sie tatsächlichen Tokenerhalt; und wiederholen Sie zugriffsbewusste Retrieval- und Antworttests. Bewahren Sie die vorherige freigegebene Extraktion und das Indexmanifest für einen Rollback auf.
Strukturierte Belege kosten Speicher, Adapterpflege und Prüfzeit. Wiederholte Überschriften und Bedingungen kosten Tokens. Konservative Sperren reduzieren die unmittelbar verfügbare Dokumentabdeckung und benötigen Zuständigkeit und Bearbeitungswarteschlange. Ein kleiner Test mit Textebene repräsentiert weder schlechte Scans noch sämtliche Lieferantenlayouts. Verfolgen Sie Annahme-, Prüf- und Ablehnungszahlen je Dokumentfamilie sowie Rückstandsalter und Parserlaufzeit. Verkaufen Sie diese Betriebszahlen nicht als Antwortgenauigkeit.
Wenn Ihr Team zwischen einem neuen Embedding-Modell und einem anderen PDF-Parser entscheiden muss, beginnen Sie mit einer Handbuchfamilie und geprüften Tabellenfragen mit hohen Fehlerfolgen. Ich unterstütze Sie bei der Definition des Zellbelegvertrags, beim Aufbau der Abnahmetests und bei der Suche nach der ersten Grenze, an der Bedeutung verloren geht. Das Ergebnis sollte eine reproduzierbare Entscheidung zur Datenaufnahme sein, keine flüssige Demonstration über einer ungeprüften Tabelle.