Ein produktives RAG-System sollte nur antworten, wenn die autorisierte Evidenz aktuell, anwendbar und für die angefragte Entscheidung ausreichend ist. Retrieval-Ähnlichkeit ist nicht die Wahrscheinlichkeit einer korrekten Entscheidung. Trennen Sie die Prüfung der Beantwortbarkeit von einer nachgelagerten Prüfung der generierten Aussagen. Bewerten Sie beide Kontrollen danach, wie viele nützliche Antworten entfallen und welche Eskalationsarbeit entsteht. Ein System, das alles ablehnt, kann unbelegte Antworten vermeiden und dennoch seinen Geschäftszweck verfehlen.
Dieser Beitrag beschreibt einen Implementierungsvorschlag und einen kleinen synthetischen Testdatensatz, keine Ergebnisse aus einem Kundenbetrieb. Die Entscheidung betrifft die Laufzeitgrenze zwischen Antworten, Rückfragen und Eskalation – nicht den besten Chunker oder einen akzeptabel aussehenden durchschnittlichen Evaluationswert.
Warum der ähnlichste Abschnitt trotzdem die falsche Evidenz sein kann
Betrachten Sie eine konstruierte Frage zur Wartungsdokumentation: Welches Prüfintervall gilt für Baugruppe B unter der aktuell freigegebenen Revision? Ein fast identischer Abschnitt für Baugruppe A, eine veraltete Revision für B und ein aktueller Absatz, der B ohne Intervall erwähnt, können relevant wirken. Keiner belegt die verlangte Antwort. Ersetzen Sie fehlende kontrollierte Dokumentation nicht stillschweigend durch das Hintergrundwissen des Sprachmodells.
Die Dokumentation zur semantischen Suche von Sentence Transformers beschreibt das Einbetten von Fragen und Korpuseinträgen sowie die Suche nach ähnlichen Nachbarn. Die Funktion semantic_search verwendet standardmäßig Kosinusähnlichkeit. Das ist ein Ranking-Verfahren. Es belegt nicht, dass ein bestimmter Score die Wahrscheinlichkeit ausdrückt, sämtliche benötigten Aussagen aus autorisierten und anwendbaren Quellen beantworten zu können.
Ein Reranker kann die Relevanz verbessern, ohne diesen Unterschied aufzuheben. Erfassen Sie seinen Score und seine Modellrevision als Merkmale, nicht als universellen Konfidenz-Prozentwert. Änderungen am Embedding-Modell, Sprachmix oder Kandidatenbestand können die Score-Verteilung verändern. Auch ein präzise wirkender Schwellenwert benötigt eine Bewertung gegen ein explizit definiertes Ziel.
Definieren Sie Beantwortbarkeit vor dem Modelltraining
Ein Testfall benötigt Intent-ID, Frage, erlaubten Zugriffsumfang, Anlagen- oder Produktidentität, angefragten Gültigkeitszeitpunkt, Quellen-IDs und Revisionen, erforderliche Evidenzeinheiten, zulässige Alternativen, Label, Prüfer und Begründung. Kennzeichnen Sie ihn nur dann als beantwortbar, wenn die für diese Person verfügbare Evidenz den angefragten Umfang trägt. Unterscheiden Sie bei mehrteiligen Antworten zwischen austauschbaren Passagen und Anforderungen, die gemeinsam erfüllt sein müssen.
Führen Sie zwei Labels: Beantwortbarkeit im Korpus, durch Prüfer anhand des autorisierten Snapshots festgestellt; und ausreichende Evidenz im Kontext, beurteilt anhand dessen, was Retrieval, Reranking und Prompt-Aufbau tatsächlich übersteht. Fehlt eine verpflichtende Warnung im endgültigen Kontext, ist das ein Pipeline-Fehler, selbst wenn sie im Korpus existiert. Deklarieren Sie die Frage nicht nachträglich als unbeantwortbar, um das Retrieval besser aussehen zu lassen.
Erstellen Sie getrennte Fälle für fehlende Evidenz, Widersprüche, veraltete Inhalte, falsche Revisionen und unklare Absichten. Ein fachlicher Verantwortlicher muss Quellenautorität und Anwendbarkeit festlegen; ein neuerer Zeitstempel ersetzt nicht automatisch eine freigegebene Anweisung. Ungeklärte Konflikte müssen sichtbar bleiben, statt in einem Score zu verschwinden. Nutzen Sie die Evaluationsmethodik für Chunking-Strategien, um vorgelagerte Evidenzverluste zu beheben, statt Antwortverzicht zum dauerhaften Ersatz für gute Datenaufbereitung zu machen.
Autorisierung bleibt eine eigenständige harte Grenze. Filtern Sie vor Retrieval und Prompt-Aufbau; ein Konfidenzmodell darf eine Zugriffsverweigerung nicht überstimmen. Weder die Nutzermeldung noch ein unbeschränktes Protokoll darf die Existenz eines geschützten Dokuments offenlegen. Ein autorisierter Supportprozess kann den Zugriffskonflikt bearbeiten, erhält aber nicht automatisch geschützte Auszüge.
Entscheiden Sie über den Pfad vor der Antwortgenerierung
Die folgende Richtlinie ist ein Entwurf, kein vom Anbieter vorgeschriebener Schwellenwert. Harte Grenzen kommen vor probabilistischer Annahme. Eine Schätzung der Beantwortbarkeit darf unklare Evidenzabdeckung erst bewerten, nachdem Zugriff und Anwendbarkeit geprüft wurden.
| Beobachteter Zustand | Pfad | Erforderliche Kontrolle |
|---|---|---|
| Zugriffsumfang nicht erlaubt | Separat verweigern | Allgemeine Meldung; keine geschützten Quellen offenlegen |
| Notwendige Kennung fehlt in der Frage | Rückfrage | Kennung erfragen, ohne geheime Werte vorzuschlagen |
| Erforderliche Evidenz fehlt | Eskalation oder Einschränkung erklären | Fehlenden Evidenztyp benennen, keine Antwort erfinden |
| Revision veraltet oder Quellen widersprüchlich | Eskalation | Quellenverantwortlicher klärt Gültigkeit und Autorität |
| Evidenz besteht die Vollständigkeitsprüfung | Antwortkandidat erzeugen | Nur freigegebene Evidenz verwenden; Belege erhalten |
| Generierte Aussagen bestehen Belegprüfung nicht | Zurückhalten und eskalieren | Verworfenen Kandidaten nicht als Antwort ausgeben |
Eine Rückfrage passt, wenn die anfragende Person eine Unklarheit auflösen kann. Umformulieren ersetzt keine fehlende Handbuchrevision. Eine Eskalation braucht Verantwortliche, Reaktionsziel und begrenzte Warteschlange; sonst ist „menschliche Prüfung“ eine nicht implementierte Abhängigkeit. Ist die Warteschlange nicht verfügbar, geben Sie eine ehrliche Einschränkung mit zulässigem nächsten Schritt aus – keinen stillen Wechsel zu „immer antworten“.
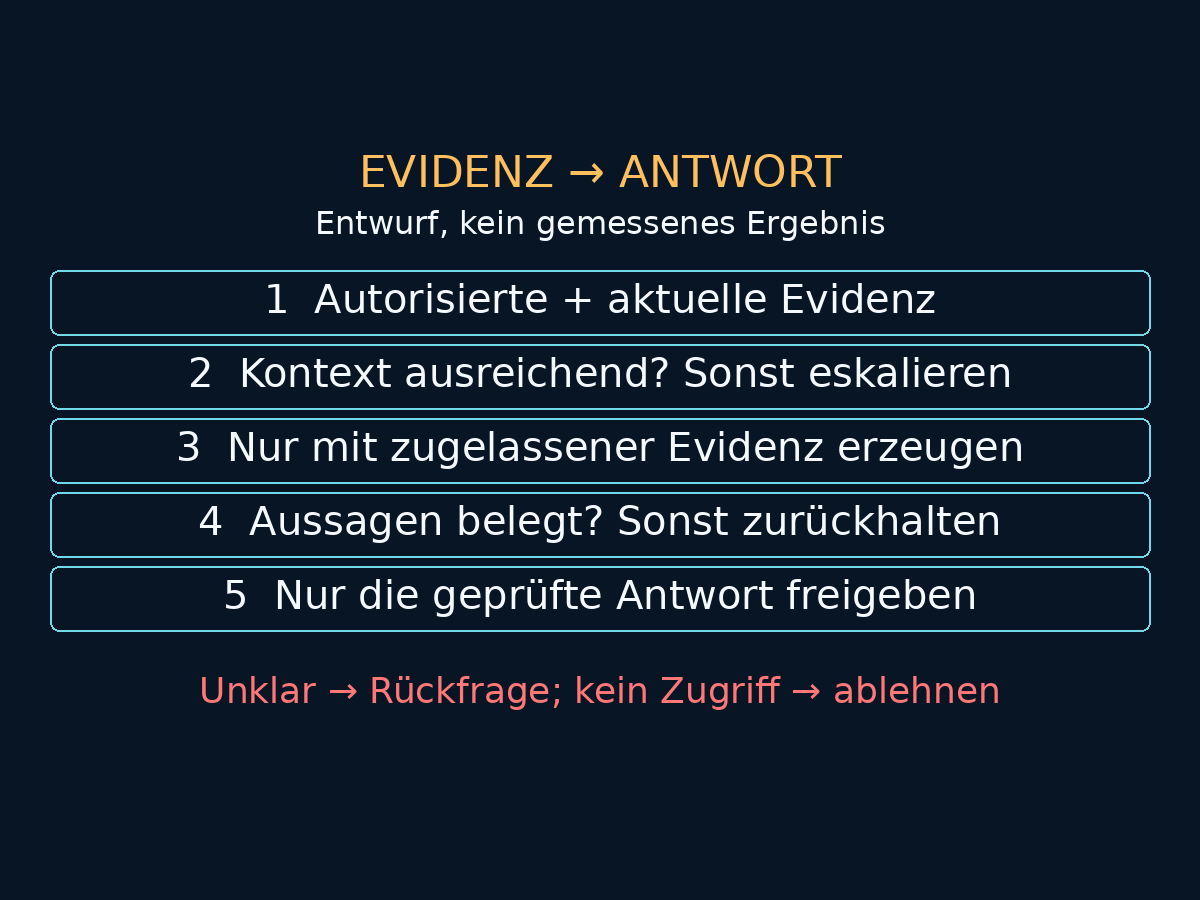
Das Diagramm trennt Evidenzzulassung und Antwortfreigabe. Ein Kandidat kann sämtliche erforderlichen Belege erhalten und dennoch eine Einschränkung auslassen, einen Wert vertauschen oder eine unbelegte Aussage ergänzen. Die abschließende Belegprüfung muss Aussagen mit den zitierten Stellen vergleichen, einschließlich Anwendbarkeit und Einheiten. Automatische Bewerter können unterstützen, übersehen aber ebenfalls Fehler. Folgenreiche Verfahren benötigen weiterhin die zugehörige menschliche und betriebliche Freigabe; diese Prüfung ist keine Erlaubnis zur Anlagensteuerung.
Kalibrieren Sie das Ziel, nicht den Namen des Kosinus-Scores
Beginnen Sie mit einer transparenten regelbasierten Variante und einer reinen Ähnlichkeitsbaseline. Falls ein gelernter Klassifikator gerechtfertigt ist, sollte sein Ziel die fachlich gelabelte ausreichende Kontextevidenz für den definierten Umfang sein. Mögliche Merkmale sind die Abdeckung erforderlicher Einheiten, Revisionsprüfungen, Widerspruchssignale und Ranking-Werte. Das sind zu validierende Entwurfsentscheidungen, keine in diesem Beitrag nachgewiesen ausreichenden Merkmale.
Trennen Sie Modelltraining, Wahrscheinlichkeitskalibrierung, Auswahl der Entscheidungsschwelle und unangetastete Abnahmeprüfung. Gruppieren Sie Paraphrasen und gemeinsame Dokumentfamilien gegen Datenleckage; verwenden Sie einen zeitlichen Holdout, wenn spätere Änderungen die betriebliche Herausforderung darstellen. Fixieren Sie Index-Snapshot, Berechtigungsfixture, Retriever, Reranker, Prompt, Generator und Bewerterversionen. Optimieren Sie nicht nach Kenntnis der Abnahmefehler den Schwellenwert und nennen denselben Datensatz danach weiterhin unangetastet.
Die Kalibrierungsdokumentation von scikit-learn erläutert, dass kalibrierte Wahrscheinlichkeiten mit beobachteten positiven Häufigkeiten übereinstimmen sollten. Sie warnt vor Kalibrierung anhand der Trainingsvorhersagen des Klassifikators. Prüfen Sie Zuverlässigkeitsdiagramme und Fallzahlen je Intervall. Ein niedrigerer Brier-Score allein belegt keine bessere Kalibrierung, weil auch die Trennschärfe eingeht. Kalibrierung benötigt repräsentative Daten; sie zertifiziert weder eine einzelne Antwort noch beliebige Verteilungsänderungen.
Vergleichen Sie auf dem Datensatz zur Schwellenwahl selektive Fehlerquote, Antwortabdeckung und Eskalationskapazität. Wählen Sie unter vorab festgelegten Risiko- und Arbeitslastgrenzen die zulässige Richtlinie mit der benötigten nützlichen Abdeckung. Schreiben Sie nicht einen numerischen Schwellenwert für alle Mandanten, Sprachen und Dokumentklassen vor. Erfüllt keine Richtlinie die Grenzen, verbessern Sie die Evidenz oder begrenzen Sie den Anwendungsumfang, statt stillschweigend mehr Fehler zu tolerieren.
Ein synthetischer Testdatensatz macht den Zielkonflikt sichtbar
Die folgenden acht zugriffsberechtigten Fälle und Scores sind bewusst erfundene Testeingaben. Sie sind keine gemessenen Retrieval- oder Modellausgaben. Die Beantwortbarkeitslabels stehen für fachlich geprüfte Korpusreferenzen; Pfade und Beleg-Flags sind vorgegeben, um die Zählung einschließlich einer falschen Ablehnung und eines Generierungsfehlers zu testen. Ein Python-Test wurde ausgeführt, um die folgenden Anzahlen zu prüfen. Es wurden weder Retriever, Klassifikator, LLM noch Produktionslast ausgeführt.
| Fall | Label und konstruierter Zustand | Ähnlichkeitseingabe | Vorgegebener erster Pfad |
|---|---|---|---|
| A1 | Beantwortbar; aktuelle vollständige Evidenz | 0.93 | Antwort; belegter Kandidat |
| A2 | Beantwortbar; sprachübergreifende Formulierung | 0.63 | Antwort; belegter Kandidat |
| A3 | Beantwortbar; Prüfung verkennt ausreichende Evidenz | 0.57 | Eskalation; falsche Ablehnung |
| A4 | Beantwortbar; Generator ergänzt unbelegte Aussage | 0.88 | Antwort; Belegprüfung blockiert anschließend |
| U1 | Nicht beantwortbar; erforderliche Klausel fehlt | 0.92 | Eskalation |
| U2 | Nicht beantwortbar; nur veraltete Revision | 0.95 | Eskalation |
| U3 | Nicht beantwortbar; ungeklärter Widerspruch | 0.91 | Eskalation |
| U4 | So nicht beantwortbar; Kennung mehrdeutig | 0.87 | Rückfrage |
Für diese Rechenübung sind erzwungene Antworten auf U1–U4 als unbelegt vorgegeben. A3 hätte bei einer Antwort einen belegten Kandidaten. Die Ähnlichkeitsbaseline antwortet ab 0.85; dieser Wert ist eine willkürliche Testeingabe, keine Empfehlung. Alle Richtlinien sehen dieselben acht zugriffsberechtigten Fälle. Tests für Zugriffsverweigerung gehören in eine separate Sicherheitssuite und die gesamte betriebliche Arbeitslastbilanz, nicht in diesen Beantwortbarkeitsnenner.
| Richtlinie | Antwortabdeckung | Unbelegte unter Antworten | Unnötige Nichtantwort | Eskalation / Rückfrage |
|---|---|---|---|---|
| Immer antworten | 8 / 8 | 5 / 8 | 0 / 4 | 0 / 8 und 0 / 8 |
| Ähnlichkeitsbaseline | 6 / 8 | 5 / 6 | 2 / 4 | 2 / 8 und 0 / 8 |
| Begrenzte Richtlinie vor Belegprüfung | 3 / 8 | 1 / 3 | 1 / 4 | 4 / 8 und 1 / 8 |
| Begrenzte Richtlinie nach Belegprüfung | 2 / 8 | 0 / 2 | 2 / 4 | 5 / 8 und 1 / 8 |
Antwortabdeckung bedeutet freigegebene Antworten geteilt durch berechtigte Anfragen; die Zeile vor der Belegprüfung zählt stattdessen Kandidaten. Die selektive Fehlerquote zählt Antworten mit mindestens einer unbelegten Aussage geteilt durch Antworten, nicht Aussagen geteilt durch Aussagen. Unnötige Nichtantworten verwenden die vier im Korpus beantwortbaren Fälle als Nenner, einschließlich A4: Das Zurückhalten seines fehlerhaften Kandidaten schützt die Person, verliert aber weiterhin eine beantwortbare Gelegenheit. Eskalation und Rückfrage beziehen sich jeweils auf alle acht berechtigten Anfragen. Ohne Antworten ist die selektive Fehlerquote undefiniert, nicht null.
Die letzte Zeile belegt keine erfolgreiche Produktionsrichtlinie. Ihre Belegprüfung ist vorgegeben, und zwei freigegebene Antworten erlauben keine Schätzung des Betriebsrisikos. Das Beispiel zeigt, warum null beobachtete Fehler zusammen mit Abdeckung, falschen Ablehnungen und Prüfaufwand berichtet werden müssen. Halten Sie in einer realen Auswertung Zähler, Nenner, Segment, Laufmanifest und Unsicherheitsintervall fest. Analysieren Sie nach unabhängiger Absicht oder Dokumentfamilie, statt Paraphrasen als unabhängige Evidenz zu behandeln.
Testen Sie die Fehler, die der Mittelwert verdeckt
Ergänzen Sie irrelevanten, aber semantisch ähnlichen Kontext, eine widersprüchliche Revision und eine erforderliche Klausel außerhalb des Kontextbudgets. Paaren Sie jede Veränderung mit ihrem Ausgangsfall. Erfassen Sie, ob der Fehler bei Retrieval, Zulassung, Generierung oder Belegprüfung entsteht. Die Ragas-Metrik Noise Sensitivity bewertet fehlerhafte Antwortaussagen relativ zu Referenzevidenz und relevantem oder irrelevantem Kontext. Sie unterstützt die Diagnose der Störanfälligkeit, ist aber weder ein Beantwortbarkeitslabel noch eine kalibrierte Laufzeitrichtlinie für Antwortverzicht.
Berichten Sie deutsche und englische Fragen, sprachübergreifende Anfragen, Dokumentfamilien und folgenreiche Verfahren getrennt. Der Leitfaden zur sprachübergreifenden Suche erläutert, warum flüssiges Deutsch nicht beweist, dass englische Evidenz erhalten blieb. Achten Sie auf Richtlinien, die die gemittelte selektive Fehlerquote verbessern, indem sie ein schwieriges Sprachsegment überproportional ablehnen.
Messen Sie Latenz der Zulassungsprüfung, Latenz der Belegprüfung, gesamte Antwortzeit, Bewerter-Timeouts und Prüfungsrückstand. Protokollieren Sie strukturierte Grundcodes und Evidenzkennungen unter denselben Zugriffs- und Aufbewahrungskontrollen wie die Quellen. Ein Timeout darf keine Freigabe werden. Ein begrenzter Wiederholungsversuch kann bei einem vorübergehenden Prüferausfall sinnvoll sein; wiederholtes Generieren bis zum Bestehen verändert dagegen sowohl die bewertete Richtlinie als auch die Kostenverteilung.
Freigabecheckliste und nächster Implementierungsschritt
Prüfen Sie vor der Freigabe, ob Regeln zur Quellenanwendbarkeit benannte Verantwortliche haben, Korpus- und Kontextlabels getrennt bleiben, Zugriffsverweigerung keine geschützten Inhalte offenlegt, jeder Pfad einen ausführbaren Rückfallweg besitzt und Schwellenwahl von Abnahmedaten isoliert ist. Bewahren Sie Zähler und Nenner für Abdeckung, unbelegte Antworten, unnötigen Antwortverzicht und Eskalation je Segment auf.
Binden Sie diese Fälle anschließend in das RAG-Evaluationsharness als CI-Gate ein. Erproben Sie die Laufzeitrichtlinie begrenzt und halten Sie ein Rollback des vollständigen Pakets bereit. Bewerten Sie nach Änderungen an Korpus, Berechtigungen, Modell, Sprachverteilung oder Scoring neu. Konservativere Schwellen können die Antwortabdeckung senken und Fachpersonal überlasten; aufwendigere Bewerter erhöhen Latenz, Kosten und Abhängigkeiten. Keiner dieser Zielkonflikte verschwindet durch ein Konfidenzlabel.
Bringen Sie eine klar begrenzte Fragenfamilie, die anwendbaren Dokumentrevisionen, Ihr Berechtigungsmodell und die Fehler- und Eskalationsgrenzen des Serviceverantwortlichen mit. Ich unterstütze Ihr Team beim Aufbau gelabelter Evidenzfälle und eines reproduzierbaren Vergleichs der Antwortpolitik. Das nützliche Ergebnis ist eine prüfbare Antwortgrenze mit expliziter Fehlerbehandlung – kein beruhigender Score neben jeder Antwort.