Die relevante Passage kann Ihre Kandidatenliste erreichen und trotzdem vor der Bewertung durch den Reranker verschwinden. Prüfen Sie diese Grenze, bevor Sie Embeddings austauschen oder den Index erweitern. Fixieren Sie das Retrieval, untersuchen Sie die tatsächlich an den Cross-Encoder übergebenen Query-Dokument-Tokens und vergleichen Sie den Evidenzerhalt mit einer Baseline ohne Reranker. Größere Paarlimits oder zusätzliche Passagenfenster sind erst dann sinnvoll, wenn ihr Qualitätsgewinn die Latenz und Betriebskosten rechtfertigt.
Dieser Fehler unterscheidet sich vom Abruf des falschen Handbuchs. Ein Reranker kann eine Quelle erhalten, die die Antwort enthält, während sein Tokenizer nur deren Einleitung behält. Der Score bewertet dann den verbliebenen Text, nicht die Evidenz, die Ihre Anwendung vermeintlich übergeben hat. Ein scheinbar erfolgreicher Retrieval-Trace kann deshalb einen nachgelagerten Evidenzverlust verdecken.
Lokalisieren Sie die Grenze des Evidenzverlusts
Der Retrieve-and-Rerank-Leitfaden von Sentence Transformers trennt die erste Kandidatensuche von der Cross-Encoder-Bewertung. Ein Cross-Encoder verarbeitet Query und Kandidat gemeinsam. Die CrossEncoder-API dokumentiert eine maximale Eingabelänge und die Kürzung längerer Eingaben. Beides garantiert nicht, dass der entscheidende Satz Ihre produktive Vorverarbeitung übersteht.
Erfassen Sie Evidenz an vier Grenzen: im fixierten Kandidatentext, im tokenisierten Paar, in den ausgewählten gerankten Passagen und im Kontext des Generators. Jeder Verlustort verlangt einen anderen Eingriff. Wird die richtige Quelle gar nicht erst Kandidat, hilft die Diagnose hybrider Suche für exakte Kennungen. Übersteht die Evidenz die Tokenisierung, fällt aber unter die abschließende Auswahlgrenze, prüfen Sie Ranking und Auswahlpolitik. Erreicht sie den fertigen Prompt und bleibt die Antwort falsch, untersuchen Sie die Generierung separat.
Ändern Sie nicht sofort die Dokumentsegmentierung. Die Baseline zur Chunking-Evaluation behandelt eine vorgelagerte Entscheidung. Halten Sie hier Chunks und Kandidatenreihenfolge konstant, damit das Reranker-Experiment eine identifizierbare Ursache besitzt.
Das Paarlimit ist ein gemeinsames Budget
Das nutzbare Dokumentbudget entspricht dem Paarlimit abzüglich Query-Tokens, Spezialtokens und gegebenenfalls separat hinzugefügter Instruktionen oder Präfixe. Zählen Sie mit dem produktiven Tokenizer nach der tatsächlichen Formatierung. Zeichenanzahl, Tokenzahlen des Embedding-Modells und das Kontextfenster des Generators sind kein Ersatz. Ziehen Sie ein Präfix nicht doppelt ab, wenn es bereits in den gemessenen Query-Tokens steckt.
Die Hugging-Face-Referenz zu Padding und Trunkierung unterscheidet longest_first, only_first und only_second. Steht die Query im Paar zuerst und das Dokument an zweiter Stelle, schützt only_second die Query durch Kürzung des Dokuments. Das ist nicht grundsätzlich sicherer: Eine Query, die die verfügbare Kapazität aufbraucht, kann diese Strategie unmöglich machen. Definieren Sie dafür eine explizite Ablehnung oder kontrollierte Query-Kürzung, statt Teilenummer oder Negation still zu entfernen. Ihr Wrapper kann eine andere Strategie verwenden; prüfen Sie den tatsächlichen Aufruf und die Kürzungsseite.
Padding und Trunkierung sind getrennte Vorgänge. Padding ergänzt Positionen für die Stapelverarbeitung; Trunkierung entfernt Inhalt. Erfassen Sie Attention-Mask, Batchgröße, maximale gepaddete Länge und ungepaddete Längen in Diagnoseaggregaten. Gruppieren Sie ähnlich lange Paare, wenn Messungen das rechtfertigen. Prüfen Sie dabei, dass nach der Umsortierung wieder die ursprünglichen Kandidaten-IDs zu den Scores gehören.
Ein ausgeführter Test: dieselbe Evidenz an anderer Position
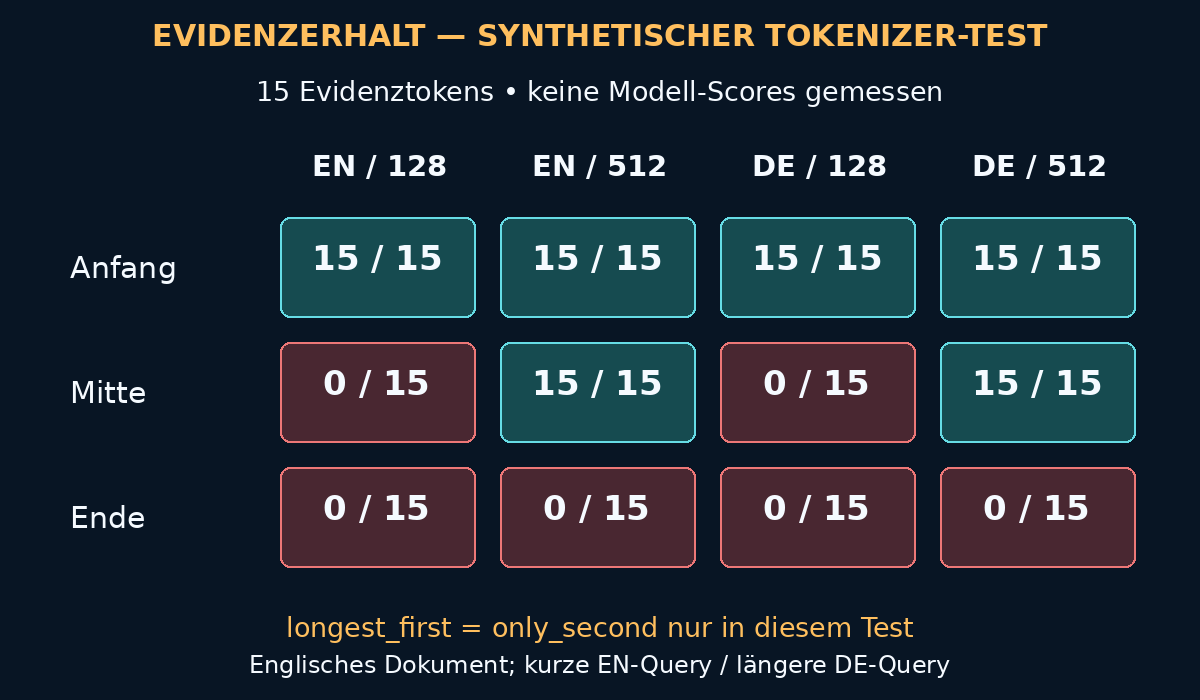
Für diesen Artikel wurde ein synthetischer Tokenizer-Test mit tokenizers 0.23.2 und dem Tokenizer von cross-encoder/ms-marco-MiniLM-L6-v2 ausgeführt, fixiert auf Revision 233902d25c440f23af6f7d6e94d2946bac0bee0a. Es wurden keine Modellgewichte geladen. Gemessen wurden weder Relevanzscores noch nDCG, Latenzbenchmarks oder produktive Verbesserungen. Der Tokenizer dieses englisch trainierten Modells illustriert eine Verarbeitungsgrenze; er ist keine Empfehlung für deutsches Ranking.
Die erfundene Evidenz lautete „The approved seal for AX-104-B is ZQ-77.“ Sie belegte 15 Tokens. Neunzig Wiederholungen von „Routine maintenance documentation contains general inspection information.“ lieferten kontrollierten Fülltext. Der Evidenzsatz stand vor dem gesamten Fülltext, nach 45 Wiederholungen oder nach allen 90. Die Kennungen sind synthetisch und stellen keine reale Wartungsanweisung dar.
Die kurze englische Query „Which seal fits AX-104-B?“ belegte neun Tokens. Die absichtlich längere deutsche Query „Welche freigegebene Dichtung passt zu AX-104-B unter Berücksichtigung der dokumentierten Revision und der vorgesehenen Betriebsbedingungen?“ belegte 48. Dies sind keine gleichwertigen Übersetzungen: Die Differenz misst keinen Sprachnachteil. Die ungekürzten Paare umfassten einschließlich Spezialtokens 747 beziehungsweise 786 Tokens.
| Position der 15-Token-Evidenz | EN: Limit 128 | EN: Limit 512 | DE: Limit 128 | DE: Limit 512 |
|---|---|---|---|---|
| Anfang | 15/15 erhalten | 15/15 erhalten | 15/15 erhalten | 15/15 erhalten |
| Mitte | 0/15 erhalten | 15/15 erhalten | 0/15 erhalten | 15/15 erhalten |
| Ende | 0/15 erhalten | 0/15 erhalten | 0/15 erhalten | 0/15 erhalten |
Die Ergebnisse waren in diesem Test für longest_first und only_second identisch, weil das Dokument die längere Sequenz blieb. Daraus folgt keine Gleichwertigkeit bei langen Queries oder anderen Modellen. Der belastbare Befund ist enger: Das größere Limit rettete die Evidenz in der Mitte, nicht aber am Ende. Mehr Kandidaten allein stellen keinen Satz wieder her, der aus jedem bewerteten Paar entfernt wird.
So reproduzieren Sie die Prüfung des Tokenerhalts
Verwenden Sie einen schnellen Tokenizer mit Offsets und Sequenzzuordnung. Kodieren Sie zunächst das vollständige Paar ohne Trunkierung und Padding. Markieren Sie den Evidenzbereich über Zeichenpositionen im exakt formatierten Dokumentstring. Sammeln Sie alle nichtleeren Token-Offsets aus Sequenz 1, die diesen Bereich schneiden. Kodieren Sie anschließend dasselbe Paar unter dem vorgesehenen Limit und sammeln Sie erneut die Offsets von Sequenz 1. Vollständiger Erhalt bedeutet, dass jeder Ziel-Offset bestehen bleibt. Zählen Sie Teilerhalt gesondert: Bleibt die Kennung erhalten, aber nicht die Einschränkung, ist der Fall nicht erfolgreich.
Das ausgeführte Prüfskript verwendet folgenden reproduzierbaren Kern der tokenizers-Python-API: Laden Sie die fixierte tokenizer.json mit Tokenizer.from_file; rufen Sie no_truncation() und no_padding() auf; erzeugen Sie full = tok.encode(query, doc). Bilden Sie target aus zip(full.offsets, full.sequence_ids) mit sid == 1, a < evidence_end, b > evidence_start und b > a. Aktivieren Sie anschließend enable_truncation(max_length=limit, strategy=strategy, stride=0), kodieren Sie erneut und bilden Sie kept aus nichtleeren Offsets der Sequenz 1. Geben Sie len(target & kept), len(target) und target <= kept aus. Vergleichen Sie nur die tatsächlich an das Modell übergebene Hauptkodierung, nicht zusätzliche Overflow-Kodierungen, die Ihre Anwendung nie bewertet.
Das vollständige lokale Skript und seine Ergebnisse wurden mit den Publikationsnachweisen gespeichert. Die tokenizer.json hatte den SHA-256-Wert d241a60d5e8f04cc1b2b3e9ef7a4921b27bf526d9f6050ab90f9267a1f9e5c66. Die Wiederholung mit einem anderen Tokenizer ist ein neues Experiment. Für ein produktives Release-Gate erfassen Sie zusätzlich input_ids und attention_mask des tatsächlichen Wrappers und vergleichen sie mit der Diagnosekodierung. Ein isolierter Tokenizer-Test beweist nicht, was Ihr Serving-Wrapper übergibt.
Offsets erfordern Sorgfalt. Ein vorangestellter Titel verschiebt Evidenzpositionen; Normalisierung kann Tokengrenzen verändern; manche Pipelines liefern keine verwendbaren Offsets. Lassen Sie die Prüfung bei fehlender Zuordnung explizit scheitern, statt null Verlust zu melden. Speichern Sie im Regelbetrieb aggregierte Erhaltungszahlen. Bewahren Sie eingeschränkte Diagnosefälle zugriffsgeschützt auf, statt Kundendokumente oder rückübersetzbare Token-IDs in Standardlogs zu schreiben.
Trennen Sie Kandidatenzahl und Paarlänge
Erstellen Sie ein fixiertes Manifest mit Query-ID, Korpusrevision, Kandidaten-IDs und geordneten Texten, annotierten Evidenzbereichen, Tokenizer- und Modellrevision, Vorverarbeitungsversion, Kürzungsseite, Paarlimit und abschließendem Kontextbudget. Vergleichen Sie drei Pfade: unveränderte Retrieval-Reihenfolge ohne Reranking, aktuelle Cross-Encoder-Konfiguration und vorgeschlagene längere Paare oder Fenster. Verwenden Sie in allen Pfaden dasselbe finale Kontextbudget.
| Beobachteter Fehler | Kandidatenzahl ändern? | Paarlänge oder Fenster ändern? | Erforderliche Prüfung |
|---|---|---|---|
| Evidenz fehlt in fixierten Kandidaten | Retrieval separat testen | Nicht der erste Eingriff | Evidenz-Recall der Kandidaten |
| Evidenz vorhanden, aber abgeschnitten | Anzahl zunächst konstant halten | Unterstützte Paarlimits variieren | Span-Erhalt und finaler Evidenz-Recall |
| Evidenz bleibt, rankt aber zu niedrig | Anzahl als getrennte Achse testen | Mehr Tokens helfen nicht zwingend | nDCG und Recall an der Auswahlgrenze |
| Lange deutsche Query verdrängt Evidenz | Anzahl konstant halten | Formatierung und Query-Regeln prüfen | Erhalt von Kennung und Negation |
| Latenz oder Padding-Verschwendung steigt | Anzahl unabhängig variieren | Längen gruppieren oder Fenster begrenzen | Tail-Latenz je Query und Qualitätsgrenzen |
Variieren Sie zunächst die Paarlänge bei identischer Kandidatenmenge, danach die Kandidatenzahl unabhängig davon. Bleiben Sie bei einer späteren gemeinsamen Testmatrix bei zwei expliziten Achsen. Mehr Kandidaten bedeuten mehr Paare; Passagenfenster können diese Zahl nochmals vervielfachen. Ein größeres Limit kann außerdem die gepaddete Batchlänge verändern. Messen Sie das tatsächliche Backend, statt Kosten allein aus Tokenzahlen hochzurechnen.
Berichten Sie den Evidenzerhalt an der finalen Auswahlgrenze mit einem klaren Nenner annotierter relevanter Evidenzeinheiten. Definieren Sie für nDCG die Relevanzskala und die deterministische Behandlung gleicher Scores. Deduplizieren Sie anhand der Quellen-Evidenz-ID, damit drei Fenster mit demselben Satz nicht drei Erfolge werden. Ergänzen Sie Latenzverteilungen je Query, Wartezeit, Warm- und Kaltstartbedingungen, Durchsatz, Hardware, Batching und eine explizite Definition der Padding-Verschwendung. Rohe Cross-Encoder-Scores sind keine kalibrierten Wahrscheinlichkeiten für die Korrektheit der späteren Antwort.
Fenster sind eine Auswahlregel, keine kostenlose Reparatur
Erzeugen Sie bei langen Quellen Query-budgetabhängige Passagenfenster, ohne sofort den Retrieval-Index neu aufzubauen. Erhalten Sie übergeordnete Dokument-ID, Revision, Abschnitt, Zeichenbereich und Berechtigungsumfang. Überlappung kann eine an der Grenze geteilte Warnung bewahren, erhöht aber Rechenaufwand und Duplikate. Leiten Sie die Überlappung aus den zu erhaltenden Evidenzstrukturen ab, nicht aus einem unbegründeten Prozentsatz.
Definieren Sie, wie Fensterscores zu einem Kandidatenscore werden. Das Maximum ist ein plausibles Experiment, keine garantierte Regel: Dokumente mit vielen Fenstern erhalten mehr Chancen auf einen hohen Score. Ein lokal relevanter Satz kann außerdem eine anderswo stehende Gültigkeitsbedingung auslassen. Vergleichen Sie das Maximum mit einer Alternative mit begrenzter Fensterzahl und bewahren Sie benachbarte Einschränkungen bei der finalen Passagenauswahl. Zeigen Sie keine Zitation des Gesamtdokuments, wenn Revision oder verifizierbarer Textbereich verloren gehen.
Die Fensterauswahl darf nur Informationen nutzen, die bei der Inferenz verfügbar sind. Um annotierte Antworten zentrierte Oracle-Fenster liefern eine diagnostische Obergrenze, aber keine produktiv einsetzbare Verbesserung. Kennzeichnen Sie diese separat, damit die Evaluation nicht versehentlich einen Selektor mit Kenntnis der richtigen Antwort freigibt.
Eine Release-Checkliste mit klarer Zuständigkeit
Gate 1 — Wiederholen Sie fixierte Kandidatentests mit Evidenz am Anfang, in der Mitte und am Ende. Ergänzen Sie Query-Präfixe, lange Queries, exakte Kennungen, Negationen und Evidenz über einer Fenstergrenze.
Gate 2 — Prüfen Sie, dass Quellen-, Revisions- und Berechtigungsidentität Fensterbildung und Batching überstehen. Blockieren Sie stille Änderungen der Trunkierungsregel, fehlende Offsets und nicht unterstützte Modelllängen.
Gate 3 — Vergleichen Sie Baseline ohne Reranker, aktuelle und vorgeschlagene Konfiguration bei identischem finalem Kontextbudget. Prüfen Sie Evidenzerhalt, Rankingqualität und Tail-Latenz je geschütztem Query-Segment, nicht nur als Gesamtdurchschnitt.
Gate 4 — Geben Sie nur anhand vorab vereinbarter Grenzen aus Ihrem Workload und Risikobudget frei. Halten Sie einen Rollback auf die vorherige Reranker-Konfiguration bereit. Das CI-Gate für RAG-Evaluation liefert den übergeordneten Release-Rahmen; der zusätzliche Test kontrolliert die Tokengrenze und ersetzt keine Ende-zu-Ende-Evaluation.
Fragen vor einer Änderung der Serving-Konfiguration
Behebt ein größeres max_length den Fehler immer? Nein. Modell und Backend müssen die Länge unterstützen; das Ende kann weiterhin abgeschnitten werden, und zusätzliche Ablenkung kann das Ranking verschlechtern. Validieren Sie Erhalt und Qualität getrennt.
Sollten Sie immer only_second verwenden? Nein. Die erste Sequenz bleibt nur geschützt, wenn das angeforderte Paar überhaupt darstellbar ist. Query-Reihenfolge, Templates, Query-Länge und Fehlerbehandlung gehören zum Vertrag.
Beweist ein niedriger Score, dass die Quelle irrelevant ist? Nein. Prüfen Sie, welche Tokens bewertet wurden. Auch eine vollständig sichtbare Passage kann einen schlechten Relevanzscore erhalten; Relevanz ist zudem nicht Antwortkorrektheit.
Wenn Sie zwischen einem neuen Embedding-Modell und einer Reranker-Änderung entscheiden, beginnen Sie mit einer begrenzten Diagnose: ein fixierter Kandidatensnapshot, annotierte Evidenz, ein Serving-Manifest und ein Latenzbudget. Ich unterstütze Sie bei der Ausgestaltung dieser Evaluation und ihrer Release-Gates. Das Ergebnis sollte eine reproduzierbare Entscheidung über den Ort des Evidenzverlusts sein – keine weitere Modellmigration auf Basis eines undurchsichtigen Gesamtscores.