BLUF: Ein aufgefüllter Sensorwert ist nicht automatisch ein verwendbares Modellmerkmal. Begrenzen Sie die Fortschreibung anhand der verstrichenen Zeit, erhalten Sie die Herkunft als beobachtet oder imputiert und setzen Sie den Zustand bei Anlagen- oder Betriebsregimewechseln zurück. Verwerfen Sie unbrauchbare Quellqualität vor der Imputation. Bewerten Sie Ausgabeverfügbarkeit und Aufgabenfehler gemeinsam: Eine Pipeline, die immer eine Zahl liefert, kann besonders unzuverlässig sein.
Welche Entscheidung trifft die Merkmalsprüfung?
Die Entscheidung ist eng begrenzt: Darf dieses Modell diesen Merkmalsvektor jetzt für die freigegebene beratende Aufgabe verwenden? Sie entscheidet weder über einen Maschinenstopp noch über die Freigabe einer Sicherheitsfunktion. Eine Wartungsempfehlung und eine Sicherheitsverriegelung benötigen unterschiedliche technische Nachweise. Numerische Vollständigkeit verleiht keine Steuerungsbefugnis.
Beginnen Sie nach der Klärung von Identität, Einheiten, Qualitätszuordnung und zeitlicher Ausrichtung. Der industrielle Datenvertrag beschreibt diese semantischen Voraussetzungen. Der Lebenszyklus verspäteter Sensordaten legt fest, wann sich ein Zeitfenster noch ändern darf. Hier geht es um den fehlenden Merkmalswert an einem konkreten Entscheidungszeitpunkt – nicht um Watermarks oder eine weitere AAS-Schnittstelle.
Trennen Sie drei Strategien. Strikte Ablehnung bewertet nur Vektoren mit verwendbaren Beobachtungen für alle erforderlichen Merkmale. Zeitlich begrenzte Fortschreibung toleriert eine validierte kurze Lücke, ohne eine neue Messung vorzutäuschen. Ein angepasster Imputer schätzt fehlende Werte aus Trainingsdaten. Jede Strategie kann sinnvoll sein; keine ersetzt die Prüfung von Qualität, Betriebsregime und Ausgabegültigkeit.
Warum ffill(limit=3) keine Aktualitätsregel ist
Die pandas-Dokumentation zur Fortschreibung definiert limit anhand aufeinanderfolgender fehlender Einträge. Drei Zeilen können drei Sekunden, drei Minuten oder einen unregelmäßigen Wiederverbindungsstoß repräsentieren. Eine Zeilengrenze belegt daher nicht das Alter einer industriellen Beobachtung.
Erhalten Sie den Zeitpunkt der letzten bestätigten verwendbaren Beobachtung und berechnen Sie Alter = Entscheidungszeit − Bestätigungszeit. Ein fortgeschriebener Wert muss seine ursprüngliche Bestätigungszeit behalten. Wenn jede Kopie den aktuellen Zeitstempel erhält, erscheint veraltete Evidenz dauerhaft frisch. Im folgenden Testbeispiel sind höchstens fünf Sekunden zulässig. Das ist ein Testparameter, keine Empfehlung für Ihre Anlage.
Leiten Sie die reale Grenze aus dem Fehlerbudget der Aufgabe, beobachteter Prozessdynamik, Erfassungsgarantien und Fehlerverläufen ab. Validieren Sie sie getrennt nach Merkmal und Betriebsregime. Eine langsam veränderliche Umgebungsgröße und ein schnell wechselndes Lastsignal benötigen nicht zwingend dasselbe Budget. Auch ein frischer Wert braucht korrekte Einheiten, Wertebereiche und Kalibrierung; Aktualität repariert keinen defekten Sensor.
OPC-UA-Zeitstempel benötigen einen Erfassungsvertrag
Die OPC-UA-Spezifikation für DataValue verlangt, dass Clients vor der Verwendung von Werten mindestens den Schweregrad des StatusCode prüfen. Bad bedeutet unbrauchbar. Uncertain bedeutet unsichere Qualität aus dem angegebenen Grund. Die konservative Regel dieses Artikels verwirft beides und löscht den zwischengespeicherten Wert des Kanals. Alle Uncertain-Untercodes gleich zu behandeln, ist unsere technische Regelentscheidung, keine allgemeine OPC-UA-Vorgabe.
Setzen Sie sourceTimestamp nicht mechanisch mit der Bestätigungszeit gleich. Laut Spezifikation soll sourceTimestamp die letzte Änderung von Wert oder Status abbilden. Eine stabile, korrekt erfasste Temperatur kann deshalb einen alten Änderungszeitstempel besitzen. serverTimestamp kann darstellen, wann ein Server den Wert als korrekt kannte, auch bei änderungsbasierter Erfassung. Seine Aussagekraft hängt aber vom Server und der vorgelagerten Kette ab.
Definieren Sie, wie der Adapter fortbestehende Gültigkeit feststellt: bestätigte Abtastung, ein vertrauenswürdiges Lebenszeichen mit Gerätezustandsnachweis oder dokumentierte Semantik der änderungsbasierten Meldung. Erhalten Sie Quell- und Serverzeitstempel, Erfassungsbestätigung und Ankunftszeit getrennt. Eine Wiederverbindung macht aus einer alten gepufferten Beobachtung keine neue Messung. Unklare Zeitqualität oder Erfassungssemantik muss die Inferenzfreigabe blockieren, statt einen erfundenen Aktualitätszeitstempel zu erzeugen.
Entscheidungstabelle: Unsicherheit erhalten statt verdecken
| Bedingung | Merkmalsaktion | Zustandsfolge | Inferenzfolge |
|---|---|---|---|
| Verwendbare Good-Beobachtung innerhalb der Altersgrenze | Beobachteten Wert mit tatsächlichem Alter ausgeben | Wert und Bestätigungszeit speichern | Vorbehaltlich Prüfung des Gesamtvektors geeignet |
| Wert fehlt, gleicher Lebenszyklus und gleiches Regime, Alter zulässig | Letzten verwendbaren Wert fortschreiben; als imputiert markieren | Bestätigungszeit nicht erneuern | Nur für validierte Lückenmuster geeignet |
| Wert fehlt länger als zulässig | Verworfen mit Ablaufgrund ausgeben | Lebensdauer nicht durch Kopieren verlängern | Auf Ausgabe verzichten oder separat validierten Ersatzpfad nutzen |
| Bad oder nach Regel abgelehntes Uncertain | Auch vorhandenen Zahlenwert verwerfen | Zwischenspeicher des Kanals löschen | Fehler nicht hinter alter Messung verbergen |
| Anlagentausch oder Regimewechsel | Historie vor dem Auffüllen löschen | Neue Lebenszyklus-/Regime-Epoche beginnen | Neue Evidenz oder freigegebenen Kaltstartpfad verlangen |
| Alter gepufferter oder zukünftiger Wiederverbindungswert | Nach Zeit- und Verfügbarkeitsprüfung verwerfen | Ankunftszeit nicht zur Messzeit erklären | Merkmal bleibt nicht verfügbar |
| Mehrere erforderliche Kanäle fehlen | Gesamtes Fehlwertmuster prüfen | Herkunft je Kanal erhalten | Ohne Validierung dieses gemeinsamen Musters ablehnen |
Die letzte Zeile ist entscheidend. Einzeln zulässige Fortschreibungen können zusammen eine ungeprüfte Kombination bilden. Das kleine Testbeispiel erlaubt bewusst zwei kurze Fortschreibungen, um den entstehenden Fehler sichtbar zu machen. Eine produktive Vektorprüfung sollte eine ausdrückliche Freigabeliste validierter Fehlwertmuster verwenden. Ein Medianwert ist kein Umweg um diese Freigabeliste.
Einen kausalen, zustandsbehafteten Transformer implementieren
1. Partitionieren Sie den Zustand nach stabiler Anlagenlebenszyklus- und Merkmalsidentität. Binden Sie ihn an eine Regime-Epoche, die bei Rezeptwechsel, Wartungsgrenze und Sensortausch wechselt. Die Epoche muss ein verbindliches Lebenszykluskennzeichen sein, kein Anzeigename. Fehlende oder mehrdeutige Regimeinformationen blockieren den Pfad.
2. Verarbeiten Sie Entscheidungen je Anlage in nicht abnehmender Zeitreihenfolge. Akzeptieren Sie nur Informationen, die zum Entscheidungszeitpunkt verfügbar waren. Prüfen Sie die Erfassungsbestätigung gegen diesen Zeitpunkt und verwerfen Sie Zukunftsinformationen. Behandeln Sie verspätete Beobachtungen vorgelagert; überschreiben Sie niemals eine neuere gespeicherte Bestätigung mit einer älteren.
3. Prüfen Sie Qualität, endlichen Zahlenwert und Erfassungsmetadaten. Bad oder abgelehntes Uncertain löscht bei dieser Regel den gespeicherten Kanalwert. Auch unbekannte Qualitätscodes führen zur Ablehnung. Bewahren Sie ursprünglichen StatusCode und Grund dauerhaft auf, selbst wenn der Transformer normalisierte Bezeichnungen verwendet.
4. Geben Sie für eine verwendbare Beobachtung Wert, Alter und provenance=observed aus. Fehlt der Wert, prüfen Sie den Zwischenspeicher derselben Epoche. Schreiben Sie nur innerhalb des Merkmalsbudgets fort, mit provenance=carried und missing=true. Andernfalls liefern Sie value=null und provenance=rejected. Nachgelagerte Systeme müssen null von einer gemessenen Null unterscheiden.
5. Prüfen Sie anschließend die Gültigkeit des Gesamtvektors. Speichern Sie Fehlwertmuster, größtes Alter, Ablehnungsgründe, Merkmalsregelversion und Modellversion gemeinsam mit Vorhersage oder Ausgabeausschluss. Das Modell kann Zahlenwerte und Fehlwertindikatoren erhalten; die Regelmetadaten müssen zusätzlich außerhalb des Modells zugänglich bleiben.
Das ausgeführte Python-Testbeispiel verwendet eine Klasse FeatureGate mit transform(asset, epoch, now, samples). Jede Probe enthält value, quality, confirmed_at und available_at. Jede Ausgabe erhält value, source_quality, epoch, missing, provenance, reason und age. Die erforderlichen Merkmale sind x und z. Produktiver Code muss das vollständige Schema erzwingen: Ein fehlender Dictionary-Schlüssel darf den Vektor nicht unbemerkt verkleinern. Das Beispiel ist ein zustandsbehafteter Test im Arbeitsspeicher, kein bereitgestellter OPC-UA-Connector oder dauerhafter Feature Store.
Zeitachse: beobachtet, fortgeschrieben, verworfen
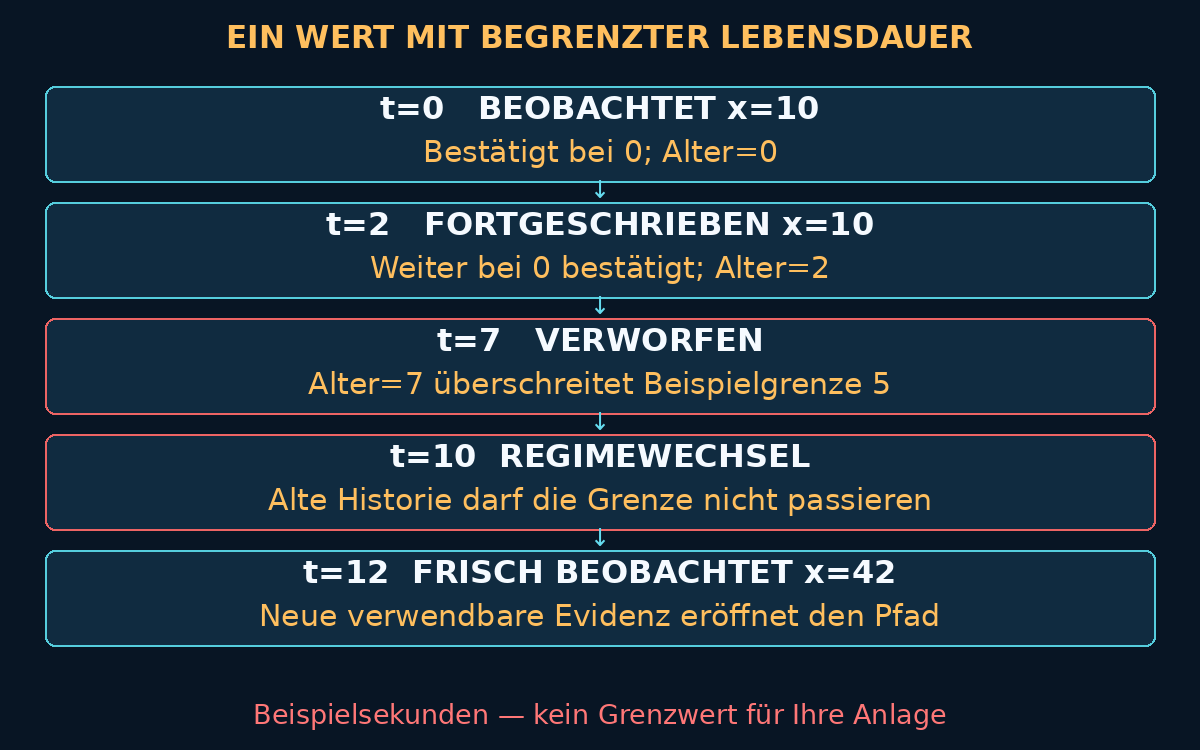
Bei t=0 wird x=10 beobachtet. Bei t=2 fehlt x; die Prüfung schreibt 10 mit einem Alter von zwei Sekunden fort. Bei t=7 fehlt x weiterhin und muss verworfen werden: Das Kopieren bei t=2 hat seine Uhr nicht zurückgesetzt. Ein Regimewechsel bei t=10 entwertet die Historie unabhängig vom Alter. Bei t=11 liefert die Wiederverbindung eine bei t=4 bestätigte Probe; sie bleibt veraltet. Frische Beobachtungen bei t=12 eröffnen wieder einen verwendbaren Pfad.
Deterministischer Ausfalltest mit tatsächlichen Ergebnissen
Für diesen Artikel wurde das Testbeispiel mit zehn Entscheidungen, zwei synthetischen Merkmalen und einer Fortschreibungsgrenze von fünf Sekunden ausgeführt. Die bewusst einfache Aufgabe schätzt x+z. Die Auswertung kennt die verborgenen wahren Werte; die Merkmalsprüfung kennt sie nicht. Die Werte haben beliebige Einheiten. Das Experiment ist kein Predictive-Maintenance-Benchmark. Alle Wertepaare sind als (x, z) geordnet; B bedeutet beobachtet, F fortgeschrieben und V verworfen.
| Zeit und Epoche | Eingangsereignis | Verborgene Wahrheit | Ausgabe bei begrenzter Fortschreibung |
|---|---|---|---|
| 0, A | Good-Proben (10, 20) | (10, 20) | (10 B, 20 B) |
| 2, A | x fehlt; z=20 Good | (12, 20) | (10 F, 20 B) |
| 7, A | Beide fehlen | (17, 25) | (null V, 20 F) |
| 8, A | x=999 Bad; z=26 Good | (18, 26) | (null V, 26 B) |
| 9, A | x=19 Good; z=27 Uncertain | (19, 27) | (19 B, null V) |
| 10, B | Regimewechsel; beide fehlen | (40, 50) | (null V, null V) |
| 11, B | x=19 bei 4 bestätigt; z=51 Good | (41, 51) | (null V, 51 B) |
| 12, B | Frische Proben (42, 52) | (42, 52) | (42 B, 52 B) |
| 15, B | Beide fehlen | (45, 55) | (42 F, 52 F) |
| 18, B | Beide fehlen | (48, 58) | (null V, null V) |
Ein separater Trainingsfold vor dem Test enthält (8,18), (10,20), (12,22). Daraus folgen die Mediane (10,20). Die freizügige Median-Baseline ersetzt überall dort, wo die Prüfung keinen beobachteten Wert ausgibt, durch diese Mediane. Sie ignoriert bewusst die betriebliche Zulässigkeit einschließlich des Regimewechsels, um den Unterschied zwischen numerischer Abdeckung und Abnahme zu zeigen. Die Statistiken werden ausschließlich auf diesem Trainingsfold angepasst. Das Beispiel trainiert kein Vorhersagemodell.
Die ausgeführten Ergebnisse nennen verfügbare Vektoren geteilt durch Entscheidungen und anschließend den mittleren absoluten Fehler (MAE) der tatsächlich ausgegebenen Vektoren. Ein Strich bedeutet keine Ausgabe, nicht Fehler null. Der Fehler bei gemeinsamem Ausfall ist auf zwei Nachkommastellen gerundet.
| Muster | Strikte Ablehnung: Verfügbarkeit; MAE | Begrenzte Fortschreibung: Verfügbarkeit; MAE | Freizügiger Median: Verfügbarkeit; MAE |
|---|---|---|---|
| Alle Entscheidungen | 2/10; 0 | 4/10; 2 | 10/10; 26,6 |
| Ein Kanal fehlt | 0/1; — | 1/1; 2 | 1/1; 2 |
| Beide Kanäle fehlen | 0/3; — | 1/3; 6 | 3/3; 52,67 |
| Bad-Qualität | 0/1; — | 0/1; — | 1/1; 8 |
| Uncertain-Qualität | 0/1; — | 0/1; — | 1/1; 7 |
| Regimewechsel | 0/1; — | 0/1; — | 1/1; 60 |
| Veraltete Wiederverbindung | 0/1; — | 0/1; — | 1/1; 31 |
| Vollständige Anfangsprobe | 1/1; 0 | 1/1; 0 | 1/1; 0 |
| Frische Wiederverbindung | 1/1; 0 | 1/1; 0 | 1/1; 0 |
Der Fehler null bei strikter Ablehnung beweist nicht, dass diese Strategie die beste ist: Sie bewertet nur die beiden vollständig beobachteten Entscheidungen. Vergleichen Sie Strategien sowohl auf gemeinsam zulässigen Fällen als auch anhand ihres Abdeckungs-/Fehlerverhältnisses. Berücksichtigen Sie die Kosten unterlassener Ausgaben. Der Fortschreibungsfehler bei t=15 zeigt die ungeprüfte gemeinsame Lücke. Die hohe Median-Abdeckung enthält Werte, die die betriebliche Freigabe niemals passieren sollten.
Die Assertions bestanden für alle zehn erwarteten Herkunftspaare, nicht negative ausgegebene Alterswerte, Annahme genau an der Fünf-Sekunden-Grenze, Ablehnung danach, Trennung zwischen Anlagen, Zurückweisung zukünftiger Informationen und Verweigerung rückläufiger Entscheidungszeit. Die aufbewahrten Dateien feature_gate.py und fixture-results.json bilden die ausführbaren Abnahmeartefakte. Sie prüfen weder Netzwerkzustellung noch Neustartwiederherstellung, Nebenläufigkeit oder reale Prozessergebnisse.
Imputation innerhalb der Validierungsgrenze anpassen
Der scikit-learn-Leitfaden zur Imputation dokumentiert SimpleImputer, multivariate Verfahren und Fehlwertindikatoren. Verwenden Sie eine Pipeline, um Imputation und Schätzer innerhalb jedes Trainingsfolds anzupassen. Transformieren Sie zurückgehaltene Daten ohne erneute Anpassung. Das Backtest-Design nach Anlage und Zeit erläutert, warum zufällige Fenster und global angepasste Vorverarbeitung irreführende Evidenz liefern.
Konfigurieren Sie Fehlwertindikatoren bewusst, damit das Merkmalsschema stabil bleibt. Ein Indikator, der nur im Training fehlende Spalten berücksichtigt, kann ein neues Fehlwertmuster im Betrieb übersehen. Eine ausdrückliche Maske für alle Merkmale verhindert diese Verwechslung von Schemastabilität und beobachteten Trainingslücken. Legen Sie fest, wie vollständig leere Trainingsspalten behandelt werden, und testen Sie die resultierenden Dimensionen. Machen Sie das standardmäßige Entfernen von Spalten nicht versehentlich zum Bestandteil Ihrer Schnittstelle.
Spielen Sie realistische Ausfälle nach: zusammenhängende Lücken, lastabhängigen Verlust, gemeinsame Strom- oder Netzfehler, Qualitätswechsel und Wartungsübergänge. Unabhängiges zufälliges Ausblenden einzelner Zellen hilft bei der Fehlersuche, repräsentiert aber weder ein defektes Gateway noch einen unter Vibration ausfallenden Sensor. Verwenden Sie für Online-Abnahmeaussagen niemals Rückwärtsauffüllung, zentrierte Fenster oder zukünftige Messungen.
Freigabecheckliste und betriebliche Grenzen
Verlangen Sie vor Freigabe einen dokumentierten Vertrag zur Erfassungsbestätigung, Altersbudgets je Merkmal, vollständige Pflichtschemas, Lebenszyklus-/Regime-Resets, ausdrückliche Qualitäts- und gemeinsame Fehlwertregeln, fold-lokal angepasste Artefakte sowie getrennte Vorhersage- und Ausgabeausschlussmetriken. Überwachen Sie Ablehnungsgrund, Lückenalter, Muster, Regime und Modellversion – nicht nur den Auffüllungsanteil. Erhalten Sie Rohdaten und den ursprünglich bereitgestellten Merkmalsvektor, damit ein späterer Abgleich nicht rückwirkend das damalige Modellwissen verändert.
Prüfen Sie auch Neustarts. Stellen Sie entweder nachgewiesene Bestätigungszeiten mit passender Lebenszyklus- und Regelversion wieder her, oder beginnen Sie ohne Verfügbarkeit, bis neue Evidenz vorliegt. Stellen Sie niemals Werte wieder her und ersetzen dabei deren Zeitstempel durch den Prozessstart. Begrenzen Sie die Cache-Größe, entfernen Sie inaktive Anlagen und messen Sie die Latenz des Zustandsspeichers gegen die Inferenzfrist. Diese Kontrollen kosten Verfügbarkeit und Wartungsaufwand. Lockerere Regeln erzeugen mehr Ausgaben, aber nicht zwangsläufig bessere Entscheidungen.
Bringen Sie für einen Implementierungsreview eine Anlagenfamilie, eine beratende Vorhersageaufgabe und einen repräsentativen Ausfall-/Wiederverbindungsverlauf mit. Ich unterstütze Sie dabei, daraus einen Merkmalsgültigkeitsvertrag, eine ausführbare Fehlermatrix und Abnahmekriterien abzuleiten, die Ausgabeverzicht und Aufgabenfehler gemeinsam bewerten. Das erste Ergebnis sollte festlegen, welche fehlende Evidenz das Modell tolerieren darf – und welche Unsicherheit für den Betreiber sichtbar bleiben muss.