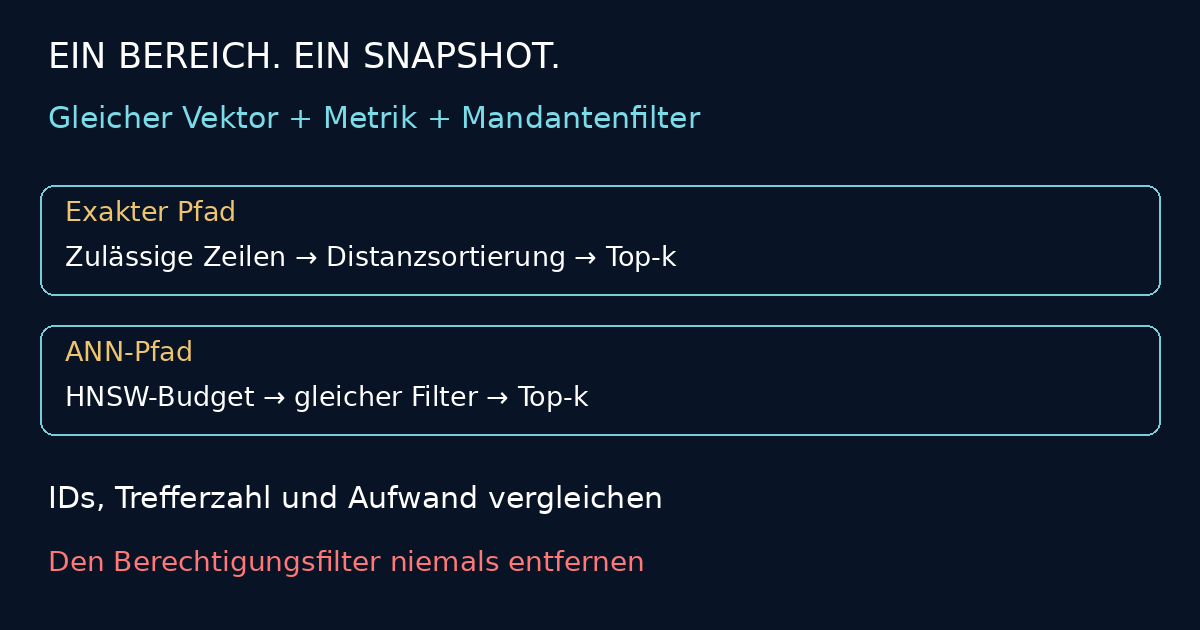
Eine gefilterte Vektorabfrage ohne Nachbarn beweist nicht, dass der zulässige Datenbestand leer ist. Vergleichen Sie die approximative Suche mit einer exakten Top-k-Abfrage unter identischem Pflichtfilter, identischer Distanzmetrik und demselben Datenbanksnapshot, bevor Sie Embeddings ändern. Im für diesen Artikel ausgeführten synthetischen Datenbanktest hatte ein Mandant 200 zulässige Vektoren: HNSW ohne iterative Scans lieferte keinen Treffer, die exakte Abfrage hingegen zehn. Iterative Suche fand diese zehn Nachbarn, erforderte aber mehr Arbeit. Entfernen Sie niemals den Mandantenfilter, um den Recall zu verbessern.
Trennen Sie drei unterschiedliche Fehler
Prüfen Sie zuerst, ob die Quelle existiert und für den Aufrufer sichtbar ist. Prüfen Sie anschließend, ob die approximative Suche deren nächste Nachbarn findet. Erst danach folgt die Frage, ob diese Nachbarn relevante Evidenz enthalten. Der Nachbar-Recall misst die Übereinstimmung mit der Vektordistanz-Rangfolge, nicht faktische Korrektheit, menschlich bewertete Relevanz oder Antwortqualität.
Die Mandantentrennung in RAG-Systemen definiert die Autorisierungsgrenze. Hier untersuchen wir Kandidatenverluste innerhalb eines unveränderten Geltungsbereichs, nicht dessen Sicherheit. Die hybride Suche für Teilenummern behandelt exakte Kennungen und die Kombination lexikalischer und semantischer Relevanz. Die Tokenbudget-Prüfung für Reranker untersucht Evidenzverluste nach der Kandidatensuche. Wenn Sie alle drei Schichten gleichzeitig umbauen, erschweren Sie die Ursachenanalyse.
Warum HNSW nach einem Filter zu wenig liefert
Die pgvector-Dokumentation unterscheidet exakte Suche und approximative Indizes. Bei approximativen Indizes wird die Filterung nach dem Indexscan angewendet. Eine begrenzte Kandidatensuche kann überwiegend Zeilen außerhalb des erforderlichen Geltungsbereichs finden. Ein vorhandener HNSW-Index garantiert deshalb nicht k verbleibende Zeilen. Ein höheres k erweitert auch nicht automatisch das nutzbare Suchbudget ausreichend.
Diese Ausführungsreihenfolge ist keine Erlaubnis, unautorisierte Kandidaten offenzulegen. Die Anwendung darf ausschließlich autorisierte Ergebnisse erhalten. Leiten Sie den Mandanten aus vertrauenswürdiger Identität ab, erhalten Sie sämtliche Berechtigungsprädikate in beiden Diagnoseabfragen und vermeiden Sie geschützte Kennungen in gewöhnlichen Logs. Prüfen Sie Row-Level Security separat mit der produktiven Anwendungsrolle; ein Superuser-Test kann sie nicht nachweisen.
Seit pgvector 0.8.0 können iterative Indexscans weitersuchen, bis ausreichend Ergebnisse vorliegen oder konfigurierte Grenzen erreicht sind. strict_order erhält bei HNSW die Distanzreihenfolge der zurückgegebenen Ergebnisse. Daraus wird weder eine vollständige exakte Suche noch eine Recall-Garantie von eins. Behandeln Sie ef_search, max_scan_tuples und scan_mem_multiplier als begrenzte Versuchsparameter, nicht als allgemeine Tuning-Empfehlung.
Ausgeführter Test und Aussagegrenzen
Der lokale Lauf verwendete PostgreSQL 18.6 und pgvector 0.8.1, Python 3.12.13 sowie psycopg 3.3.6. Er schrieb 20.000 synthetische Vektoren mit 16 Dimensionen. Python Random(71) erzeugte gleichverteilte Koordinaten zwischen minus eins und eins, auf sieben Nachkommastellen gerundet. Die Mandantenpopulationen waren bewusst ungleich: 10.000, 2.000, 200 und fünf Zeilen; der Rest gehörte einem fünften Mandanten. Ein zusätzlicher nicht vorhandener Mandant prüfte den leeren Geltungsbereich. Ein einzelner anschließend erzeugter Zufallsvektor diente als Anfrage; verwendet wurden L2-Distanz und k=10.
Der HNSW-Index wurde seriell mit m=16 und ef_construction=64 aufgebaut. Alle Vergleiche liefen in einer REPEATABLE-READ-Transaktion. Für die exakte Messung waren Index- und Bitmap-Scans deaktiviert; für die ANN-Messung sequenzielle und Bitmap-Scans. Eine Assertion prüfte, dass tatsächlich fixture_hnsw ausgeführt wurde. Diese Einstellungen isolieren die Mechanismen für die Diagnose. Übernehmen Sie erzwungene Planner-Einstellungen nicht unverändert in die Produktion. Automatische Prepared Statements waren im Diagnoseclient deaktiviert, damit Planwiederverwendung den Vergleich der Suchpfade nicht verfälschte.
Konfiguriert waren shared_buffers=128MB, work_mem=4MB, maintenance_work_mem=128MB für den Aufbau, keine parallelen Query-Worker, deaktiviertes JIT und ein Statement-Timeout von zehn Sekunden. Iterative Scans verwendeten max_scan_tuples=20000 und scan_mem_multiplier=1. Diese Grenzen sind weder Messwerte des gesamten Prozessspeichers noch eine Garantie, jeden Vektor zu besuchen. Pro Suchpfad gab es einen Aufwärmlauf und sieben Zeitmessungen. Die Tabelle zeigt den Median der lokalen Client-Rundläufe über einen Unix-Socket einschließlich Planung, keine produktive Tail-Latenz. EXPLAIN-ANALYZE-Pläne mit Buffer-Zählern wurden separat gespeichert.
| Zulässiger Bereich | E: Zeilen / Treffer / ms | A40: Zeilen / Treffer / ms | A200: Zeilen / Treffer / ms | I40: Zeilen / Treffer / ms |
|---|---|---|---|---|
| 10000 (50%) | 10 / 10/10 / 3.093 | 10 / 10/10 / 0.489 | 10 / 10/10 / 1.207 | 10 / 10/10 / 0.493 |
| 2000 (10%) | 10 / 10/10 / 1.538 | 7 / 7/10 / 0.475 | 10 / 10/10 / 1.366 | 10 / 10/10 / 1.100 |
| 200 (1%) | 10 / 10/10 / 1.439 | 0 / 0/10 / 0.511 | 0 / 0/10 / 2.436 | 10 / 10/10 / 6.752 |
| 5 (0.025%) | 5 / 5/5 / 1.186 | 0 / 0/5 / 0.456 | 0 / 0/5 / 1.168 | 5 / 5/5 / 61.997 |
| 0 (0%) | 0 / n/a / 1.196 | 0 / n/a / 0.523 | 0 / n/a / 1.330 | 0 / n/a / 61.554 |
Jede Zelle nennt zurückgegebene Zeilen, Übereinstimmung mit den exakten Nachbarn und mediane Millisekunden. E steht für den erzwungenen exakten Scan; A40 und A200 für HNSW mit ef_search 40 beziehungsweise 200 ohne iterative Scans; I40 für ef_search 40 mit iterativem strict_order. Der Nenner ist min(k, zulässige Zeilen), nicht immer zehn. Bei leerem Geltungsbereich ist Recall undefiniert, nicht perfekt oder fehlgeschlagen.
Bei 1 % zulässiger Population lieferte auch ef_search=200 in diesem Lauf keine Treffer. I40 fand zehn von zehn bei 6,752 ms; die exakte Suche benötigte 1,439 ms. Bei nur fünf zulässigen Zeilen fand die iterative Suche alle fünf, benötigte aber 61,997 ms gegenüber 1,186 ms für die exakte Suche. Das sind Beobachtungen einer kleinen synthetischen Anfrage und eines Graphaufbaus. Sie beweisen weder, dass exakte Suche grundsätzlich schneller ist, noch dass diese Parameter für produktive Embeddings geeignet sind.
Machen Sie die Referenz wirklich exakt und berechtigungsgleich
Verwenden Sie für beide Pfade dieselbe parametrisierte Anweisung: SELECT id, embedding <-> %s::vector AS distance FROM recall_fixture WHERE tenant=%s ORDER BY embedding <-> %s::vector LIMIT 10. Binden Sie an beiden Vektorpositionen denselben Anfragevektor und denselben vertrauenswürdigen Mandantenwert. Die Testverbindung verwendete prepare_threshold=None. Halten Sie Modellversion, Normalisierung und Metrik im Replay-Manifest fest; ein Wechsel von Cosinus zu L2 ist kein isolierter ANN-Vergleich.
Beginnen Sie eine REPEATABLE-READ-Transaktion, bevor Sie die zulässige Population zählen und die Suchpfade ausführen. Im isolierten Test ohne Metadatenindex ergaben SET LOCAL enable_indexscan=off und SET LOCAL enable_bitmapscan=off den exakten Plan Limit → Sort → Seq Scan. Aktivieren Sie anschließend Indexscans, deaktivieren Sie sequenzielle Scans ausschließlich für den kontrollierten ANN-Versuch, setzen Sie die HNSW-Budgets und wiederholen Sie dieselbe SELECT-Anweisung. Prüfen Sie EXPLAIN (ANALYZE, BUFFERS, FORMAT JSON) für jede Einstellung. EXPLAIN ANALYZE führt die Abfrage aus; berücksichtigen Sie diese Last.
Ein Plan aus einer anderen Verbindung oder einer separat rekonstruierten Anweisung genügt nicht als Nachweis. Parametertypen, Prepared Statements, Transaktionszustand und Planner-Einstellungen können den Pfad verändern. Unser erster Diagnoseversuch scheiterte nach automatischer Statement-Vorbereitung an einer Assertion; der gespeicherte erfolgreiche Test deaktiviert diese ausdrücklich. Produktive vorbereitete Abfragen sollten Sie dagegen in ihrer tatsächlich verwendeten Form mit repräsentativen Parameterverteilungen testen.
Berechnen Sie den Nachbar-Recall als Anzahl unterschiedlicher zurückgegebener IDs, die auch zur exakten Ergebnismenge gehören, geteilt durch deren Größe. Berichten Sie die Trefferzahl separat: Zehn approximative Zeilen können trotzdem die falschen zehn sein. Prüfen Sie Distanzgleichstände am Cutoff, bevor Sie gleichwertige alternative IDs als Fehler werten. Ein separat ausgeführter Zwei-Vektor-Test platzierte [1,0] und [-1,0] im gleichen L2-Abstand zu [0,0]. Ein beliebiger ID-Tie-Break wählt einen davon, ohne höhere Relevanz nachzuweisen. Definieren Sie eine Regel für Gleichstände oder vergleichen Sie die gesamte Grenzdistanzgruppe. Ergänzen Sie keine ID-Sortierung in der ANN-Abfrage, ohne den beabsichtigten Indexpfad erneut zu prüfen.
Lassen Sie den Planner nach der Diagnose wieder entscheiden
Ein zweiter ausgeführter Kontrollversuch ergänzte einen B-Tree auf tenant und stellte die gewöhnliche Scanauswahl wieder her. Für den Mandanten mit fünf Zeilen lautete der beobachtete Plan Limit → Sort → Index Scan auf fixture_tenant: weder HNSW noch ein unterstellter kombinierter B-Tree/HNSW-Pfad. Eine exakte Distanzsortierung nach selektiver Metadatensuche kann eine sinnvolle Alternative sein. Messen Sie sie mit Ihren Daten, Statistiken und Ihrer Parallelität.
Die PostgreSQL-Dokumentation zu mehrspaltigen Indizes beschreibt zugriffsmethodenspezifisches Verhalten. Sie belegt weder einen mehrspaltigen HNSW-Index aus Mandantenschlüssel und Vektor noch die automatische Kombination zweier vorhandener Indizes für Ihre sortierte Abfrage. Verwenden Sie die EXPLAIN-Dokumentation, um tatsächliche Zeilen, Filterung und Scanwahl zu untersuchen. Eine Indexdefinition ist kein Ausführungsnachweis.
| Beobachtung | Nächster kontrollierter Test | Kein zulässiger Schluss |
|---|---|---|
| Auch exakt fehlt Evidenz | Ingestion, Bereich und Relevanz prüfen | ANN allein verursacht den Fehler |
| Exakt erfolgreich, ANN zu kurz | Begrenzter iterativer Scan oder höheres Budget | Filter entfernen ist akzeptabel |
| Wenige zulässige Zeilen | Metadatenindex und exakte Distanzsortierung | HNSW muss schneller sein |
| Zehn Zeilen, geringe Überlappung | IDs und Distanzgleichstände vergleichen | Trefferzahl beweist Recall |
| Iterativer Scan zu teuer | Sucharbeit begrenzen oder exakt suchen | Mehr Arbeit ist immer gerechtfertigt |
Eine Freigabe-Checkliste über diesen kleinen Test hinaus
Fixieren Sie einen repräsentativen Anfragesatz, Datenbestandsrevision, Aufruferberechtigungen und Encoding-Vertrag. Berücksichtigen Sie große und kleine Mandanten, leere Bereiche, Populationen unter k, Distanzgleichstände, ungleich verteilte Metadaten, Löschungen und reale Berechtigungsbeschränkungen. Verwenden Sie mehrere Anfragen und wiederholte Indexaufbauten; gleichverteilte synthetische Vektoren bilden weder semantische Cluster noch produktive Dimensionen ab.
Messen Sie neben kontrollierten Pfaden immer den gewöhnlichen Planner-Pfad. Erfassen Sie exakten Nachbar-Recall, Trefferzahl, Latenzverteilungen, Timeouts und Ressourcenbedarf unter realistischer Parallelität. Dokumentieren Sie Aufwärmen, Cache-Zustand und EXPLAIN-Zusatzlast. Legen Sie workload-spezifische Recall- und Latenzschwellen fest, bevor Sie eine Konfiguration auswählen. Das größte Suchbudget ist nicht automatisch die beste Freigabeentscheidung.
Verlangen Sie unabhängige mandantenübergreifende Negativtests mit der realen Anwendungsrolle, einschließlich fehlendem Kontext, Berechtigungsänderungen und Caches. Dieser Test verwendet explizite Prädikate, aber keine RLS-Policy. Erfolgreiche Recall-Prüfungen zertifizieren keine Autorisierung. Ersetzen Sie ein leeres Ergebnis niemals durch einen ungefilterten Wiederholungsversuch. Protokollieren Sie zur Fehlererklärung keine geschützten Chunk-Inhalte.
Wählen Sie den nächsten Versuch statt vorschnell ein neues Modell
Fehlt die erwartete Evidenz auch bei exakter berechtigungsgleicher Suche, prüfen Sie Ingestion, Zulässigkeit, Embedding-Vertrag und bewertete Relevanz. Funktioniert die exakte Suche, während ANN scheitert, testen Sie zunächst begrenzte zusätzliche Sucharbeit oder einen exakt gefilterten Pfad. Verschwinden Kandidaten erst später, untersuchen Sie Reranking und Prompt-Zusammenstellung.
Bringen Sie für eine Prüfung Ihrer Retrieval-Zuverlässigkeit eine reproduzierbare fehlgeschlagene Anfrage, den autorisierten Geltungsbereich, die Indexdefinition, den tatsächlichen Plan und Ihr Latenzbudget mit. Ich unterstütze Sie dabei, daraus eine abgegrenzte Evaluation und eine belastbare Freigabeentscheidung zu entwickeln. Das Ergebnis sollte zeigen, wo Kandidaten verloren gehen – nicht lediglich mehr Treffer durch schwächere Zugriffskontrolle erzeugen.