BLUF — ein LLM-Lasttest kann gesund aussehen, weil sein Client bei einem langsamen Server weniger Arbeit anbietet. Prüfen Sie vor jeder Bewertung der Tail-Latenz das Ankunftsmodell, die Messgrenze und den Nenner der Kennzahlen. Halten Sie geplante Ankünfte, tatsächliche Sendestarts, Zulassungen, Abschlüsse und fehlende Ergebnisse auseinander. Ein Perzentil erfolgreicher Anfragen beschreibt keine Arbeit, die nie gesendet wurde.
Die Investitionsentscheidung lautet: Trägt die Bereitstellung die beabsichtigte Last? Sie lautet nicht: Kann ein begrenztes Client-Skript seine eigenen Anfragen abschließen? Dieser Beitrag prüft den Lastgenerator statt die Inferenzparameter. Er enthält einen ausgeführten lokalen HTTP-Lehrversuch, einen Messvertrag und eine Freigabecheckliste. Der Versuch verwendet künstliche Verzögerungen, keine GPU und kein Sprachmodell. Seine Zahlen sind keine Schätzung der Inferenzkapazität.
Die Rückkopplung, die Überlast verdeckt
Ein Closed-Loop-Client wartet auf eine Antwort, bevor derselbe Worker die nächste Anfrage sendet. Bei einer festen Worker-Anzahl reduzieren längere Antworten die folgenden Ankünfte. Für bestimmte begrenzte Nutzerabläufe ist das korrekt: Ein Nutzer wartet tatsächlich auf eine Antwort, bevor er weiterfragt. Für unabhängig eintreffende neue Nutzer oder Aufträge ist dieses Modell irreführend, wenn deren Ankünfte während einer Verlangsamung weitergehen.
Die wrk2-Methodik erläutert Coordinated Omission und misst Antwortlatenz relativ zum beabsichtigten Sendezeitpunkt statt ausschließlich zum tatsächlichen Sendestart. Der konstante Lastansatz ist eine geeignete methodische Referenz. Er ist kein fertiger LLM-Tokenstream-Benchmark. Eine Histogrammkorrektur rekonstruiert weder abgewiesene Anfragen noch fehlende Ankünfte oder Antwortqualität.
Unser SLO-Rahmen für Inferenz definiert die Serviceziele. Hier kommt die Frage hinzu, ob der Test diese Ziele mit der zugesagten Ankunftslast überhaupt belastet. Eine präzise Uhr an einem ungeeigneten Verkehrsmodell liefert weiterhin ein ungeeignetes Ergebnis.
Den Zeitplan vom Antwortzyklus trennen
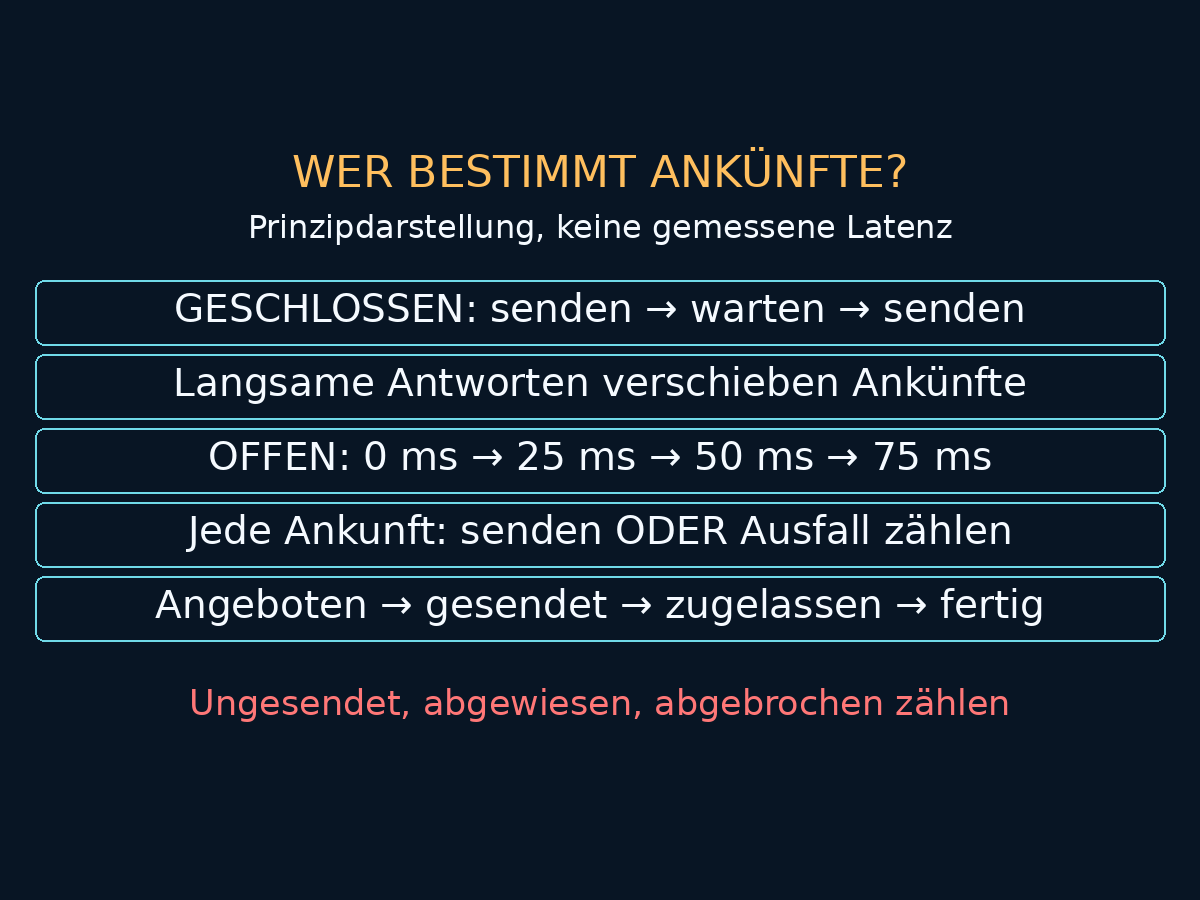
Die Zeitleiste ist ein konzeptioneller Vergleich, kein Diagramm gemessener Tokenzeiten. Beim geschlossenen Worker hängt die nächste Ankunft vom vorangehenden Abschluss ab. Ein offener Zeitplan legt Ankünfte unabhängig fest. Jeder geplante Eintrag muss entweder eine gesendete Anfrage oder ein ausdrücklich dokumentiertes ungesendetes Ergebnis werden. Er darf nicht verschwinden, nur weil ein Semaphore-Limit erreicht wurde.
Grafanas Dokumentation zur Arrival-Rate-Allokation benennt diese Generatorgrenze: Eine Iteration benötigt einen freien virtuellen Nutzer; unzureichende Allokation erzeugt dropped_iterations. Die Iterationsrate entspricht nur dann der Anfragerate, wenn die Anfrageanzahl pro Iteration dazu passt. Eine dynamische Erweiterung der virtuellen Nutzer kostet zudem CPU und Speicher und kann den Test beeinflussen.
Wählen Sie das Ankunftsmodell anhand des Geschäftsablaufs. Unabhängige Aufträge sprechen für einen offenen Zeitplan; eine begrenzte Anzahl dialogführender Nutzer kann ein geschlossenes oder sitzungsbezogenes Modell mit Denkzeit rechtfertigen. Prüfen Sie beide, wenn beide vorkommen. Ohne passende Promptlängen, Ausgabelängen, Wiederholungen, Caches und Anfrageklassen ist keines automatisch repräsentativ.
Ein ausgeführter Versuch mit langsamem Endpunkt
Die lokale Python-Testfixture verwendet ausschließlich die Standardbibliothek und betreibt einen echten Loopback-HTTP-Server mit asynchronen Clients. Der Server besitzt zwei Bearbeitungsplätze und lässt höchstens acht ausstehende Anfragen einschließlich laufender Arbeit zu. Weitere Anfragen erhalten HTTP 503. Beim Bearbeitungsstart beträgt die künstliche Wartezeit normalerweise 40 Millisekunden. Beginnt die Bearbeitung zwischen der ersten und dritten Sekunde, beträgt sie 400 Millisekunden. Danach folgt ein erstes Body-Byte und nach weiteren 10 Millisekunden ein zweites. Das sind synthetische Inhaltsmarkierungen, keine Modelltoken.
Jeder Lauf hat ein Ankunftsfenster von vier Sekunden und höchstens zwei Sekunden Nachlauf. Der offene Zeitplan sieht 160 Ankünfte mit 40 Anfragen pro Sekunde vor. Der geschlossene Fall besitzt zwei sequenzielle Worker und kein unabhängiges Ankunftsziel. Im dritten Fall bleibt der offene Zeitplan gleich, doch der Client lässt nur zwei gleichzeitige Anfragen zu. Überschüssige Ankünfte werden als unsent_client_cap erfasst. Die Fixture speichert ein Ereignisprotokoll je Lauf und prüft, dass nach dem Nachlauf kein Eintrag im Zustand pending verbleibt.
| Beobachteter Lauf | Angeboten / gesendet | Zugelassen / abgeschlossen | Abgewiesen / ungesendet |
|---|---|---|---|
| Geschlossen, zwei Worker | 86 / 86 | 86 / 86 | 0 / 0 |
| Offen, Client-Limit 64 | 160 / 160 | 91 / 91 | 69 / 0 |
| Offen, Client-Limit 2 | 160 / 60 | 60 / 60 | 0 / 100 |
Dies sind tatsächliche Zählwerte einer lokalen Ausführung, keine simulierten Produktionsergebnisse. Während der Verlangsamung sendete der geschlossene Lauf 10 Anfragen, der ausreichend dimensionierte offene Lauf dagegen 80. Der begrenzte offene Client sendete in diesem Intervall ebenfalls nur 10; sein Protokoll bewahrte jedoch die unterdrückten Ankünfte. Die genauen Zählwerte hängen vom Host-Scheduling ab. Null Abweisungen im geschlossenen Lauf beweisen keine gleichwertige Kapazität: Er bot eine andere Last an.
Eine beispielhafte Latenzgrenze von 250 Millisekunden zwischen geplanter Ankunft und Abschluss erfüllten 76, 75 beziehungsweise 50 Antworten. Bezogen auf das feste viersekündige Ankunftsfenster ergeben sich 19,0, 18,75 und 12,5 latenzqualifizierte Antworten pro Sekunde. Dies ist kohortenbezogener latenzqualifizierter Durchsatz einschließlich Abschlüssen im Nachlauf, kein vollständiger LLM-Goodput: Ein fachlicher Qualitätsvalidator fehlt. In dieser Ausführung wurde keine Anfrage abgebrochen. Der Abbruchpfad ist vorhanden, aber durch diesen Lauf nicht validiert. Aus diesen kurzen Stichproben wird keine p99-Aussage abgeleitet.
Zur Reproduktion implementieren Sie die genannten Servergrenzen und den Verzögerungsplan. Starten Sie für jeden Fall einen neuen Server, erzeugen Sie offene Ankünfte aus einem unveränderlichen Index/Rate-Zeitplan, protokollieren Sie auch fehlende Client-Plätze und begrenzen Sie den Nachlauf. Bewahren Sie das vollständige Protokoll statt nur der Summen auf. Die ausgeführte Fixture und das Protokoll liegen als technische Evidenz dieses Beitrags vor; die Spezifikation bleibt bewusst unabhängig von einem Inferenzanbieter.
Erst den Messvertrag festlegen, dann Perzentile berechnen
Verwenden Sie für Zeitdauern eine monotone Uhr. Erfassen Sie geplante Ankunft, Sendestart, Zulassung, ersten nutzbaren Inhalt, Abschluss oder Abbruch und Endzustand. Die lokale Fixture kann dieselbe Uhr nutzen, weil Client und Server im selben Prozess laufen. Subtrahieren Sie über Hostgrenzen keine unabhängigen monotonen Uhren. Verwenden Sie lokale Dauern mit Korrelationskennungen oder ein dokumentiertes Synchronisations- und Fehlerbudget für hostübergreifende Zeitstempelvergleiche.
| Messgröße | Messgrenze | Beantwortete Frage |
|---|---|---|
| Scheduling-Verzögerung | Sendestart minus geplante Ankunft | Hält der Generator den Zeitplan ein? |
| Client-TTFT | Erstes nutzbares Token minus Sendestart | Wie lange wartet die gesendete Anfrage? |
| Ankunft bis erstes Token | Erstes nutzbares Token minus geplante Ankunft | Was erlebt die beabsichtigte Ankunft? |
| Abschlusslatenz | Abschluss minus Sendestart | Wie lange dauert die übertragene Anfrage? |
| Ankunft bis Abschluss | Abschluss minus geplante Ankunft | Verschwindet Generatorverzögerung aus dem Ergebnis? |
Die Zulassung ist ein separates Server- oder Gateway-Ereignis, nicht automatisch der Sendestart oder der Empfang von HTTP-Headern. Ist sie nicht beobachtbar, kennzeichnen Sie sie als nicht verfügbar. Erfinden Sie keine Aufteilung der Wartezeit durch Subtraktion inkompatibler Telemetrie. Definieren Sie bei einer Streaming-API, ob TTFT ab Planung, Sendestart, Gateway-Annahme oder einer anderen Grenze gilt. Nennen Sie diese Grenze neben dem Wert.
Ungesendete, abgewiesene, transportseitig fehlgeschlagene, abgebrochene und unbeendete Anfragen gehören nicht in die Verteilung erfolgreicher Latenzen, wohl aber in das Ergebnisprotokoll und den jeweiligen Nenner. Erfassen Sie am Ende des Beobachtungsfensters ausstehende Anfragen und deren Alter; dokumentieren Sie beim Nachlaufende zensierte Arbeit. Ein Timeout liefert eine Untergrenze der Wartezeit, keinen gemessenen erfolgreichen Abschluss. Abweisungen haben eine eigene Antwortlatenz. Vermischen Sie diese nicht mit erfolgreicher Generierung, um den Dienst schneller erscheinen zu lassen.
Ein Streaming-Werkzeug pinnen und seine Lastsemantik prüfen
Die untersuchte AIPerf-Version ist v0.13.0. Ihre versionierte Dokumentation der Ankunftsmuster unterstützt Request-Rate-Betrieb und ein ausdrücklich konstantes Muster; dokumentierter Standard ist Poisson. Der Vertrag für Rate plus Parallelitätsgrenze beschreibt Sleep-then-Gate-Verhalten ohne Aufholen. Eine konfigurierte Rate mit enger Parallelitätsgrenze beweist deshalb nicht, dass alle vorgesehenen Anfragen den Endpunkt erreichten.
Eine Befehlsvorlage für einen isolierten, bereits laufenden kompatiblen Chat-Endpunkt lautet: aiperf profile --model "$MODEL" --url "$ENDPOINT" --endpoint-type chat --streaming --request-rate 40 --arrival-pattern constant --benchmark-duration 60 --output-artifact-dir results/constant. Installieren Sie das gepinnte Paket aiperf==0.13.0 in einer geeigneten isolierten Umgebung und prüfen Sie vorab aiperf profile --help. Die Vorlage wurde anhand der versionierten Dokumentation geprüft, hier jedoch nicht gegen ein Modell ausgeführt. Ohne festen Workload-, Aufwärm-, Timeout- und Nachlaufvertrag ist sie kein vollständiger Abnahmebenchmark.
Fixieren Sie Serving-Image-Digest, Modell- und Tokenizer-Revisionen, Promptkorpus, Tokenlängenverteilung, Chatvorlage, Ausgabegrenzen, Cache-Regeln, Streaming-Parser und Klassenmix. Eine Ausgabeobergrenze garantiert keine gleichen tatsächlichen Ausgabelängen. Ein Netzwerkchunk ist nicht zwingend ein Token. Das erste empfangene Byte kann zu Headern oder einem leeren Protokollereignis gehören. Validieren Sie den Parser mit bekannten Streaming-Testfällen, bevor Sie eine Messgröße TTFT nennen.
Bewahren Sie Anfrageeinzelwerte oder gleichwertige verknüpfte Evidenz auf, mit der Zeitplan, Sendestarts und Ergebnisse abgeglichen werden können. Unterstellen Sie nicht, dass ein Werkzeugexport alle hier geforderten Zeitstempel enthält: Prüfen Sie sein Schema. Wenn geplante, aber ungesendete Arbeit nicht nachvollziehbar ist, belegt dieser Lauf keine Kapazität für die angebotene Last. Ein CPU- oder Connection-Pool-Engpass des Generators ist ein Befund zur Testgültigkeit, nicht zur Serverleistung.
Entscheidungstabelle für die Benchmark-Abnahme
| Beobachtung | Entscheidung | Erforderlicher nächster Schritt |
|---|---|---|
| Tail-Latenz sinkt, Sendemenge ebenfalls | Kapazitätsaussage ablehnen | Geplante Ankünfte und Client-Grenzen abgleichen |
| Alle Ankünfte gesendet; mehr 503 | Zulassungsüberlast ist sichtbar | Zugelassen/angeboten berichten; Kapazität oder Regeln prüfen |
| Scheduling-Verzug des Clients wächst | Test ist generatorbegrenzt | Generatorreserve erhöhen; gleiche Last erneut prüfen |
| Mehr Abschlüsse, kürzere Ausgaben | Vergleich ist verzerrt | Gleiche Längen- und Qualitätssegmente vergleichen |
| Anfragen bleiben beim Nachlaufende offen | Fehlende Ergebnisse sind relevant | Zensierte Anzahl und Alter berichten; nicht entfernen |
| Latenz und Qualität bestehen bei Ziellast | Kandidat, keine allgemeine Kapazitätsgarantie | Je Klasse wiederholen und Erholungsreserve prüfen |
Erst nach dieser Generatorprüfung sollten Sie das Prefill-Scheduling bei gemischter Last optimieren. Sonst erscheinen eine Scheduler-Änderung und eine abgeschwächte Eingangslast als dieselbe Verbesserung. Halten Sie die Qualitätsgrenze des Model Routings unverändert: Der Wechsel zu einem schwächeren Modell ist keine reine Latenzoptimierung.
Abnahmecheckliste für Streaming-Benchmarks
Prüfung 1 — Last: Benennen Sie Nutzerablauf, Ankunftsprozess, Anfrageklassen, Ein- und Ausgabeverteilung, Cache-Zustand und Wiederholungsregeln. Fixieren Sie das Vergleichsmanifest. Kennzeichnen Sie nicht unterstützte Fälle als ungültig, nicht als bestanden.
Prüfung 2 — Generator: Gleichen Sie angebotene, gesendete und ungesendete Anfragen ab. Prüfen Sie Sendestartverzug, Client-CPU, Verbindungsgrenzen und Protokollfehler. Definieren Sie Toleranzen vor dem Lauf. Bewahren Sie Evidenz für Normalbetrieb und gezielte Verlangsamung auf.
Prüfung 3 — Ergebnisse: Berichten Sie die Anteile zugelassen/angeboten und abgeschlossen/zugelassen neben Latenzverteilungen und Stichprobengrößen. Definieren Sie Goodput als fachlich gültige Antworten, die alle Latenzgrenzen ihrer Klasse erfüllen, geteilt durch das feste Beobachtungsfenster; Ankunftskohorte und Nachlauf müssen ausdrücklich geregelt sein. Zählen Sie Wiederholungen als weitere Versuche, nicht als neue Nutzernachfrage.
Prüfung 4 — Streaming: Trennen Sie HTTP-Header, nutzbaren Inhalt, Tokenereignisse und Netzwerkchunks. Bewahren Sie Parserversion, Abbruchsemantik und maximale Unterbrechungen auf. Ein schnelles erstes Token garantiert keinen nutzbaren Abschluss.
Prüfung 5 — Freigabe: Wiederholen Sie Läufe, zeigen Sie Streuung, erproben Sie Timeout und Nachlauf und halten Sie eine Baseline für den Rollback bereit. Die kurze Lehrfixture demonstriert Auslassung. Sie rechtfertigt weder Produktionsperzentile noch einen GPU-Kauf oder eine Durchsatzgarantie.
Bringen Sie für eine Prüfung der Benchmark-Gültigkeit das Serving-Manifest, einen bereinigten Lasttrace und das rohe Zeitschema des Generators mit. Das Ergebnis sollte eine belastbare Entscheidung sein: akzeptieren, erneut testen oder neu dimensionieren — bevor ein Perzentil, das die beabsichtigte Last nie gesehen hat, Infrastrukturkosten begründet.