BLUF: Eine Anlage ohne dokumentierten Ausfall ist nicht automatisch ein gesunder Negativfall. Endet die Beobachtung vor dem Bewertungshorizont, ist ihr Ergebnis unvollständig. Bewahren Sie Beobachtungsdauer, Ereignisindikator und Abbruchgrund auf. Wählen Sie ein Bewertungsverfahren, dessen Zensierungsannahmen zum Wartungsprozess passen. Ein Überlebensmodell repariert weder fehlende Komponentenidentitäten noch beweist es, dass ein vorbeugender Austausch unnötig war.
Das Ergebnis ist ein prüfbarer Ereignis- oder Zensierungsvertrag mit einem durch Daten gestützten Bewertungshorizont – kein eindrucksvollerer Genauigkeitswert. Dieser Beitrag konkretisiert die offene Ergebnisgrenze aus den Backtests für Predictive Maintenance. Behalten Sie deren Trennung nach Anlagengruppen und Zeit bei. Eine andere Ergebnisrepräsentation macht zufällige Aufteilungen von Sensorfenstern nicht zulässig.
Definieren Sie zuerst Entscheidung und Zeitachse
Wählen Sie eine Komponentenklasse, eine Ausfalldefinition und einen Zeitursprung. Ein Beispiel ist die Zeit vom Lagereinbau bis zum bestätigten Lagerausfall in Kalendertagen. Betriebsstunden können die passendere Exposition sein, allerdings nur bei bereinigten Zählerwechseln, Stillständen und fehlenden Messwerten. Vermischen Sie Kalendertage und Betriebsstunden nicht in einem Dauerfeld.
Eine Lebensdauerprognose ab Einbau ist etwas anderes als eine laufende Prognose für das nächste Wartungsfenster. Für wiederholte Entscheidungen benötigen Sie einen ausdrücklich definierten Landmark- oder zeitvariablen Ansatz mit den zum Entscheidungszeitpunkt verfügbaren Merkmalen. Hängen Sie keine Sensorzusammenfassung vom Lebensende an einen Datensatz zum Einbauzeitpunkt. Wiederholte Landmarks derselben Maschine bleiben abhängige Beobachtungen.
Die Einführung von scikit-survival repräsentiert rechtszensierte Ergebnisse durch beobachtete Zeit und booleschen Ereignisindikator. Die beobachtete Zeit ist der frühere Zeitpunkt von Ausfall und Zensierung. Ein falscher Ereignisindikator bedeutet, dass die Ausfallzeit jenseits dieses Punktes unbeobachtet ist – nicht, dass die Komponente niemals ausfällt.
Implementieren Sie einen Lebenszyklusvertrag für Labels
Verwenden Sie eine stabile übergeordnete Anlagen-ID und nach jedem Austausch eine eigene Komponentenlebens-ID. Speichern Sie Ursprung, Beobachtungseintritt, Beobachtungsende, gegebenenfalls Ausfallzeit, Ereignisdefinition und Version, Zensierungsgrund, Quelldatensatz-IDs, Verfügbarkeitszeitpunkt des Labels und Datenstand. Dies sind vorgeschlagene technische Felder, keine vorgeschriebenen Bibliotheksspalten.
Validieren Sie Ursprung ≤ Eintritt < Ende. Ein bestätigter Zielausfall muss diesen Datensatz zum ersten Ereignis abschließen und darf keinen Zensierungsgrund haben. Ein zensierter Datensatz benötigt einen dokumentierten Grund und darf im beobachteten Intervall keinen Zielausfall enthalten. Isolieren Sie widersprüchliche CMMS-Abschlusscodes, statt stillschweigend einen Wert auszuwählen. Unbekannter Ursprung, ungeklärte Identität oder unterbrochene Ergebniserfassung verhindern bis zur Klärung eine gewöhnliche Lebensdauerinterpretation.
Bewahren Sie zusätzlich auf, wann das Label verfügbar wurde. Ein Ausfall am Montag, der am Freitag gemeldet wird, ist eine verzögerte Meldung: Sie begrenzt, welcher historische Modellstand die Diagnose verwenden durfte. Ein vor Beobachtungsbeginn eingebautes Lager hat dagegen einen verzögerten Eintritt: Dieser verändert die zulässigen Risikomengen. Den Ursprung auf die Aufnahme in den Datenbestand zu verschieben, verbirgt nur das vorherige Alter und verändert die Prognosefrage.
Die lifelines-Dokumentation zu univariaten Modellen unterstützt entry für linksabgeschnittene Beobachtungen. Die Dauer läuft weiterhin vom ursprünglichen Ursprung, nicht vom Eintritt. Prüfen Sie auch die Auswahl in die Beobachtung: Ein Eintrittsargument korrigiert allein keinen unbekannten, zustandsabhängigen Aufnahmeprozess.
Zeitachse: Beobachtung ist nicht Lebensdauer
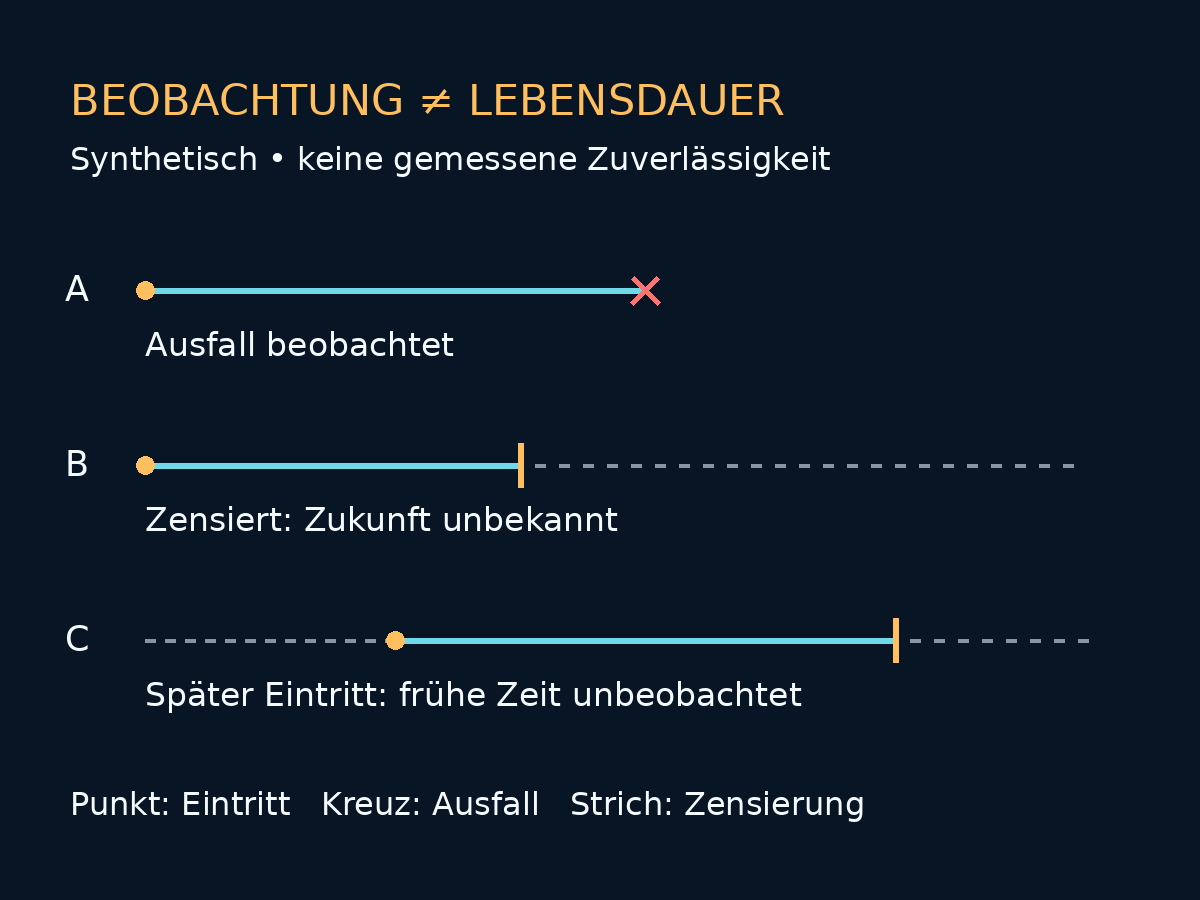
Die Grafik zeigt einen synthetischen Lebenszyklus, keine gemessene Zuverlässigkeit. Durchgezogene Abschnitte kennzeichnen Beobachtung; ein Kreuz markiert einen beobachteten Ausfall, ein senkrechter Strich das Beobachtungsende ohne beobachteten Ausfall. Das gestrichelte Intervall vor Eintritt darf nicht als gewöhnliche beobachtete Risikozeit eingehen. Die gestrichelte Fortsetzung nach Zensierung ist unbekannt, kein bestätigtes Überleben.
Entscheiden Sie, was das Beobachtungsende bedeutet
| Endpunkt | Repräsentation | Erforderliche Prüfung |
|---|---|---|
| Fester Datenstichtag | Rechtszensierung zum letzten gesicherten ausfallfreien Zeitpunkt | Administrative Terminierung beweist keine Unabhängigkeit; Einbaukohorten und Betriebszustände prüfen |
| Vertrag oder Telemetrieabdeckung endet | Zensierung nur bei bis dahin gültiger Ergebniserfassung | Prüfen, ob schlechter Zustand oder eine Servicepolitik den Abbruch erklären |
| Vorbeugender Austausch | Intervention oder konkurrierendes Ereignis, abhängig von der Zielgröße | Zuverlässigkeits- und Statistikprüfung vor Annahme unabhängiger Zensierung |
| Bestätigter Zielausfall | Ereignis zur bestätigten Ausfallzeit | Ereignisdefinition und Komponentenlebens-ID prüfen |
| Ausfall nur zwischen Inspektionen bekannt | Intervallzensiertes Ergebnis | Keine exakte Ausfallzeit erfinden oder gewöhnliche Rechtszensierungs-API unverändert verwenden |
Eine Sensorlücke ist nicht automatisch ein Zensierungsereignis, wenn unabhängige Wartungsunterlagen das Ergebnis weiterhin belegen. Umgekehrt beweist ein fortlaufender Sensorstrom keine vollständige Ausfallerfassung. Bestimmen Sie die letzte belastbare ausfallfreie Beobachtung anhand des tatsächlichen Erfassungsprozesses.
Vorbeugender Austausch ist der schwierige Fall. Entfernen Techniker Komponenten wegen erkennbarer Ausfallnähe, sind die entfernten Einheiten keine austauschbare Stichprobe der verbleibenden Komponenten. Eine naive Annahme unabhängiger Zensierung kann falsch sein. Geht es um die Wahrscheinlichkeit eines Zielausfalls vor Austausch unter der aktuellen Politik, kann Austausch ein konkurrierendes Ereignis sein; eins minus Kaplan–Meier ist dann nicht die entsprechende kumulative Inzidenz. Geht es um den Ausfall ohne Austausch, ist dies eine kontrafaktische Frage mit stärkeren Annahmen und fachlichem Prüfbedarf. Austausch als Zensierung zu bezeichnen, identifiziert diese Antwort nicht.
Reproduzieren Sie den Label-Fehler mit einem kleinen Testdatensatz
Sechs synthetische Komponentenleben beginnen an Tag null. A fällt an Tag 2 aus, B wird an Tag 3 administrativ zensiert, C fällt an Tag 4 aus, D wird an Tag 6 zensiert, E fällt an Tag 8 aus und F wird an Tag 10 zensiert. Bewertet wird Ausfall bis Tag 5. Dieser bewusst kleine Datensatz prüft Rechenweg und Label-Verarbeitung. Er ist weder Werksbenchmark noch Modellbewertung noch Beleg unabhängiger Zensierung im Betrieb.
Wer jedes ungeklärte Ergebnis als Nichtausfall kodiert, erhält 2/6 beziehungsweise 33,33 % Ausfallrisiko. Wer das früh zensierte B entfernt, erhält einen Complete-Case-Anteil von 2/5 beziehungsweise 40 %. Unter der illustrativen Annahme unabhängiger Zensierung verwendet Kaplan–Meier dagegen sechs Einheiten unter Risiko an Tag 2 und vier an Tag 4. Das geschätzte Überleben beträgt (5/6) × (3/4) = 5/8; daraus folgen 37,5 % Ausfallrisiko bis Tag 5. Keiner dieser Werte offenbart die unbeobachtete Zukunft von B.
Der folgende Python-Test ohne Zusatzbibliotheken wurde für diesen Beitrag ausgeführt. event=False bedeutet zensiert; die Dauer ist der beobachtete Endpunkt. Der minimale Validator verwirft doppelte Komponentenleben, unmögliche Eintrittsreihenfolgen, widersprüchliche Ereignis-Grund-Paare und vorbeugenden Austausch mit Prüfbedarf. Ein produktiver Validator benötigt zusätzlich die oben erläuterten Herkunfts-, Verfügbarkeits- und Kontinuitätsprüfungen.
from fractions import Fraction as Ffrom math import prod# ID, origin, entry, end, event, reasonrows = [('A', 0, 0, 2, True, None),('B', 0, 0, 3, False, 'cutoff'),('C', 0, 0, 4, True, None),('D', 0, 0, 6, False, 'cutoff'),('E', 0, 0, 8, True, None),('F', 0, 0, 10, False, 'cutoff'),]assert len({r[0] for r in rows}) == len(rows)assert all(r[1] <= r[2] < r[3] for r in rows)assert all((r[4] and r[5] is None) or(not r[4] and r[5] == 'cutoff')for r in rows)# Other reasons require review, not silent acceptance.h = 5failed = lambda r: r[4] and r[3] <= hnaive = F(sum(map(failed, rows)), len(rows))known = [r for r in rows if failed(r) or r[3] >= h]complete = F(sum(map(failed, known)), len(known))times = sorted({r[3] for r in rows if failed(r)})risk = lambda t: sum(r[2] < t <= r[3] for r in rows)events = lambda t: sum(r[4] and r[3] == t for r in rows)survival = prod(F(risk(t)-events(t), risk(t)) for t in times)assert (naive, complete, 1-survival) == (F(1,3), F(2,5), F(3,8))print(float(naive), float(complete), float(1-survival))
Der Lauf lieferte naive=0.3333333333333333, complete_case=0.4 und km=0.375. Vier absichtlich ungültige Label-Testfälle wurden im lokalen Testgerüst verworfen. Das Rechenbeispiel enthält weder verzögerten Eintritt noch wiederkehrende Ausfälle oder zeitgleiche Ausfall- und Zensierungsereignisse. Verwenden Sie dafür eine geprüfte Survival-Bibliothek, statt die Lehrschleife zum produktiven Schätzer auszubauen.
Kaplan–Meier ist eine Basislinie, keine annahmenfreie Korrektur. Erforderlich ist eine vertretbare Interpretation unabhängiger Zensierung für die betrachtete Population oder ihre Schichten. Zeigen Sie bei einer realen Kurve Konfidenzintervalle und Anzahlen unter Risiko. Bei kurzer Nachbeobachtung kann ein flaches Kurvenende eine ausgedünnte Risikomenge statt zuverlässiger Maschinen widerspiegeln. Leiten Sie keine Wartungsaussage jenseits der gestützten Beobachtung ab.
Ordnen Sie die Kennzahl der Wartungsfrage zu
| Frage | Mögliche Kennzahl | Grenze |
|---|---|---|
| Ordnet das Risiko frühere Ausfälle höher ein? | Konkordanz; IPCW-Konkordanz erwägen | Harrell-Konkordanz kann bei starker Zensierung optimistisch sein; keine horizontbezogene Wahrscheinlichkeitsprüfung |
| Lassen sich Ausfälle bis zum gewählten Horizont unterscheiden? | Kumulative/dynamische AUC | Benötigt gestützte Zeiten, Ereignis- und Kontrollzahlen sowie ein vertretbares Zensierungsmodell |
| Sind prognostizierte Überlebenswahrscheinlichkeiten brauchbar? | Zeitabhängiger Brier-Score | Misst Wahrscheinlichkeitsfehler, nicht nur Kalibrierung; Überlebenswahrscheinlichkeiten statt beliebiger Risikoscores einsetzen |
| Wie verändert sich der Wahrscheinlichkeitsfehler im Zeitfenster? | Integrierter Brier-Score | Integrationsintervall und Gewichtung angeben; unterschiedliche Intervalle sind nicht direkt vergleichbar |
Der Bewertungsleitfaden von scikit-survival erläutert diese Unterschiede und die inverse Zensierungswahrscheinlichkeitsgewichtung der entsprechenden Implementierungen. IPCW behebt nicht jede informative Intervention. Marginale Zensierungsgewichte können unzureichend sein, wenn Zensierung von prognostischen Kovariaten abhängt.
Fixieren Sie Bewertungshorizonte vor dem Modellvergleich. Schätzen Sie die Zensierungsverteilung gemäß API aus Trainingsdaten; halten Sie Labels und angepasste Transformationen innerhalb des bestehenden zeitlichen Evaluationsdesigns. Prüfen Sie die Abdeckung in Trainings- und Testnachbeobachtung. Wo Gewichte benötigt werden, muss das geschätzte Überleben der Zensierungszeit positiv sein. Nahe null entstehen instabile Gewichte, bevor eine API zwingend einen Fehler ausgibt. Berichten Sie Ereigniszahlen, Zensierungsgründe, Risikomengengröße und Ausschlüsse neben der Kennzahl. Verkürzen Sie den gestützten Horizont oder melden Sie unzureichende Evidenz, statt schwierige Fälle stillschweigend zu entfernen.
Schätzung und Bewertung bei verzögertem Eintritt sind getrennte Fähigkeiten. Ein Kaplan–Meier-Fitter mit entry belegt nicht, dass jede nachgelagerte Kennzahl Linksabschneidung unterstützt. Das übliche Ereignis-Zeit-Paar enthält keine Eintrittsinformation. Prüfen Sie die konkreten Schätzer- und Kennzahl-APIs oder entwickeln Sie vor der Bewertung linksabgeschnittener Daten mit statistischer Unterstützung eine begründete bedingte Landmark-Kohorte.
Freigabecheckliste und betriebliche Grenzen
1. Die Zuverlässigkeitsverantwortlichen bestätigen Komponentenlebensgrenze, Ereignisdefinition und Expositionsuhr. Austausch darf die vorherige Lebens-ID nicht wiederverwenden.
2. Data Engineering belegt Ergebnisabdeckung, Label-Verfügbarkeit und die Zurückweisung unmöglicher oder widersprüchlicher Datensätze.
3. Die statistische Prüfung dokumentiert Zensierungs-, Eintritts- und Interventionsannahmen. Vorbeugende Wechsel bleiben separat sichtbar.
4. Die Evaluation fixiert gestützte Horizonte, Modellprognosen und Zensierungsschätzung. Der Bericht enthält Nenner und Unsicherheit statt nur Ranglistenwerte.
5. Der Betrieb prüft die Warnpolitik separat durch Alarmrationalisierung. Bessere Wahrscheinlichkeitsschätzungen belegen weder eine ausführbare Reaktion noch eine akzeptable Alarmbelastung.
Genauere Labels erhöhen Implementierungs- und Prüfaufwand. Anlagengruppierung und kürzere Horizonte können zu wenige Ausfälle für einen Modellvergleich übrig lassen. Eine Überlebenskurve beweist keine vermiedenen Stillstände, rechtfertigt keinen automatischen Anlagenstopp und schätzt nicht den kausalen Wartungsnutzen. Bewahren Sie die menschliche Freigabegrenze aus der Predictive-Maintenance-Architektur.
Beginnen Sie mit einer Ergebnisprüfung
Bringen Sie eine Komponentenklasse, zeitgestempelte Einbauten und Wechsel, Ausfalldefinitionen und den CMMS-Ergebnisexport mit. Ich unterstütze Sie dabei, diese Unterlagen in einen versionierten Label-Vertrag, absichtlich fehlschlagende Validierungstests und einen Bericht zur Horizontabdeckung zu überführen. Tragen Nachbeobachtung oder Interventionshistorie die geplante Entscheidung nicht, ist bessere Ergebniserfassung die nächste sinnvolle Investition – kein komplexeres Modell.