Ein Quellenverweis kann das richtige Handbuch öffnen und trotzdem den falschen Satz markieren. Binden Sie jedes Zitat an eine unveränderliche Quellrevision, eine versionierte extrahierte Textdarstellung und ein ausdrücklich benanntes Koordinatensystem. Prüfen Sie Zitat und unmittelbaren Kontext, bevor Sie eine Markierung anzeigen. Widersprechen sich diese Prüfungen, bleibt das Zitat unaufgelöst. Wählen Sie nicht den ersten plausiblen Treffer. Damit prüfen Sie die Integrität der Fundstelle – weder die inhaltliche Begründung der Antwort noch die Zugriffsberechtigung.
Diese Grenze wird relevant, wenn ein Parser-Upgrade Leerraum verändert, der Browser UTF-16-Codeeinheiten zählt, das Backend jedoch Unicode-Codepunkte verwendet oder dieselbe Überschrift mehrfach vorkommt. Weiteres Retrieval-Tuning repariert diesen Schnittstellenvertrag nicht. Entscheidend ist, ob Ihr Belegviewer nach einer Änderung der Aufbereitung nachweisen kann, welche Passage er angezeigt hat, statt nur einen überzeugenden Dokumentnamen zu liefern.
Drei Identitäten vor der Wahl der Positionen
Bewahren Sie eine stabile fachliche Dokumentkennung samt Revisionsregeln auf. Berechnen Sie zusätzlich einen Hash über die exakten Quelldatei-Bytes und einen getrennten Hash über den extrahierten, normalisierten Text in einer festgelegten Kodierung. Halten Sie Parser-Paket, Konfiguration und gegebenenfalls Modellrevisionen sowie die Kennung des Normalisierungsprofils fest. Der folgende Test nutzt bewusst einen einfachen Klartextadapter und keinen PDF-Parser.
Der Quellhash erkennt ein verändertes Artefakt auch dann, wenn der extrahierte Text identisch bleibt. Der Texthash erkennt Änderungen durch die Extraktion. Das Profil beschreibt das Verfahren, das diese Bytes erzeugt hat. Die Felder ergänzen sich: Ein Hash ohne geschütztes Manifest authentifiziert den Lieferanten des Dokuments nicht. Ein übereinstimmender Hash erteilt keine Zugriffsberechtigung.
Zuerst müssen Sie die fachliche Gültigkeit bestimmen. Der Workflow zur Revisionsauflösung entscheidet, welches Handbuch zur Anlage passt. Danach beantwortet der Zitatanker die engere Frage: Wählt dieser Verweis in genau dieser Darstellung weiterhin die gespeicherte Passage aus? Übertragen Sie historische Zitate nicht allein wegen eines identischen Titels auf das neueste Handbuch.
W3C-Semantik ohne erfundene W3C-Ablehnungsregel
Das Web Annotation Data Model definiert TextQuoteSelector mit exaktem Text sowie optionalem Präfix und Suffix. TextPositionSelector verwendet einen nullbasierten eingeschlossenen Anfang und ein ausgeschlossenes Ende. Die Auswahl beruht auf Unicode-Codepunkten in logischer Textreihenfolge, nicht auf kodierten Codeeinheiten. Zitat- und Positionsauswahl müssen denselben normalisierten Text verwenden. Vermeiden Sie Grenzen innerhalb eines Graphemclusters.
Die Spezifikation behandelt beispielsweise das Entfernen von Markup und das Auflösen von Zeichenreferenzen. Daraus ergibt sich keine vollständige Vorgabe für NFC, NFKC, Groß-/Kleinschreibungsangleichung oder Ihre Leerraumregeln. Legen Sie diese Anwendungsentscheidungen zusätzlich fest. Das Web Annotation Vocabulary liefert die Begriffe für Selektoren, nicht Ihr Hash-Manifest, Ihren Berechtigungsdienst oder Ihre Freigaberegeln für Belege.
Ein wesentlicher Unterschied betrifft Mehrdeutigkeit. Wenn Präfix, Zitat und Suffix mehrere Sequenzen treffen, sollen laut W3C alle Treffer als Auswahl behandelt werden: Die Spezifikation verwendet SHOULD. Unsere Anwendung für genau eine belegte Passage lehnt Mehrdeutigkeit stattdessen ab. Das ist eine bewusst strengere Anwendungsregel, keine angebliche W3C-Pflicht. Auch die geforderte Übereinstimmung von Zitat und Position ist unsere Integritätsregel. Bezeichnen Sie einen eigenen Begleitdatensatz nicht ohne implementierte und getestete Serialisierung als vollständige interoperable JSON-LD-Annotation.
Normalisierung festschreiben, Original erhalten
Unicode Standard Annex #15 unterscheidet kanonische Äquivalenz von Kompatibilitätsäquivalenz. NFC setzt kanonisch äquivalente Sequenzen nach Möglichkeit zusammen. NFKC wendet zusätzlich Kompatibilitätsabbildungen an; aus einer Ligatur können mehrere Buchstaben werden. Keine Form ist eine universelle Lösung für die Belegsicherung. Bewahren Sie die Quelle auf und dokumentieren Sie jede Transformation.
Unser Profil dekodiert UTF-8 strikt, ersetzt CRLF durch LF und wendet anschließend NFC an. Es entfernt keine Randzeichen, fasst Leerraum nicht zusammen, gleicht Groß-/Kleinschreibung nicht an, entfernt kein Markup und expandiert keine Kompatibilitätsligaturen. Die Unicode-Datenbank der Laufzeit ist im Profil festgehalten. Ein Parser, der Trennstriche am Zeilenende oder Seitenköpfe entfernt, benötigt zusätzliche ausdrückliche Regeln und Migrationstests.
Addieren Sie eine normalisierte Textposition nicht direkt zu einer Position in der Rohquelle. Zusammensetzung und Expansion verändern Längen; Umordnung und Extraktion können Zuordnungen weiter verschieben. Wenn Sie Originalseiten markieren müssen, erhalten Sie eine entsprechende Zuordnung. Bei PDFs identifizieren Textpositionen allein keine Seitenrechtecke. Der Vertrag für PDF-Belege erläutert, warum Zell-, Kopfzeilen- und Seitenprovenienz getrennt erhalten bleiben müssen.
Ausgeführter Test: drei Koordinaten für eine Überschrift
Ein lokaler synthetischer Test wurde mit Python 3.14.9 und dessen Unicode-Datenbank 16.0.0 ausgeführt. Die Eingabe beginnt mit einem Werkzeug-Emoji außerhalb der BMP, einem Leerzeichen, zerlegt geschriebenem Müller, CRLF und der Überschrift Prüfung. Später wiederholt sie Prüfung und enthält Office mit dem einzelnen Ligaturzeichen ffi. Das sind Testzeichenfolgen, keine Betriebsanweisungen oder Kundendaten.
Nach CRLF-zu-LF und NFC belegt das erste Prüfung den halboffenen Codepunktbereich [9, 16). Sein Anfang liegt bei UTF-8-Byteposition 13 und UTF-16-Codeeinheitenposition 10. Die sichtbare Überschrift bleibt gleich; die numerischen Koordinaten sind nicht austauschbar. NFC erhält ffi. Eine getrennte NFKC-Assertion bestätigt die Expansion zu ffi. Weitere Assertions bestätigen die Zusammensetzung des Umlauts und das Entfernen der CR-Zeichen.
| Koordinatensystem | Anfang der Überschrift | Vertrag für Verbraucher |
|---|---|---|
| Unicode-Codepunkte | 9 | Normalisierter Bereich [9, 16) |
| UTF-8-Bytes | 13 | Keine Codepunktposition |
| UTF-16-Codeeinheiten | 10 | Viewer-Konvertierung erforderlich |
Der gespeicherte Anker enthält SHA-256 der Rohquelle, SHA-256 des normalisierten Textes, den Parser plain-text-fixture-v1, das Profil utf8-strict;crlf-to-lf;NFC;unicode-16.0.0, Anfang 9, Ende 16, das exakte Zitat Prüfung, das Präfix Müller mit anschließendem LF und das Suffix LF gefolgt von A:. Im Test ist der Datensatz eine eingefrorene Python-Dataclass. Unveränderlichkeit im Produktivbetrieb erfordert zusätzlich kontrollierte Speicherung und Versionierung; ein eingefrorenes Objekt ist keine Sicherheitsgrenze.
Der Resolver prüft zuerst die eingespeiste Zugriffsentscheidung, danach Quellhash, Parser/Profil und Texthash. Er ermittelt sämtliche Kandidaten für exaktes Zitat plus Kontext. Null oder mehrere Kandidaten werden abgelehnt. Der eindeutige Kandidat muss mit der gespeicherten halboffenen Position übereinstimmen. Der Resolver repariert keinen Anker durch stillschweigende Auswahl des ersten Vorkommens. Eine ausdrücklich autorisierte Migration darf einen neu geprüften Anker erzeugen und muss den alten Datensatz erhalten.
Auflösungszustände gehören zum API-Vertrag
| Zustand | Bedeutung | Reaktion |
|---|---|---|
| DENIED | Aktueller Zugriff verweigert | Keine geschützten Belege ausgeben |
| REVISION_MISMATCH | Rohbytes verändert | Freigegebene Revision gezielt auflösen |
| PROFILE_MISMATCH | Parser oder Normalisierung verändert | Migration versionieren und prüfen |
| EXTRACTION_MISMATCH | Hash des normalisierten Textes abweichend | Darstellung ablehnen |
| QUOTE_NOT_FOUND | Zitat mit Kontext fehlt | Zitat unaufgelöst zurückgeben |
| AMBIGUOUS | Mehrere Kontexttreffer | Nach Einzelstellenregel ablehnen |
| POSITION_MISMATCH | Position widerspricht Zitat | Ablehnen; Koordinatenadapter prüfen |
| RESOLVED | Identität, Zitat und Bereich stimmen | Inhaltliche Unterstützung getrennt prüfen |
Der ausgeführte Test lieferte RESOLVED für den unveränderten Anker. Neun gezielte Änderungen wurden abgelehnt: entzogener Zugriff, veränderte Quellbytes, anderer Parser, anderes Normalisierungsprofil, veränderter extrahierter Text, entfernter unterscheidender Kontext, verändertes Zitat, Bytepositionen und UTF-16-Positionen. Das sind deterministische Mutationstests, keine gemessene Zitatgenauigkeit im Produktivbetrieb. Die Zugriffsentscheidung ist ein eingespeister boolescher Wert; sie prüft weder einen Identitätsanbieter noch eine reale Policy-Engine.
Die Mutation mit wiederholter Überschrift entfernt Präfix und Suffix, behält aber die ursprüngliche Position. Unsere Regel liefert trotzdem AMBIGUOUS: Eine Position setzt einen Zitatselektor ohne die geforderte Eindeutigkeit nicht außer Kraft. Eine andere Anwendung kann eine andere dokumentierte Regel wählen. Das Verhalten darf jedoch nicht zufällig wechseln, sobald Positionen nicht mehr passen.
Backend und Viewer ausdrücklich verbinden
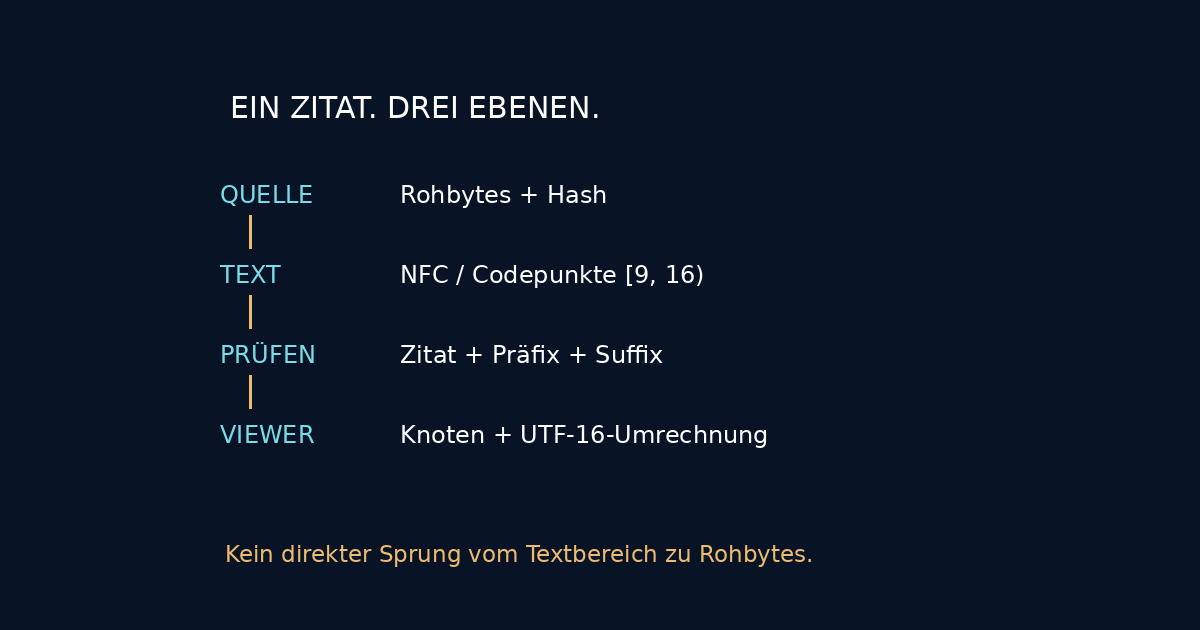
Geben Sie aus dem Resolver eine Darstellungskennung, die Bezeichnung des Koordinatensystems und den geprüften Bereich zurück – nicht nur zwei unbenannte Ganzzahlen. Ein Browseradapter muss Codepunktpositionen in die tatsächlich verwendeten Textknotengrenzen und UTF-16-Positionen übersetzen. Prüfen Sie nach dem Aufbau des Bereichs erneut die exakte Zeichenfolge. Eine Codepunktposition in einer zusammengefügten Zeichenfolge ist nicht automatisch eine DOM-Range-Position innerhalb eines einzelnen Knotens.
Das Diagramm trennt diese Ebenen. Der lokale Test führt keinen DOM-Range-Adapter, keine PDF-Markierung, kein OCR-Modell und keinen Test bidirektionaler Darstellung aus. Ergänzen Sie vor der Produktionsfreigabe Tests für mehrere Textknoten, kombinierende Sequenzen, Emoji-Sequenzen, geschützte Leerzeichen, Ligaturen, wiederholte Kopfzeilen und parserabhängige Lesereihenfolgen. Prüfen Sie Auswahlgrenzen ebenso wie Textgleichheit. Ein korrekter Backend-Anker kann im Viewer falsch markiert werden, wenn dort eine andere Extraktion verwendet wird.
Verankern Sie eine übersetzte Paraphrase nicht als vermeintliches exaktes Zitat aus einer englischen Quelle. Speichern Sie die Passage in der Quellsprache und kennzeichnen Sie die Übersetzung als abgeleitete Darstellung. Die Evaluation sprachübergreifender Suche prüft, ob deutsche Fragen den gültigen englischen Beleg finden. Die Ankerprüfung kontrolliert danach die ausgewählte wörtliche Passage. Beide ersetzen keine Prüfung der inhaltlichen Unterstützung einer Antwort.
Betriebsaufwand und Sicherheitsgrenzen
Das vollständige Hashen eines Dokuments bei jedem Klick kann unnötige Arbeit erzeugen. Berechnen Sie bei der Aufnahme unveränderliche, inhaltsadressierte Manifeste und schützen Sie deren Herkunft. Prüfen Sie bei der Auflösung die erwartete Objekt- und Manifestrevision. Cachen Sie nur innerhalb des passenden Mandanten- und Berechtigungsbereichs. Ein Cachetreffer darf keine aktuelle Zugriffsentscheidung umgehen. Messen Sie Speicher-, Lookup- und Extraktionsaufwand, bevor Sie eine Cachelaufzeit wählen. Dieser Test enthält keinen Latenzbenchmark.
Exakte Zitate und Kontextausschnitte können vertrauliche Informationen enthalten. Wenden Sie auf Anker, Protokolle und Diagnoseartefakte quelläquivalente Zugriffsregeln und eine ausdrückliche Aufbewahrungsregel an. Bevorzugen Sie in Betriebsmetriken Fehlercodes und undurchsichtige Kennungen statt vollständiger abgelehnter Zitate. Eine Ablehnung darf weder den geschützten Inhalt noch das Vorkommen einer geheimen Formulierung verraten.
Strikte Ablehnung reduziert unbemerkte Fehlmarkierungen, erhöht aber nach legitimen Parser-Upgrades die Zahl unaufgelöster Zitate. Planen Sie versionierte Darstellungen, kontrollierte Migration und sichtbare Nichtverfügbarkeit ein. Eine tolerante Ähnlichkeitssuche wirkt bequem, kann das Zitat jedoch in einen anderen Warnhinweis oder eine andere Bedingung verschieben. Bieten Sie einen ausdrücklich bezeichneten Dokumentverweis ohne geprüfte Passage nur an, wenn Zugriff und Produktregeln das erlauben. Erfinden Sie keine verifizierte Markierung.
Abnahmecheckliste und nächster Schritt
Aufnahme: Erhalten Sie Originalbytes, Extraktionskonfiguration und normalisierten Text. Fixieren Sie die Unicode-Datenbank und hinterlegen Sie Quell- und Texthash in einem geschützten Manifest. Trennen Sie fachliche Gültigkeit von Extraktionsprovenienz.
Auflösung: Prüfen Sie den Zugriff erneut. Erzwingen Sie Revisions- und Profilidentität. Vergleichen Sie Zitat, Kontext und halboffene Positionen. Geben Sie ausdrückliche Fehlerzustände zurück. Ein leerer oder ungültiger Bereich ist ein Fehler, keine Aufforderung zur Auswahl des ersten Treffers.
Viewer: Benennen Sie die Koordinateneinheit. Konvertieren und testen Sie den dargestellten Bereich. Erhalten Sie die Verbindung zum Originalseitenbeleg. Prüfen Sie die Interaktion Ihres tatsächlichen Viewers auf Mobilgerät und Desktop. Ein bestandener Backend-Test ist keine Viewer-Abnahme.
Freigabe: Bewahren Sie ausgeführten Mutationstest und Laufzeitversionen auf. Ergänzen Sie repräsentative Dokumente und autorisierte Migrationstests. Bewerten Sie die inhaltliche Begründung von Antworten getrennt. Skript und Ergebnismanifest dieses Artikels werden als Veröffentlichungsnachweis aufbewahrt, nicht als bereits ausgerollte Produktfunktion dargestellt.
Wenn Ihre RAG-Antworten überzeugende Dokumente verlinken, Ihre Nutzer die zitierte Passage aber nicht reproduzieren können, beginnen Sie mit einer Handbuchfamilie und einigen strittigen Markierungen. Ich unterstütze Ihr Engineering-Team dabei, den Darstellungsvertrag festzulegen, Migrationstests aufzubauen und Fundstellenfehler von Retrieval- und Antwortqualitätsfehlern zu trennen. Das nützliche Ergebnis ist ein Resolver, der seine Ablehnung begründen kann – kein selbstsicherer wirkendes Quellenabzeichen.